浮点数、bfloat,以及比特如何决定模型的内存
神经网络存储学习得到的参数,包括权重和偏置。参数数量乘以每个参数的字节数,得到的是参数本身所需的内存。运行时还需要存储激活值、临时缓冲区,以及随任务而异的缓存或训练状态。
拿我们在 MNIST 那篇文章里训练的小网络为例——一个由两个 Keras Dense 层构成的稠密分类器:784 个展平的像素输入进入一个 128 神经元的隐藏层,再进入一个 10 神经元的输出层(每个数字一个)。
这种形状的简写是 784 → 128 → 10,其中 784 是输入大小,不是一层。参数量加起来是:
采用默认的 fp32 策略时,这些参数占用 407,080 字节,约为 407 KB 或 398 KiB。这不包括模型运行时使用的其他内存。
模型仓库通常包含介绍模型及其训练过程的模型卡。权重文件的元数据也可以提供参数数量和存储类型。
下面的截图展示了 PaddleOCR-VL-1.5 的 Hugging Face 侧栏,其中列出了经过取整的参数数量和张量类型:
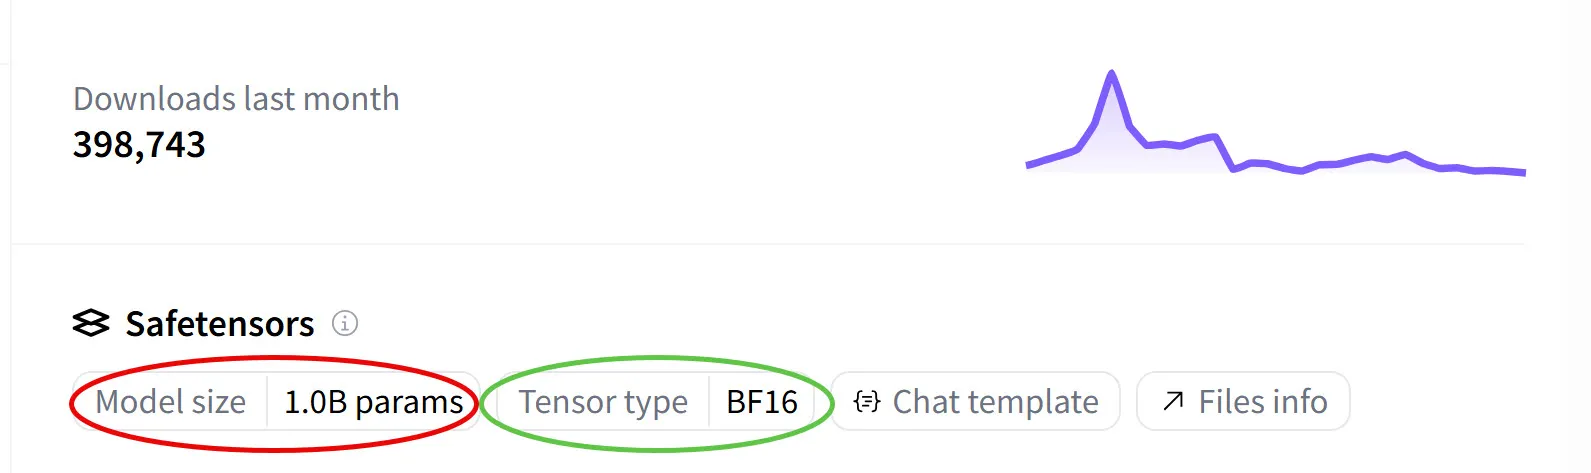
Model size 表示参数数量,Tensor type 表示存储使用的 dtype,即数据类型。张量的 dtype 描述元素的类型,例如 float32、int8 或 bfloat16;Python 的 type() 描述对象本身。
在代码中可以查看 .dtype,不同库的输出格式有所不同:
>>> import torch
>>> torch.tensor([0.5], dtype=torch.bfloat16).dtype
torch.bfloat16

>>> import numpy as np
>>> np.array([0.5], dtype=np.float16).dtype
dtype('float16')
Hugging Face 直接从 safetensors 文件读取同样的信息——safetensors 是 Hugging Face 用于保存和分发训练好权重的文件格式,每个张量的 dtype 都存在其元数据里,侧边栏显示的「Tensor type」就是它。
BF16 指 Google 开发的 16 位浮点格式 bfloat16。它也包含符号、指数和小数字段,但位数分配与 IEEE binary16 不同。一个检查点可能包含多种 dtype 的张量;需要精确计算内存时,应查看其元数据。
所以计算模型内存占用的步骤与我们对 MNIST 所做的完全相同,只是数字更大。1.0B 这个数是模型所有层参数之和——正是我们为 MNIST 手算的那种逐层算术,只不过 Hugging Face 已经替我们走遍 safetensors 文件里的每个张量并把元素数加了起来。
于是模型卡说有 10 亿参数(「B」是 billion,即 的简写)。乘以每个 bf16 权重 2 字节,我们得到模型的权重占用:
这里估算的只是权重存储。推理还需要激活值、工作区,有时还需要 KV 缓存;长序列或大批次下,缓存可能占用大量内存。训练还需要梯度、优化器状态和保存的激活值。
70 亿参数模型的权重约占 28 GB(fp32)、14 GB(fp16/bf16)或 7 GB(int8,不含量化元数据)。700 亿参数模型的 fp16 权重约需 140 GB。模型能否装入某个设备,还取决于其他内存需求。
降低精度可以减少权重存储:fp16 和 bf16 使用的字节数是 fp32 的一半,8 位或 4 位量化可以进一步压缩。质量和速度取决于模型、转换方法与硬件,需要通过测量确认。
网络里并非每个数字都是权重
运行中的网络使用多种张量。反向传播文章解释了参数、激活值和梯度的来源。
推理和训练都需要权重与激活值。推理时,中间张量不再被后续操作使用后便可释放,但残差连接和工作区可能要求同时保留多个张量。训练通常保存激活值供反向传播使用;激活检查点可以通过重新计算来节省部分内存。激活值不一定与权重使用相同的 dtype。
推理时,基于 Transformer 的 LLM 还会带一份 KV 缓存——自回归生成过程中缓存下来的历史 token 的键和值,这样注意力就不必为每个新 token 重算它们。为了在长上下文中省内存,常保持在 fp16 或 fp8。
训练期间,还有两个类别需要考虑:
- 梯度描述损失对各个参数的变化率。其数量级可能相差很大,因此格式的数值范围很重要。
- 优化器状态取决于算法。Adam 为每个参数保存两项持续更新的统计量;它们的 dtype 由实现和精度策略决定。
在代码里,dtype 出现在几个特定的地方。 下面是我们训练 MNIST 那篇文章里的相关片段:
# Input data — explicitly cast to float32
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0

# Model — Dense layers default to fp32 for weights and biases (no dtype= passed)
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,)),
    keras.layers.Dense(10, activation="softmax"),
])

# Optimizer — owns its own state, allocated separately
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)
.astype("float32") 设置输入数组的 dtype。Keras 层有各自的变量类型和计算类型,分别决定参数存储和运算所用的格式。这里默认策略对两者都使用 fp32,也可以为每一层设置其他策略:
# Same architecture, but weights and biases stored in bf16
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,), dtype="bfloat16"),
    keras.layers.Dense(10, activation="softmax", dtype="bfloat16"),
])
# PyTorch equivalent — nn.Linear takes the dtype directly
model = nn.Sequential(
nn.Linear(784, 128, dtype=torch.bfloat16),
nn.ReLU(),
nn.Linear(128, 10, dtype=torch.bfloat16),
)在 Keras 中,dtype="bfloat16" 同时设置变量类型和计算类型。"mixed_bfloat16" 这样的混合精度策略则保留 fp32 变量,并使用 bf16 计算。在 PyTorch 中,构造函数设置参数的存储类型;输入和操作需要与之兼容,或由 autocast 处理。梯度和优化器状态的类型也取决于具体实现。
混合精度为不同操作或存储用途使用不同数值格式。除非另有说明,本文中的“bf16 模型”指权重的存储格式。
一种混合精度 Adam 配置在不计激活值时,需要每个参数 16 字节:
- bf16 权重:2 字节
- bf16 梯度:2 字节(与权重同形状)
- fp32 Adam 一阶和二阶矩:8 字节(两个矩估计 × 各 4 字节)
- fp32 主权重副本(由优化器保留以保证更新稳定):4 字节
在这些假设下,训练中与参数有关的存储是 bf16 权重存储的八倍。这只是一个计算示例,并非固定要求:主权重副本、梯度类型、优化器变体和分片都会改变总量。激活值还会增加随工作负载而异的开销。
对于 70 亿参数,这种配置需要约 112 GB,再加上激活值和缓冲区;单独存储 bf16 权重则约需 14 GB。完整训练可通过分片或卸载减少设备内存占用;适配器微调只训练部分参数,因此需要另一种计算方式。
Python 和 JavaScript 的默认浮点格式
在看 ML 实际使用的数值格式之前,先从我们每天在 Python 和 JavaScript 里用的熟悉数字类型说起会有帮助:
| 语言 | 种类 | 类型 | 说明 |
|---|---|---|---|
| Python | 整数(无小数,精确) | int | 任意精度。CPython 按需扩展底层存储,所以 2**1000 就能直接工作,且结果精确。 |
| 浮点(64 位 IEEE-754 双精度) | float | 正是我们要在文章余下部分拆解的那种格式。数值本身占 8 字节,Python 对象还需要额外存储。 | |
| JavaScript | 整数(无小数,精确) | BigInt | 任意精度整数,作为独立类型后来才加入。写法带 n 后缀(例如 5n)。最接近 Python int 的等价物。 |
| 浮点(64 位 IEEE-754 双精度) | Number | 与 Python 的 float 是同一种格式。JavaScript 用它同时表示整数和小数;默认没有单独的整数类型。 |
常见 CPython 构建中的 float 和 JavaScript 的 Number 使用 IEEE binary64,因此它们对 0.1 的表示相同,也都会得到 0.1 + 0.2 = 0.30000000000000004。但语言层面的行为仍有差别:Python 除以零会抛出异常,JavaScript 则可能返回无穷大。对象存储也有超出八字节数值本身的开销。
这 64 位如何划分为符号、指数和尾数,为什么指数以偏移而非补码存储,以及 0.1 如何舍入——这些机制我在本系列前面的文章里详细讲过。那里的一切都直接适用于这两种语言,因为底层是同一种 64 位格式。
普通浮点字面量使用这些默认格式。显式数组和张量可以采用其他存储格式;JavaScript 也提供 Float32Array。机器学习框架还提供 bf16 和低位数量化表示等格式。
转换如何丢比特:从语言浮点到 ML 的 dtype
每当一个值从一种数值格式转到另一种——Python 的 float 到 int,float 到 int8,fp64 到 fp16——都有可能装不下这些比特。总得有东西让步,而丢失的比特去了哪里,取决于源格式和目标格式。
最简单的情况是 float → int:把小数点之后的一切都丢掉。
>>> int(3.7)
3
>>> int(-3.7)
-3               # truncates toward zero — drops the fractional bits
>>> import math
>>> math.floor(-3.7)
-4               # floor rounds toward -infinity instead
可以把截断理解为还原二进制数值后丢弃小数部分。实际使用的转换指令取决于实现。
举个例子,取 5.75。二进制是 101.11——小数点前三位(101 = 4 + 1 = 5),小数点后两位(.11 = 0.5 + 0.25 = 0.75)。不过 IEEE-754 并不这样存储;它把数字规格化,让小数点前恰好只有一个 1,并把移位量记在指数里:
   101.11   →   1.0111 × 2^2
   ^^^ ^^       ^ ^^^^   ^
   │   │        │ │      └── exponent: how far to shift the radix back
   │   │        │ └───────── mantissa (fractional part of the 1.xxx form)
   │   │        └─────────── the implicit leading 1 (not stored)
   │   └──────────────────── original fractional bits
   └──────────────────────── original integer bits
存储的小数字段以 0111 开头,无偏指数为 2。补回隐含的前导 1 并移动二进制小数点,就能理解整数转换:
   mantissa:    1.0111
   shift by 2:  101.11
                ^^^ ^^
                │   └── fractional bits → discarded
                └────── integer bits    → 101 = 5
丢弃 .11 就去掉了 0.75,因此 int(5.75) 返回 5。这是向零舍入,也称截断,并不是舍入到最近的整数。所以 int(-3.7) 返回 -3。
转换为更窄的 dtype 可能发生截断、舍入、溢出,也可能报错。API 的选择很重要:构造函数可能拒绝超出范围的整数,而转换已有张量时可能发生回绕。
>>> torch.tensor([3.7, -3.7], dtype=torch.int8)       # float → int, truncates toward zero
tensor([3, -3], dtype=torch.int8)                     # → fractional bits dropped on each element

>>> torch.tensor([1000, 1001], dtype=torch.int64).to(torch.int8)      # int → int8, overflows (int8 max is 127)
tensor([-24, -23], dtype=torch.int8)                  # → low 8 bits kept, neighbours wrap together

>>> torch.tensor([1e5, -1e10], dtype=torch.float16)   # fp64 → fp16, overflows (fp16 max is ~65504)
tensor([inf, -inf], dtype=torch.float16)              # → saturate to ±inf; magnitudes are lost

>>> torch.tensor([2**24 + 1, 2**24 + 2], dtype=torch.float32)  # int → fp32, exceeds mantissa precision
tensor([16777216., 16777218.], dtype=torch.float32)            # → +1 rounds away (24-bit mantissa); +2 is exact
这些示例展示了四种转换结果:
| 模式 | 从 | 到 | 例子 | 结果 |
|---|---|---|---|---|
| 截断 | float | int | 3.7 → int8 | 3 |
| 回绕 | int | 更窄的 int | 1000 → int8 | -24 |
| 饱和到无穷 | float | 更窄的 float | 1e5 → fp16 | inf |
| 精度损失 | int | float | 2^24 + 1 → fp32 | 2^24 |
回绕:将已有整数张量转换为 int8 时,会保留最低八位。因此,1000 在二进制补码下变成 -24。这不意味着所有构造函数都接受超出范围的输入。
浮点溢出:按最近值舍入时,1e5 转换为 fp16 会得到 inf,因为 fp16 的最大有限值为 65,504。其他舍入模式可能产生不同的溢出结果。
精度损失。 2^24 + 1 → fp32 变成 2^24。fp32 的尾数是 24 位(23 位显式 + 1 位隐含),所以从 0 到 2^24(16,777,216)的每个整数都能精确表示,但超过之后,可表示值之间的间距每经过一个 2 的幂就翻倍。整数 2^24 + 1 落在两个可表示的 fp32 值之间,被舍入到较近的那个(2^24,因为 +1 恰好在正中间,而中点情况向偶数舍入)。这与 fp64 从 2^53 ≈ 9 × 10^15 开始丢失整数精度是同一个故事——JavaScript 的 Number.MAX_SAFE_INTEGER 正好是 2^53 − 1。
转换行为取决于数值、源格式、目标格式、舍入模式和 API,需要综合考虑。
走出语言的默认设定
ML 生态提供的菜单比 Python 或 JavaScript 原生所提供的宽得多。每个主流数值框架——NumPy、PyTorch、JAX 和 TensorFlow——都允许你显式选择 dtype。下面是同一操作在四个框架里的写法:
import torch
x = torch.tensor([0.5])                        # fp32 by default — 4 bytes
y = torch.tensor([0.5], dtype=torch.float16)   # fp16 — 2 bytes
z = torch.tensor([0.5], dtype=torch.bfloat16)  # bf16 — 2 bytes
w = torch.tensor([0.5], dtype=torch.float64)   # fp64 — 8 bytes, same as Python float
import tensorflow as tf
x = tf.constant([0.5]) # fp32 by default — 4 bytes
y = tf.constant([0.5], dtype=tf.float16) # fp16 — 2 bytes
z = tf.constant([0.5], dtype=tf.bfloat16) # bf16 — 2 bytes
w = tf.constant([0.5], dtype=tf.float64) # fp64 — 8 bytesimport numpy as np
x = np.array([0.5], dtype=np.float32) # 4 bytes per element
y = np.array([0.5], dtype=np.float16) # 2 bytes
# NumPy core has no bfloat16 — you need the `ml_dtypes` package, or JAX/TF/Torch arraysimport jax.numpy as jnp
x = jnp.array([0.5], dtype=jnp.bfloat16) # bf16 — 2 bytes这些构造函数允许选择元素的 dtype。NumPy 核心类型中不包含 bf16,但扩展可以提供它。PyTorch、JAX 和 TensorFlow 提供 bf16,不过操作支持情况取决于设备和后端。
就 Python 而言,字面量 0.5 仍然是 64 位双精度——转换发生在构造张量的时候。在内部,每个元素依 dtype 占 8、4、2 或 2 字节。到 fp8 就是 1 字节;到 int4 则是半个字节。
要看清这些字节究竟编码了什么——以及为什么把它们减半并不会简单地把可表示范围也减半——我们得看看底层的格式。
机器学习中的浮点格式
现代 ML 使用少数几种浮点格式,它们全都共享继承自 IEEE-754 的同一种三字段布局:
- 符号(1 位)——正或负。
- 指数——小数点要移动多远,以偏移二进制存储。
- 尾数(有效数字)——数字在规格化科学计数形式下的前导数位,隐含的前导
1被省略。
对于正规数,指数决定数量级,有效数决定精度。特殊编码用于表示零、无穷大、NaN 和次正规数,但支持情况有所不同:部分 fp8 变体没有无穷大,一些硬件会把次正规数清零。
| 格式 | 总位数 | 符号 | 指数 | 尾数 | 字节/参数 |
|---|---|---|---|---|---|
| fp64 (IEEE-754 double) | 64 | 1 | 11 | 52 | 8 |
| fp32 (IEEE-754 single) | 32 | 1 | 8 | 23 | 4 |
| bf16 (Brain Float 16) | 16 | 1 | 8 | 7 | 2 |
| fp16 (IEEE-754 binary16) | 16 | 1 | 5 | 10 | 2 |
这两种 16 位格式以不同方式分配相同的位数。把小数字段中的一位移给指数,会使给定正规指数下的间距加倍,并大幅扩展指数范围;最大值并不只是增加一倍。
[1, 4) (128 per octave; gap doubles at 2)对于有 位小数字段的正规数, 内的间距为 , 内的间距则是它的两倍。bf16 的最大值约为 ,在 1 附近间距约为 0.008;fp16 的最大值为 65,504,在 1 附近间距约为 0.001。
组件底部的条带让间隔可见:选中 bf16 时,你能看到分散在 [1, 2] 上的一根根刻度——那些间隔就是该格式在单位尺度上的精度边界。切到 fp16,刻度融成一条实线,因为间距已降到亚像素。网格依然是离散的;只是密到你再也看不出离散性——而这正是这里「更高精度」的含义。
条带还延伸到下一个二倍区间 [2, 4)(越过 2 处的虚线标记),以便说明这种间隔翻倍并非 [1, 2) 区间独有——同样数量的刻度(每个尾数状态一根)被摊到宽度两倍的区间上,所以右半边的视觉间距是左半边的两倍。把滑块拖到低尾数设置(例如 M=4),翻倍就变得一目了然。
为了具体起见,下面是每个预设在 [1, 2] 中最初几个可表示的值:
| bf16(128 个值,间隔 = 1/128) | fp16(1,024 个值,间隔 = 1/1024) |
|---|---|
1.0 | 1.0 |
1.0078125 | 1.0009765625 |
1.015625 | 1.001953125 |
1.0234375 | 1.0029296875 |
1.03125 | 1.00390625 |
| … | … |
1.9921875 | 1.9990234375 |
(2.0) | (2.0) |
bf16 的每个后继值都恰好落在 fp16 的每第 8 个值上——在这个二倍区间里,bf16 的网格是 fp16 网格的严格子集,只是每八根刻度去掉了七根。这个比值恰好是 (fp16 有 10 位尾数,bf16 有 7 位)——每多一位尾数,每个二倍区间内可表示值的数量就翻倍。
每个正规区间 内的间距相同。进入下一个区间时,间距加倍;趋近零时,间距逐渐减小,直到间距固定的次正规区域。
下面是 bf16 在几个二倍区间上的情况:
| bf16 二倍区间 | 间隔 |
|---|---|
[1, 2) | 1/128 ≈ 0.0078 |
[2, 4) | 2/128 = 1/64 ≈ 0.0156 |
[4, 8) | 4/128 = 1/32 ≈ 0.0313 |
| … | … |
[1024, 2048) | 1024/128 = 8 |
bf16 的指数范围更宽,fp16 在可比的正规数量级下精度更高。过大的数值可能溢出,过小的数值可能损失精度或下溢为零。两种格式都有用途,具体取决于任务和硬件。
bf16 的比特为什么这样划分
Google 为机器学习开发 bf16 时,保留了 fp32 的八位指数,并把存储的小数字段从 23 位缩减为七位。因此,它的指数范围接近 fp32,但精度明显较低。
在相同的正规指数下,bf16 的间距是 fp32 的 倍。下面展示 1.005 在三种格式中的舍入结果:
| 格式 | 存储的值 | 误差 |
|---|---|---|
| fp32 | 1.005(实际上精确) | ~10⁻⁸ |
| fp16 | 1.0048828125 | ~1.2 × 10⁻⁴ |
| bf16 | 1.0078125 | ~2.8 × 10⁻³ |
对于 1.005,fp16 更精确。对于小数值,1e-7 可以近似表示为非零的 fp16 次正规数,舍入后约为 1.192e-7。按最近值舍入时,1e-8 则会变成零,而 bf16 仍能表示接近它的值。
溢出、下溢和舍入误差都可能影响训练。溢出可能传播无穷大或 NaN,下溢可能抹去小梯度。反复舍入还可能使微小更新无法改变低精度权重。仅有更宽的数值范围并不能保证训练稳定。
损失缩放在反向传播前放大损失,在优化器更新前再还原梯度尺度,帮助 fp16 保留小梯度。动态缩放还会根据溢出情况调整尺度。PyTorch 提供 torch.amp.GradScaler("cuda")。bf16 的范围更宽,因此通常不需要损失缩放。
每一种位宽上的同一个取舍
fp32 转换为 bf16 比较简单,但不一定只是移位:Cloud TPU 采用最近值舍入,中点取偶数,并将 bf16 次正规数清零。bf16 转回 fp32 是精确的,但无法恢复已经丢失的位。
如果任务需要额外三位小数字段,或硬件支持更适合 fp16,它仍然有用。bf16 往往便于训练,但两者都不是对方的通用替代品。
格式的硬件支持
原生低精度运算可以提高吞吐量;即使计算使用更宽的 dtype,紧凑存储也可能减少内存传输。实际速度取决于内核和工作负载。
硬件支持的例子包括:
| 格式 | 在哪里原生运行 |
|---|---|
| fp64 / fp32 | CPU 和 GPU 广泛支持;吞吐量取决于设备。 |
| fp16 | NVIDIA 张量核心,自 Volta(V100,2017)起;其他厂商随后跟进。 |
| int8 | 支持实例包括 NVIDIA Turing 张量核心(T4,2018)。 |
| bf16 | Google TPU v2(2017)、NVIDIA Ampere(A100,2020)、Intel AVX-512 BF16、Arm Armv8.6-A BF16。 |
| fp8 (E4M3, E5M2) | NVIDIA Hopper(H100,2022)、AMD CDNA 3(MI300)、Intel Gaudi 2/3。 |
| int4 | NVIDIA Turing 张量核心引入了 int4 模式;支持情况取决于代际和 API。 |
Tensor Cores 和 TPU MXU 等矩阵单元可加速成组的乘加运算。操作数精度、累加精度和舍入行为取决于指令;矩阵运算不一定具有与单个标量 FMA 相同的舍入语义。
更低位数的存储会减小张量大小。要加快执行,还需要合适的内核、硬件和足够的计算量。转换成本或其他瓶颈可能抵消算术运算的收益。
应分别检查检查点格式,以及运行时对设备的支持。例如,打包的 int4 权重可以先反量化,再进行浮点计算,不要求原生 int4 矩阵指令。应对受支持的执行路径进行测试,而不是根据 dtype 名称推断速度。
展望:fp8
两种常见 fp8 变体以不同方式分配八个位:
| 格式 | 符号 | 指数 | 尾数 | 用于 |
|---|---|---|---|---|
| fp8 E4M3 | 1 | 4 | 3 | 前向传播的权重与激活(偏向精度) |
| fp8 E5M2 | 1 | 5 | 2 | 梯度(偏向范围) |
论文 FP8 Formats for Deep Learning 介绍了 E4M3、E5M2 及其在混合精度训练中的用途。
一种常见方案在前向传播中使用 E4M3,在梯度中使用 E5M2。缩放因子将张量值映射到可用范围。下面的示例为整个张量使用一个尺度;其他方案可能使用更小的块或不同的缩放策略。
import torch

w_fp32 = torch.randn(1024, 1024, dtype=torch.float32) * 0.1

# Per-tensor scale: |max| / fp8_max maps the tensor's range into fp8's
FP8_E4M3_MAX = 448.0
scale = (w_fp32.abs().max() / FP8_E4M3_MAX).clamp_min(torch.finfo(torch.float32).tiny)

# Quantize: divide by scale, then cast to fp8
w_fp8 = (w_fp32 / scale).to(torch.float8_e4m3fn)

# Reconstruct on read: cast back, multiply by scale
w_back = w_fp8.to(torch.float32) * scale
NVIDIA Transformer Engine 等库提供管理缩放和高精度状态的 fp8 方案。仅把张量存为 torch.float8_e4m3fn 并不等于实现了这种训练方案。
用滑块调整张量的最大绝对值。绿色刻度表示应用尺度后的 fp8 可表示值,蓝点表示示例数据。它演示的是缩放,而不是完整的训练或推理实现。
为什么模型能容忍更少的比特
许多网络可以容忍一定的舍入误差,但个别权重和通道仍可能敏感。量化质量取决于误差分布、离群值、累加方式和任务。多个值组合时,误差不一定相互抵消。
以下研究在特定评估条件下展示了低精度方法的效果。它们不保证每个模型都能保持质量,也不证明模型越大就一定越能容忍更少的位数。
Deep Compression结合剪枝、量化和编码来压缩包括 AlexNet 在内的网络。Mixed Precision Training展示了使用 fp16 算术与 fp32 主权重训练,并在实验中保持准确率的方法。
对于 LLM,LLM.int8()将 int8 矩阵乘法与离群值的高精度处理结合起来,GPTQ则针对低位数权重量化。QLoRA冻结量化后的基础模型并训练适配器。BitNet b1.58采用三值权重进行训练;它不意味着任意预训练模型都能无损转换为三个权重值。
量化是同一个想法,被推得更远
这里关注均匀整数量化:每个权重用一个小整数和共享尺度表示,有时还需要零点。NF4 等其他方案使用非均匀量化级别。
在进入机制之前,先看看量化能带来哪些收益:
- 内存:不计元数据时,int8 和打包 int4 权重分别是 fp32 大小的四分之一和八分之一。
- 速度:减少内存传输和使用合适的低精度内核可能提速,但也要考虑转换与内核开销。
- 部署:部分加速器要求整数模型,其他设备则支持多种格式。
- 能耗:减少数据搬运和降低运算精度可能降低能耗,具体取决于硬件和工作负载。
真正做量化有两条流程,取决于你在模型生命周期的哪个阶段做。它们共享同一套「吸附到网格」的算术,我们会在下一小节展开。
训练后量化(PTQ)在不重新训练参数的情况下转换已训练模型。部分方法需要校准数据和大量计算,例如 GPTQ 与 AWQ。不同库和运行时支持的算法与检查点格式不同,需要检查兼容性。
量化感知训练(QAT)在训练时模拟量化,让参数适应其误差。它需要训练或微调流程,但不一定需要带标签的数据:LLM-QAT 使用蒸馏。它能否优于 PTQ,取决于模型、位宽和评估。
更低的位宽通常会限制表示精度。应在模型需要完成的任务上评估压缩结果;仅有内存节省并不能说明质量可接受。
「吸附并缩放」配方
在这个对称整数量化示例中,每个权重存储一个整数,每组权重共享一个尺度。int8 使用 -127 到 127 的索引,共 255 个级别。对应的对称 int4 范围是 -7 到 7,共 15 个级别;其他方案可以使用全部 256 或 16 种位模式。
反量化通过 index × S 近似恢复权重。有些内核将这一步融合进矩阵乘法,其他实现则先生成更宽类型的张量。恢复值所用的 dtype 也可能不同。
考虑下面这组五个权重:
这个过程有两步,下面的组件让你可以逐步点击。宏观来看:首先,我们为整组计算一个缩放因子 ——它给出所有权重将要吸附到的网格。然后,对每个权重执行真正的压缩——吸附到最近的网格点(中点情况用就近取偶)并存下整数索引。第 1 步每组跑一次;第 2 步每个权重跑一次。
要定义这个离散集合,先看这组权重的取值范围,并从数据中算出缩放因子 。下面是对称 比特量化的通用公式:
分母是 ——对称 比特有符号整数中绝对值最大的索引。int8 是 ;int4 是 ;int2 是 。
分子是该组中绝对值最大的权重:,其中 是你一起量化的那 个权重。
所以这个设计就是:用绝对值最大的权重除以绝对值最大的索引。这保证了最极端的权重恰好映射到网格点 ——不截断,网格利用充分。
对上面五个示例权重与 int8(,因此分母 = ):
注意 同时扮演两个角色:它是乘数(索引 × S 恢复出 fp32 值),也是网格间距(相邻索引相差 1,因此相邻网格位置正好相差 )。例如索引 41 解码为 41 × 0.0748 ≈ 3.067,索引 42 解码为 42 × 0.0748 ≈ 3.142——它们之间的间隔正是 0.0748,也就是 。同一个数,两种含义。
有了 ,网格便直接随之而来:每个网格点都是 索引 × S,索引取从 -127 到 +127 的整数:
代入我们的 ——每个网格点是 索引 × 0.0748:
要把每个权重吸附到最近的网格点上,请记得第 1 步只是建好了网格;真正的逐权重压缩发生在这里。对组内每个权重 ,计算它的索引:
这给出最近网格点的整数索引——与二进制舍入那篇文章里的就近舍入机制相同:挑最近的可表示值,中点情况取偶。唯一的区别是可表示值的集合如今小得多,而且是显式枚举出来的。存下这个 1 字节整数(int4 则是 4 位);共享的 随行同存,每组只存一次,因此它的成本会被摊到组内每个权重上。对我们五个权重、:
| 权重 | 存储(int8 值) | ||
|---|---|---|---|
3.1416 | 42.0 | 42 | 42 |
-1.7 | -22.7 | -23 | -23 |
0.0234 | 0.31 | 0 | 0 |
1.5 | 20.05 | 20 | 20 |
-9.5 | -127.0 | -127 | -127 |
五个 fp32 权重(20 字节)变成五个 int8 值加一个 fp32 缩放因子(共 9 字节)——小了 2.2 倍,而且组越大,节省越多。
挑一个权重,看看在上述公式所用的同样五个值上,完整的「量化—吸附—反量化」循环。绿色刻度是 int8 网格(对 −127 到 +127 的每个索引取 索引 × S)。蓝色圆点是原始 fp32 权重;红色标记是它吸附到的网格点。流程行展示第 1 步和第 2 步的算术:除以 ,就近舍入到整数(这才是被存下来的东西),读取时再乘回 。于是 3.1416 / 0.0748 ≈ 42.0 舍入为 42,重建为 42 × 0.0748 ≈ 3.142——几乎一致。试试 0.0234,看看一个极小的权重下溢到网格点 0 时会发生什么。
要重建一个权重,硬件读出那个小整数并施加逆运算:
其中 是存储的整数, 是浮点缩放因子。不同的权重组拿到不同的 ——这就是为什么同一个 int8 值 42 在两个不同的通道里可以解码出两个不同的实数。
概念上,恢复过程将整数转换为浮点值,再乘以尺度。实现可以融合这些操作,并使用 fp16、bf16 或 fp32。
不发生截断时,忽略尺度计算中的有限精度误差,舍入到最近网格点造成的变化最多为 。绝对值小于 的数会舍入为零。这只限制单个数值的误差,并不限制模型预测的变化。
它实际在哪里运行
实践中,真实部署会沿这套算术走两条路径之一:
- 整数矩阵乘法:量化权重和激活值,累加整数乘积,再应用相应的尺度并转换输出。
- 仅权重量化:激活值保持浮点格式,在计算时恢复权重,通常在融合内核中完成。
具体过程取决于粒度和零点。只有求和各项共享同一个尺度时,才能把该尺度提到求和之外。整数计算对应所选的量化近似,并不精确等价于原始 fp32 模型。
选择粒度
粒度决定哪些权重共享一个尺度:
- 逐张量:整个张量共享一个尺度,元数据少,但离群值决定范围时,分辨率可能较低。
- 逐通道:每个输出通道使用一个尺度,以适应通道之间的差异。
- 逐组:每块权重使用一个尺度。更小的组可能改善局部分辨率,但需要更多尺度元数据。
按通道分组依据层的输出维度;按组量化还需要指定组大小。不同格式和实现的默认值不同,因此应检查检查点规范,并比较受支持选项的质量和存储成本。
为什么这行得通
对于不发生截断的理想均匀量化器,单值舍入误差不超过 。常见的方差公式 还假设误差在该区间内均匀分布,对任意权重并不一定成立。舍入是非线性的,不会自动保留距离或模型质量。
正规浮点数在相邻二次幂之间等间距分布,进入下一个区间时,间距加倍。均匀整数量化则在每组内使用固定步长。因此,零附近的分辨率取决于组尺度,而不是每个值各自的指数。
切换显示范围以比较网格。浮点间距随数值大小逐级增加;每一行整数量化则在显示范围内使用等间距级别。
于是在组大小为 64 的 int4 下,存储图景是这样的:
- 每个权重 4 位 = 0.5 字节
- 加上每 64 个权重一个 fp16 缩放因子 ≈ 2 字节 / 64 = 0.031 字节/权重
- 合计 ≈ 0.53 字节/权重
这就是为什么实践中把「int4」报作「每个参数 0.5 字节」——开销真实存在,但很小。
量化那个 MNIST 分类器
为了在我们已经见过的模型上把这件事讲具体,我们把同样的配方应用到本系列早前那个 MNIST 分类器的第一个 Dense 层——即带有 (784, 128) fp32 权重矩阵的 Dense(128, input_shape=(784,)) 层。选择逐通道粒度:128 组,每个输出通道一组,每组包含 784 个权重。对每个通道 ,计算 。如果通道 0 绝对值最大的权重是 0.234,那么 ,该通道的网格就是 ——255 个点,间距 0.00184,恰好铺满该通道的范围。通道 1 得到不同的 ,所以同一个 int8 值 42 解码为 ——每个通道对应一个不同的实数:
import keras
import numpy as np

model = keras.models.load_model('mnist_classifier.keras')
W = model.layers[0].kernel.numpy()         # (784, 128), fp32
print(W.shape, W.dtype, W.nbytes)          # (784, 128) float32 401408

INT8_MAX = 127

# Per-channel int8: one scale per output channel (128 channels)
scales = np.maximum(np.abs(W).max(axis=0) / INT8_MAX, np.finfo(np.float32).tiny)  # (128,), fp32

# Quantize: divide by scale (broadcasts), round to nearest int, cast to int8
W_q = np.round(W / scales).astype(np.int8) # (784, 128), int8

# Dequantize on read: cast to fp32, multiply by per-channel scale
W_back = W_q.astype(np.float32) * scales

# Storage: 100,352 bytes (int8 weights) + 128 * 4 = 512 bytes (scales)
# vs original 401,408 bytes — ~4× smaller, scale overhead ~0.13%
第一层矩阵从 401,408 字节缩小到 100,352 字节,再加上 512 字节的尺度。W_back 恢复的是 float32 近似,因此它本身并不节省存储。要测量质量,应将恢复后的权重赋给模型副本并在留出数据上评估;这段代码没有报告这样的测试结果。
把同样的配方用到第二层的 (128, 10) 权重上,我们就有了整个模型的图景:
| 层 | 形状 | fp32 权重 | int8 权重 | 逐通道缩放因子 | int8 合计 |
|---|---|---|---|---|---|
| Dense 1 | (784, 128) | 401,408 B | 100,352 B | 128 × 4 = 512 B | 100,864 B |
| Dense 2 | (128, 10) | 5,120 B | 1,280 B | 10 × 4 = 40 B | 1,320 B |
| 合计 | 406,528 B(约 397 KiB) | 102,184 B(约 100 KiB) |
两个矩阵在 fp32 中占 406,528 字节,在包含尺度的这种 int8 表示中占 102,184 字节。138 个偏置保留为 fp32 时,两种方案都需再加 552 字节。因此,参数存储约为 407 KB 对 103 KB,接近缩小四倍。运行时能节省多少内存,取决于实现是否保留并使用压缩权重。