Floaty, bfloat i jak bity kształtują pamięć modelu
Sieć neuronowa przechowuje wyuczone parametry, w tym wagi i biasy. Liczba parametrów pomnożona przez liczbę bajtów na parametr daje rozmiar samych parametrów. Podczas działania potrzebna jest też pamięć na aktywacje, bufory tymczasowe oraz, zależnie od zadania, pamięć podręczną lub stan treningu.
Weźmy małą sieć, którą wytrenowaliśmy w artykule o MNIST — gęsty klasyfikator z dwiema warstwami Dense w Kerasie: 784 spłaszczone piksele wejściowe zasilają warstwę ukrytą o 128 neuronach, która zasila warstwę wyjściową o 10 neuronach (po jednym na cyfrę).
Skrótowy zapis tego kształtu to 784 → 128 → 10, gdzie 784 to rozmiar wejścia, a nie warstwa. Liczba parametrów sumuje się do:
Przy domyślnej polityce fp32 te parametry zajmują 407 080 bajtów: około 407 KB, czyli 398 KiB. Nie obejmuje to pozostałej pamięci używanej podczas działania modelu.
Repozytoria modeli często zawierają kartę modelu, która opisuje model i jego trening. Metadane plików wag mogą też podawać liczbę parametrów i typy danych użyte do ich zapisu.
Poniższy zrzut pokazuje panel Hugging Face dla PaddleOCR-VL-1.5, z zaokrągloną liczbą parametrów i typem tensorów:
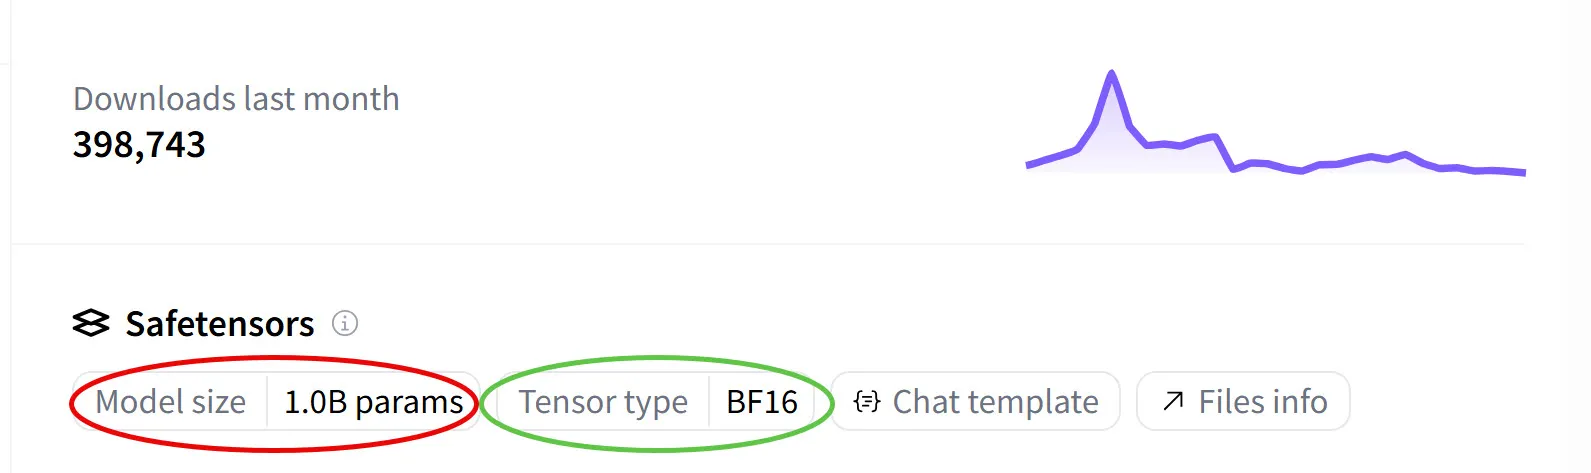
Model size podaje liczbę parametrów. Tensor type określa dtype, czyli typ danych użyty do zapisu. dtype tensora opisuje jego elementy, np. float32, int8 lub bfloat16; Pythonowe type() opisuje sam obiekt.
W kodzie sprawdzisz to przez .dtype; sposób wyświetlania różni się między bibliotekami:
>>> import torch
>>> torch.tensor([0.5], dtype=torch.bfloat16).dtype
torch.bfloat16

>>> import numpy as np
>>> np.array([0.5], dtype=np.float16).dtype
dtype('float16')
Hugging Face czyta tę samą informację prosto z pliku safetensors — safetensors to format plików Hugging Face do zapisu i dystrybucji wytrenowanych wag, a dtype każdego tensora jest zapisany w jego metadanych, co pasek boczny wyświetla jako „Tensor type”.
BF16 oznacza bfloat16, 16-bitowy format zmiennoprzecinkowy opracowany w Google. Ma pola znaku, wykładnika i części ułamkowej, ale inny podział bitów niż IEEE binary16. Checkpoint może zawierać tensory różnych typów, więc dokładny rozmiar należy obliczać na podstawie jego metadanych.
Kroki obliczenia zajętości pamięci modelu są więc te same, których użyliśmy dla MNIST, tylko z większymi liczbami. Wartość 1.0B to suma parametrów po wszystkich warstwach modelu — ta sama arytmetyka warstwa po warstwie, którą zrobiliśmy ręcznie dla MNIST, tyle że Hugging Face już zrobił ją za nas, przechodząc po każdym tensorze w pliku safetensors i sumując liczby elementów.
Karta mówi więc: 1 miliard parametrów („B” to skrót od billion, ). Pomnóż to przez 2 bajty na wagę bf16, a dostaniesz zajętość wag modelu:
To oszacowanie dotyczy tylko wag. Inferencja wymaga też aktywacji, buforów roboczych, a czasem cache KV, który przy długich sekwencjach lub dużych batchach może zajmować znaczną część pamięci. Trening potrzebuje dodatkowo gradientów, stanu optymalizatora i zapisanych aktywacji.
Same wagi modelu z 7 miliardami parametrów zajmują około 28 GB w fp32, 14 GB w fp16/bf16 lub 7 GB w int8, bez metadanych kwantyzacji. Model z 70 miliardami parametrów potrzebuje około 140 GB na wagi fp16. O tym, czy model zmieści się na urządzeniu, decydują też pozostałe wymagania pamięciowe.
Niższa precyzja może zmniejszyć rozmiar wag: fp16 i bf16 zajmują o połowę mniej bajtów niż fp32, a kwantyzacja do 8 lub 4 bitów kompresuje je jeszcze bardziej. Jakość i szybkość zależą od modelu, metody konwersji i sprzętu; trzeba je zmierzyć.
Nie każda liczba w sieci jest wagą
Działająca sieć używa kilku rodzajów tensorów. Artykuł o propagacji wstecznej wyjaśnia, skąd pochodzą parametry, aktywacje i gradienty.
Wagi i aktywacje występują zarówno podczas inferencji, jak i treningu. Przy inferencji tensory pośrednie można zwolnić, gdy nie są już potrzebne, choć połączenia rezydualne i bufory robocze mogą wymagać przechowywania kilku tensorów naraz. Trening zwykle zapisuje aktywacje do propagacji wstecznej; checkpointing pozwala część z nich obliczać ponownie w zamian za oszczędność pamięci. Aktywacje nie muszą mieć tego samego dtype co wagi.
Przy inferencji LLM-y oparte na transformerach niosą też cache KV — klucze i wartości buforowane z przeszłych tokenów podczas generacji autoregresyjnej, żeby uwaga nie musiała ich przeliczać dla każdego nowego tokenu. Często trzymany w fp16 lub fp8, by oszczędzić pamięć przy długich kontekstach.
Podczas treningu do obrazu wchodzą jeszcze dwie kategorie:
- Gradienty opisują, jak strata zmienia się względem parametrów. Ich wartości mogą znacznie się różnić, dlatego ważny jest zakres formatu.
- Stan optymalizatora zależy od algorytmu. Adam przechowuje dwie aktualizowane statystyki na parametr; ich dtype zależy od implementacji i polityki precyzji.
W kodzie dtype występuje w kilku konkretnych miejscach. Oto odpowiedni fragment z naszego artykułu o treningu na MNIST:
# Input data — explicitly cast to float32
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0

# Model — Dense layers default to fp32 for weights and biases (no dtype= passed)
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,)),
    keras.layers.Dense(10, activation="softmax"),
])

# Optimizer — owns its own state, allocated separately
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)
.astype("float32") ustawia dtype tablicy wejściowej. Warstwy Kerasa mają własne typy zmiennych i obliczeń, określające zapis parametrów i wykonywanie operacji. Domyślna polityka używa tu fp32 w obu rolach. Można ustawić inną politykę dla każdej warstwy:
# Same architecture, but weights and biases stored in bf16
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,), dtype="bfloat16"),
    keras.layers.Dense(10, activation="softmax", dtype="bfloat16"),
])
# PyTorch equivalent — nn.Linear takes the dtype directly
model = nn.Sequential(
nn.Linear(784, 128, dtype=torch.bfloat16),
nn.ReLU(),
nn.Linear(128, 10, dtype=torch.bfloat16),
)W Kerasie dtype="bfloat16" ustawia typ zmiennych i obliczeń. Polityka mieszanej precyzji, np. "mixed_bfloat16", zachowuje zmienne w fp32, a obliczenia wykonuje w bf16. W PyTorch konstruktor ustawia typ parametrów; wejścia i operacje muszą być z nim zgodne lub obsługiwane przez autocast. Typy gradientów i stanu optymalizatora również zależą od implementacji.
Mieszana precyzja oznacza używanie różnych formatów do różnych operacji lub rodzajów danych. W tym artykule „model bf16” odnosi się do zapisu wag, chyba że zaznaczono inaczej.
Jeden z wariantów Adama z mieszaną precyzją wymaga 16 bajtów na parametr, bez aktywacji:
- wagi bf16: 2 bajty
- gradienty bf16: 2 bajty (ten sam kształt co wagi)
- momenty Adama fp32: 8 bajtów (dwa momenty × po 4 bajty)
- główna kopia wag fp32 (trzymana przez optymalizator dla stabilnych aktualizacji): 4 bajty
Przy tych założeniach pamięć związana z parametrami podczas treningu jest osiem razy większa niż sam zapis wag bf16. To przykład rachunku, a nie stały wymóg: kopie główne, typy gradientów, warianty optymalizatora i podział danych między urządzenia zmieniają wynik. Aktywacje zwiększają go zależnie od zadania.
Dla 7 miliardów parametrów ten wariant wymaga około 112 GB plus aktywacje i bufory, wobec 14 GB na same wagi bf16. Pełny trening może ograniczyć pamięć urządzenia przez sharding lub offloading; dostrajanie adapterów zmienia rachunek, ponieważ uczy tylko część parametrów.
Domyślne formaty zmiennoprzecinkowe w Pythonie i JavaScripcie
Zanim spojrzymy na formaty numeryczne, których ML faktycznie używa, warto zacząć od znajomych typów liczbowych, których używamy na co dzień w Pythonie i JavaScripcie:
| Język | Rodzaj | Typ | Szczegóły |
|---|---|---|---|
| Python | Całkowity (bez ułamków, dokładny) | int | Dowolnej precyzji. CPython rozszerza pamięć w miarę potrzeby, więc 2**1000 po prostu działa, a wynik jest dokładny. |
| Float (64-bitowy double IEEE-754) | float | Ten sam format, który rozbieramy w reszcie artykułu. Sama wartość zajmuje 8 bajtów; obiekt Pythona ma dodatkowy narzut. | |
| JavaScript | Całkowity (bez ułamków, dokładny) | BigInt | Liczba całkowita dowolnej precyzji, dodana później jako osobny typ. Zapisywana z sufiksem n (np. 5n). Najbliższy odpowiednik pythonowego int. |
| Float (64-bitowy double IEEE-754) | Number | Ten sam format co pythonowy float. JavaScript używa go i do całkowitych, i do ułamków; domyślnie nie ma osobnego typu całkowitego. |
float w typowych kompilacjach CPythona i Number w JavaScripcie używają IEEE binary64. Stąd wspólna reprezentacja 0.1 i wynik 0.1 + 0.2 = 0.30000000000000004. Zachowanie języków nadal się różni: Python przy dzieleniu przez zero zgłasza wyjątek, a JavaScript może zwrócić nieskończoność. Obiekt zajmuje też pamięć poza ośmiobajtową wartością.
Mechanikę tego, jak te 64 bity dzielą się na znak, wykładnik i mantysę, dlaczego wykładnik jest przechowywany z przesunięciem zamiast w kodzie uzupełnień do dwóch i jak zaokrągla się 0.1, omawiam szczegółowo we wcześniejszych artykułach serii. Wszystko stamtąd stosuje się wprost do obu języków, bo pod spodem to ten sam 64-bitowy format.
Zwykłe literały zmiennoprzecinkowe używają tych formatów domyślnych. Tablice i tensory pozwalają wybrać inne formaty zapisu; JavaScript udostępnia też Float32Array. Frameworki ML dodają m.in. bf16 i reprezentacje kwantowane o małej liczbie bitów.
Jak konwersje gubią bity: od floatów językowych do dtype’ów ML
Ilekroć wartość przechodzi z jednego formatu numerycznego do drugiego — pythonowy float do int, float do int8, fp64 do fp16 — jest szansa, że bity się nie zmieszczą. Coś musi ustąpić, a to, dokąd trafiają brakujące bity, zależy od formatu źródłowego i docelowego.
Najprostszy przypadek to float → int: odrzuć wszystko za przecinkiem.
>>> int(3.7)
3
>>> int(-3.7)
-3               # truncates toward zero — drops the fractional bits
>>> import math
>>> math.floor(-3.7)
-4               # floor rounds toward -infinity instead
Obcięcie można rozumieć jako odtworzenie wartości binarnej i odrzucenie części ułamkowej. Konkretne instrukcje konwersji zależą od implementacji.
Weźmy na przykład 5.75. W binarnym to 101.11 — trzy bity przed przecinkiem (101 = 4 + 1 = 5) i dwa po (.11 = 0.5 + 0.25 = 0.75). IEEE-754 nie przechowuje tego jednak w ten sposób; normalizuje liczbę tak, by przed przecinkiem stała dokładnie jedna 1, i zapamiętuje przesunięcie w wykładniku:
   101.11   →   1.0111 × 2^2
   ^^^ ^^       ^ ^^^^   ^
   │   │        │ │      └── exponent: how far to shift the radix back
   │   │        │ └───────── mantissa (fractional part of the 1.xxx form)
   │   │        └─────────── the implicit leading 1 (not stored)
   │   └──────────────────── original fractional bits
   └──────────────────────── original integer bits
Zapisana część ułamkowa zaczyna się od 0111, a wykładnik po odjęciu biasu wynosi 2. Przywrócenie domyślnej jedynki i przesunięcie punktu binarnego wyjaśnia konwersję na liczbę całkowitą:
   mantissa:    1.0111
   shift by 2:  101.11
                ^^^ ^^
                │   └── fractional bits → discarded
                └────── integer bits    → 101 = 5
Odrzucenie .11 usuwa 0.75, więc int(5.75) zwraca 5. To zaokrąglanie w stronę zera, nazywane obcięciem, a nie do najbliższej liczby całkowitej. Dlatego int(-3.7) zwraca -3.
Konwersje do węższych typów mogą obcinać, zaokrąglać, przepełniać zakres lub zgłaszać błąd. Znaczenie ma API: konstruktor może odrzucić liczbę poza zakresem, choć rzutowanie istniejącego tensora ją zawija.
>>> torch.tensor([3.7, -3.7], dtype=torch.int8)       # float → int, truncates toward zero
tensor([3, -3], dtype=torch.int8)                     # → fractional bits dropped on each element

>>> torch.tensor([1000, 1001], dtype=torch.int64).to(torch.int8)      # int → int8, overflows (int8 max is 127)
tensor([-24, -23], dtype=torch.int8)                  # → low 8 bits kept, neighbours wrap together

>>> torch.tensor([1e5, -1e10], dtype=torch.float16)   # fp64 → fp16, overflows (fp16 max is ~65504)
tensor([inf, -inf], dtype=torch.float16)              # → saturate to ±inf; magnitudes are lost

>>> torch.tensor([2**24 + 1, 2**24 + 2], dtype=torch.float32)  # int → fp32, exceeds mantissa precision
tensor([16777216., 16777218.], dtype=torch.float32)            # → +1 rounds away (24-bit mantissa); +2 is exact
Te przykłady pokazują cztery wyniki konwersji:
| Wzorzec | Z | Do | Przykład | Wynik |
|---|---|---|---|---|
| Obcięcie | float | int | 3.7 → int8 | 3 |
| Zawinięcie | int | węższy int | 1000 → int8 | -24 |
| Nasycenie do nieskończoności | float | węższy float | 1e5 → fp16 | inf |
| Utrata precyzji | int | float | 2^24 + 1 → fp32 | 2^24 |
Zawijanie. Rzutowanie istniejącego tensora całkowitego na int8 zachowuje osiem najmłodszych bitów. W kodzie uzupełnień do dwóch 1000 staje się więc -24. Nie oznacza to, że każdy konstruktor przyjmie wartość spoza zakresu.
Przepełnienie zmiennoprzecinkowe. Przy zaokrąglaniu do najbliższej wartości konwersja 1e5 na fp16 daje inf, ponieważ największa skończona wartość fp16 to 65 504. Inne tryby zaokrąglania mogą dawać inne wyniki przepełnienia.
Utrata precyzji. 2^24 + 1 → fp32 staje się 2^24. Mantysa fp32 ma 24 bity (23 jawne + 1 niejawny), więc każda liczba całkowita od 0 do 2^24 (16 777 216) jest dokładnie reprezentowalna, ale powyżej tego odstęp między reprezentowalnymi wartościami podwaja się co każdą potęgę dwójki. Liczba 2^24 + 1 wpada między dwie reprezentowalne wartości fp32 i zostaje zaokrąglona do bliższej (2^24, bo +1 leży dokładnie w połowie, a remisy zaokrągla się do parzystej). To ta sama historia, przez którą fp64 zaczyna tracić precyzję całkowitą przy 2^53 ≈ 9 × 10^15 — javascriptowy Number.MAX_SAFE_INTEGER to dokładnie 2^53 − 1.
Wynik konwersji zależy od wartości, formatów źródłowego i docelowego, trybu zaokrąglania oraz API. Trzeba rozpatrywać je łącznie.
Jawny wybór typu danych
Ekosystem ML wystawia znacznie szersze menu, niż natywnie robią to Python czy JavaScript. Każdy główny framework numeryczny — NumPy, PyTorch, JAX i TensorFlow — pozwala wybrać dtype jawnie. Oto ta sama operacja w czterech frameworkach:
import torch
x = torch.tensor([0.5])                        # fp32 by default — 4 bytes
y = torch.tensor([0.5], dtype=torch.float16)   # fp16 — 2 bytes
z = torch.tensor([0.5], dtype=torch.bfloat16)  # bf16 — 2 bytes
w = torch.tensor([0.5], dtype=torch.float64)   # fp64 — 8 bytes, same as Python float
import tensorflow as tf
x = tf.constant([0.5]) # fp32 by default — 4 bytes
y = tf.constant([0.5], dtype=tf.float16) # fp16 — 2 bytes
z = tf.constant([0.5], dtype=tf.bfloat16) # bf16 — 2 bytes
w = tf.constant([0.5], dtype=tf.float64) # fp64 — 8 bytesimport numpy as np
x = np.array([0.5], dtype=np.float32) # 4 bytes per element
y = np.array([0.5], dtype=np.float16) # 2 bytes
# NumPy core has no bfloat16 — you need the `ml_dtypes` package, or JAX/TF/Torch arraysimport jax.numpy as jnp
x = jnp.array([0.5], dtype=jnp.bfloat16) # bf16 — 2 bytesTe konstruktory pozwalają wybrać dtype elementów. NumPy nie zawiera bf16 w podstawowych typach; mogą go dostarczać rozszerzenia. PyTorch, JAX i TensorFlow udostępniają bf16, choć obsługa operacji zależy od urządzenia i backendu.
Literał 0.5 z punktu widzenia Pythona nadal jest 64-bitowym double — konwersja zachodzi przy konstruowaniu tensora. Wewnętrznie każdy element zajmuje 8, 4, 2 albo 2 bajty, zależnie od dtype. Przy fp8 staje się to 1 bajtem; przy int4 — pół bajta.
Żeby zobaczyć, co te bajty faktycznie kodują — i dlaczego zmniejszenie ich o połowę nie tnie po prostu reprezentowalnego zakresu na pół — musimy przyjrzeć się formatowi pod spodem.
Formaty zmiennoprzecinkowe używane w ML
Współczesny ML używa garstki formatów zmiennoprzecinkowych i wszystkie dzielą ten sam trójpolowy układ odziedziczony po IEEE-754:
- Znak (1 bit) — dodatnia czy ujemna.
- Wykładnik — jak daleko przesunąć przecinek, przechowywany jako kod z przesunięciem.
- Mantysa (część znacząca) — wiodące cyfry liczby w znormalizowanej postaci naukowej, z pominiętą niejawną wiodącą
1.
Dla liczb normalnych wykładnik określa skalę, a mantysa — precyzję. Specjalne kodowania obsługują zero, nieskończoność, NaN i liczby subnormalne, ale wsparcie się różni: część wariantów fp8 nie ma nieskończoności, a niektóre urządzenia zerują liczby subnormalne.
| Format | Bitów łącznie | Znak | Wykładnik | Mantysa | Bajty/param |
|---|---|---|---|---|---|
| fp64 (IEEE-754 double) | 64 | 1 | 11 | 52 | 8 |
| fp32 (IEEE-754 single) | 32 | 1 | 8 | 23 | 4 |
| bf16 (Brain Float 16) | 16 | 1 | 8 | 7 | 2 |
| fp16 (IEEE-754 binary16) | 16 | 1 | 5 | 10 | 2 |
Oba formaty 16-bitowe inaczej dzielą ten sam budżet. Przeniesienie jednego bitu z części ułamkowej do wykładnika podwaja odstępy dla danego normalnego wykładnika i znacznie rozszerza zakres wykładników; nie oznacza jedynie podwojenia największej wartości.
[1, 4) (128 per octave; gap doubles at 2)Dla liczb normalnych z bitami części ułamkowej odstęp wynosi w i dwa razy więcej w . bf16 sięga około z odstępem około 0.008 przy jedynce; fp16 sięga 65 504 z odstępem około 0.001 przy jedynce.
Pasek u dołu widżetu uwidacznia ten odstęp: przy wybranym bf16 widać pojedyncze znaczniki rozstawione na [1, 2] — te odstępy to granica precyzji formatu w skali jednostkowej. Przełącz na fp16, a znaczniki zlewają się w ciągłą linię, bo odstęp zszedł poniżej piksela. Siatka wciąż jest dyskretna; jest tylko na tyle gęsta, że nie widać już dyskretności — a to dokładnie znaczy tutaj „więcej precyzji”.
Pasek sięga też do kolejnej oktawy [2, 4) (za przerywany znacznik przy 2), by jasno pokazać, że to podwajanie odstępu nie jest szczególne dla zakresu [1, 2) — ta sama liczba znaczników (po jednym na stan mantysy) rozciąga się na dwukrotnie szerszy przedział, więc wizualny odstęp w prawej połowie jest dwa razy większy niż w lewej. Przeciągnij suwak do ustawienia z małą mantysą (np. M=4), a podwojenie stanie się oczywiste.
Dla konkretu, kilka pierwszych reprezentowalnych wartości w [1, 2] dla każdego presetu:
| bf16 (128 wartości, odstęp = 1/128) | fp16 (1024 wartości, odstęp = 1/1024) |
|---|---|
1.0 | 1.0 |
1.0078125 | 1.0009765625 |
1.015625 | 1.001953125 |
1.0234375 | 1.0029296875 |
1.03125 | 1.00390625 |
| … | … |
1.9921875 | 1.9990234375 |
(2.0) | (2.0) |
Każda kolejna wartość bf16 ląduje dokładnie na co ósmej wartości fp16 — siatka bf16 w tej oktawie jest ścisłym podzbiorem siatki fp16, tylko z siedmioma z każdych ośmiu znaczników usuniętymi. Ten stosunek to dokładnie (fp16 ma 10 bitów mantysy, bf16 ma 7) — każdy dodatkowy bit mantysy podwaja liczbę reprezentowalnych wartości na oktawę.
Odstępy są równe w każdym normalnym przedziale . W kolejnym przedziale podwajają się, a w stronę zera maleją aż do obszaru subnormalnego, gdzie są stałe.
Oto to dla bf16 na kilku oktawach:
| Oktawa bf16 | Odstęp |
|---|---|
[1, 2) | 1/128 ≈ 0.0078 |
[2, 4) | 2/128 = 1/64 ≈ 0.0156 |
[4, 8) | 4/128 = 1/32 ≈ 0.0313 |
| … | … |
[1024, 2048) | 1024/128 = 8 |
bf16 ma szerszy zakres wykładników, a fp16 — większą precyzję przy porównywalnych normalnych wartościach. Zbyt duże liczby mogą przepełnić zakres, a bardzo małe tracić precyzję lub zanikać do zera. Przydatność obu formatów zależy od zadania i sprzętu.
Dlaczego bity bf16 są podzielone właśnie tak
Google opracowało bf16 dla ML, zachowując osiem bitów wykładnika fp32 i zmniejszając część ułamkową z 23 do siedmiu bitów. Zakres wykładników jest więc podobny do fp32, przy znacznie niższej precyzji.
Przy tym samym normalnym wykładniku odstęp w bf16 jest razy większy niż w fp32. Tak zaokrągla się 1.005 w trzech formatach:
| Format | Przechowywana wartość | Błąd |
|---|---|---|
| fp32 | 1.005 (praktycznie dokładnie) | ~10⁻⁸ |
| fp16 | 1.0048828125 | ~1.2 × 10⁻⁴ |
| bf16 | 1.0078125 | ~2.8 × 10⁻³ |
Dla 1.005 fp16 jest dokładniejszy. Przy małych wartościach 1e-7 daje niezerową liczbę subnormalną fp16: około 1.192e-7. Przy zaokrąglaniu do najbliższej wartości 1e-8 staje się zerem, podczas gdy bf16 może zapisać zbliżoną wartość.
Przepełnienie, niedomiar i błędy zaokrągleń mogą wpływać na trening. Przepełnienie może propagować nieskończoności lub NaN, a niedomiar usuwać małe gradienty. Zaokrąglanie może też sprawić, że niewielkie aktualizacje nie zmienią wagi o niskiej precyzji. Sam szerszy zakres nie gwarantuje stabilności.
Skalowanie straty mnoży stratę przed propagacją wsteczną i usuwa skalę z gradientów przed aktualizacją, pomagając zachować małe gradienty w fp16. Skalowanie dynamiczne reaguje też na przepełnienia. PyTorch udostępnia torch.amp.GradScaler("cuda"). Szerszy zakres bf16 zwykle pozwala obyć się bez skalowania straty.
Ta sama wymiana przy każdej szerokości
Konwersja fp32 na bf16 jest prosta, ale nie musi być przesunięciem bitowym: Cloud TPU zaokrągla do najbliższej wartości z remisem do parzystej i zeruje liczby subnormalne bf16. Powrót do fp32 jest dokładny, ale nie odzyskuje utraconych bitów.
fp16 nadal jest przydatny, gdy zadaniu odpowiadają jego trzy dodatkowe bity części ułamkowej lub obsługa sprzętowa. bf16 często ułatwia trening, ale żaden z formatów nie zastępuje drugiego w każdej sytuacji.
Sprzętowa obsługa formatów
Natywne obliczenia o niskiej precyzji mogą zwiększyć przepustowość, a kompaktowy zapis ograniczyć ruch pamięci nawet wtedy, gdy obliczenia używają szerszego typu. Rzeczywista szybkość zależy od kernela i zadania.
Przykłady obsługi sprzętowej:
| Format | Gdzie działa natywnie |
|---|---|
| fp64 / fp32 | Szeroko obsługiwane przez CPU i GPU; przepustowość zależy od urządzenia. |
| fp16 | Rdzenie tensorowe NVIDII od Volty (V100, 2017); inni producenci poszli w ślad. |
| int8 | Między innymi rdzenie tensorowe NVIDIA Turing (T4, 2018). |
| bf16 | Google TPU v2 (2017), NVIDIA Ampere (A100, 2020), Intel AVX-512 BF16, Arm Armv8.6-A BF16. |
| fp8 (E4M3, E5M2) | NVIDIA Hopper (H100, 2022), AMD CDNA 3 (MI300), Intel Gaudi 2/3. |
| int4 | Tryby int4 pojawiły się w rdzeniach tensorowych NVIDIA Turing; obsługa zależy od generacji i API. |
Jednostki macierzowe, takie jak Tensor Cores i TPU MXU, przyspieszają bloki operacji mnożenia z akumulacją. Precyzja argumentów i akumulacji oraz zasady zaokrąglania zależą od instrukcji; operacja macierzowa nie musi zaokrąglać tak jak pojedyncze skalarne FMA.
Zapis z mniejszą liczbą bitów zmniejsza rozmiar tensorów. Szybsze wykonanie wymaga też odpowiednich kerneli, sprzętu i dostatecznej ilości pracy. Koszt konwersji lub inne wąskie gardła mogą przeważyć nad zyskiem obliczeniowym.
Osobno sprawdzaj format checkpointu i obsługę urządzenia przez runtime. Na przykład spakowane wagi int4 można dekwantyzować do obliczeń zmiennoprzecinkowych bez natywnych instrukcji macierzowych int4. Mierz wspieraną ścieżkę zamiast wnioskować o szybkości z nazwy dtype.
Patrząc naprzód: fp8
Dwa popularne warianty fp8 inaczej dzielą osiem bitów:
| Format | Znak | Wykładnik | Mantysa | Do czego |
|---|---|---|---|---|
| fp8 E4M3 | 1 | 4 | 3 | wagi i aktywacje przebiegu w przód (przechył ku precyzji) |
| fp8 E5M2 | 1 | 5 | 2 | gradienty (przechył ku zakresowi) |
Praca FP8 Formats for Deep Learning opisuje E4M3 i E5M2 oraz ich zastosowania w treningu z mieszaną precyzją.
Częsta konfiguracja używa E4M3 dla argumentów przejścia w przód i E5M2 dla gradientów. Współczynniki skali dopasowują wartości do dostępnego zakresu. Poniższy przykład używa jednej skali dla całego tensora; inne warianty korzystają z mniejszych bloków lub innych metod skalowania.
import torch

w_fp32 = torch.randn(1024, 1024, dtype=torch.float32) * 0.1

# Per-tensor scale: |max| / fp8_max maps the tensor's range into fp8's
FP8_E4M3_MAX = 448.0
scale = (w_fp32.abs().max() / FP8_E4M3_MAX).clamp_min(torch.finfo(torch.float32).tiny)

# Quantize: divide by scale, then cast to fp8
w_fp8 = (w_fp32 / scale).to(torch.float8_e4m3fn)

# Reconstruct on read: cast back, multiply by scale
w_back = w_fp8.to(torch.float32) * scale
Biblioteki takie jak NVIDIA Transformer Engine oferują konfiguracje fp8 zarządzające skalowaniem i stanem o wyższej precyzji. Sam zapis tensora jako torch.float8_e4m3fn nie implementuje takiego treningu.
Suwak zmienia największą wartość bezwzględną tensora. Zielone kreski pokazują wartości fp8 po zastosowaniu skali, a niebieskie punkty — przykładowe dane. To ilustracja skalowania, nie pełna implementacja treningu lub inferencji.
Dlaczego modele tolerują mniej bitów
Wiele sieci toleruje pewne błędy zaokrągleń, ale poszczególne wagi i kanały mogą być wrażliwe. Jakość kwantyzacji zależy od rozkładu błędów, wartości odstających, akumulacji i zadania. Błędy nie muszą się znosić przy łączeniu wartości.
Poniższe badania pokazują skuteczne metody niskiej precyzji w określonych warunkach oceny. Nie gwarantują niezmienionej jakości każdego modelu ani tego, że większe modele zawsze tolerują mniej bitów.
Deep Compression łączyło przycinanie, kwantyzację i kodowanie, kompresując m.in. AlexNet. Mixed Precision Training pokazało trening z arytmetyką fp16 i głównymi wagami fp32 z zachowaniem jakości w badanych eksperymentach.
W przypadku LLM LLM.int8() łączy mnożenie int8 z wyższą precyzją dla wartości odstających, a GPTQ kwantyzuje wagi do małej liczby bitów. QLoRA zamraża skwantowany model bazowy i uczy adaptery. BitNet b1.58 trenuje natomiast z wagami trójwartościowymi; nie oznacza to, że dowolny gotowy model można sprowadzić do trzech wartości bez utraty jakości.
Kwantyzacja to ta sama myśl, posunięta dalej
Tutaj skupimy się na jednorodnej kwantyzacji całkowitoliczbowej: każdą wagę opisuje mała liczba całkowita i wspólna skala, czasem także punkt zerowy. Inne schematy, np. NF4, używają nierównomiernych poziomów.
Zanim przejdziemy do mechaniki, oto co kwantyzacja faktycznie daje:
- Pamięć: same dane wag int8 i spakowanych int4 są odpowiednio cztery i osiem razy mniejsze niż fp32, bez metadanych.
- Szybkość: mniejszy ruch pamięci i odpowiednie kernele mogą pomóc, ale liczą się też konwersje i narzut wykonania.
- Wdrożenie: niektóre akceleratory wymagają modeli całkowitoliczbowych; inne obsługują kilka formatów.
- Energia: mniej przesyłanych danych i obliczenia o niższej precyzji mogą oszczędzać energię zależnie od sprzętu i zadania.
Są dwa przepływy właściwej kwantyzacji, zależnie od tego, kiedy w cyklu życia modelu ją robisz. Dzielą tę samą arytmetykę „przyciągania do siatki”, którą zbadamy w następnej podsekcji.
Kwantyzacja po treningu (PTQ) przekształca wytrenowany model bez ponownego uczenia parametrów. Niektóre metody wymagają danych kalibracyjnych i znacznych obliczeń. Przykładami są GPTQ i AWQ; biblioteki i środowiska wykonawcze obsługują różne algorytmy i formaty checkpointów, więc trzeba sprawdzać zgodność.
Trening świadomy kwantyzacji (QAT) symuluje kwantyzację podczas uczenia, aby parametry mogły dostosować się do błędu. Wymaga treningu lub dostrajania, ale niekoniecznie etykietowanych danych: LLM-QAT używa destylacji. Przewaga nad PTQ zależy od modelu, liczby bitów i oceny.
Mniejsza liczba bitów zwykle ogranicza dokładność reprezentacji. Oceniaj skompresowany model na docelowych zadaniach; sama oszczędność pamięci nie świadczy o wystarczającej jakości.
Przepis „przyciągnij i przeskaluj”
W tym symetrycznym przykładzie zapisujemy jedną liczbę całkowitą na wagę i jedną skalę na grupę. Dla int8 używamy indeksów od -127 do 127: 255 poziomów. Analogiczny zakres int4, od -7 do 7, ma 15 poziomów; inne schematy mogą używać wszystkich 256 lub 16 kombinacji bitów.
Dekwantyzacja przybliża wagę jako index × S. Niektóre kernele łączą ten krok z mnożeniem macierzy; inne najpierw tworzą szerszy tensor. Typ odtwarzanych wartości również może się różnić.
Rozważmy grupę pięciu wag:
Proces ma dwa kroki, które widżet poniżej pozwala przeklikać. Na wysokim poziomie: najpierw liczymy jedną skalę dla całej grupy — to daje siatkę, do której przyciągną się wszystkie wagi. Potem dla każdej wagi stosujemy właściwą kompresję — przyciągamy do najbliższego punktu siatki (z zaokrąglaniem remisów do parzystej) i zapisujemy indeks całkowity. Krok 1 wykonuje się raz na grupę; krok 2 raz na wagę.
Żeby zdefiniować zbiór dyskretny, spójrz na zakres wartości w grupie wag i policz skalę z danych. Oto ogólny wzór dla symetrycznej kwantyzacji -bitowej:
Mianownik to — największy indeks co do wartości bezwzględnej w symetrycznej -bitowej liczbie całkowitej ze znakiem. Dla int8 to ; dla int4 ; dla int2 .
Licznik to największa co do wartości bezwzględnej waga w grupie: , gdzie to wag kwantyzowanych razem.
Zamysł jest więc taki: podziel największą co do modułu wagę przez największy indeks co do modułu. Gwarantuje to, że najbardziej skrajna waga odwzorowuje się dokładnie na punkt siatki — bez obcinania, przy pełnym wykorzystaniu siatki.
Dla naszych pięciu przykładowych wag i int8 (, więc mianownik ):
Zauważ, że pełni naraz dwie role: jest mnożnikiem (indeks × S odzyskuje wartość fp32) i odstępem siatki (kolejne indeksy różnią się o 1, więc kolejne pozycje siatki różnią się dokładnie o ). Na przykład indeks 41 dekoduje się na 41 × 0.0748 ≈ 3.067, a indeks 42 na 42 × 0.0748 ≈ 3.142 — odstęp między nimi to dokładnie 0.0748, czyli . Ta sama liczba, dwa znaczenia.
Skoro mamy , siatka wynika wprost: każdy punkt siatki to indeks × S dla pewnego indeksu całkowitego od -127 do +127:
Podstawiając nasze — każdy punkt siatki to indeks × 0.0748:
Żeby przyciągnąć każdą wagę do najbliższego punktu siatki, przypomnij sobie, że krok 1 tylko zbudował siatkę; tutaj zachodzi właściwa kompresja pojedynczej wagi. Dla każdej wagi w grupie policz jej indeks:
To daje całkowity indeks najbliższego punktu siatki — ta sama mechanika zaokrąglania do najbliższej co w artykule o zaokrąglaniu binarnym: wybierz najbliższą reprezentowalną wartość, remisy rozstrzygaj ku parzystej. Jedyna różnica jest taka, że zbiór reprezentowalnych wartości jest teraz znacznie mniejszy i jawnie wyliczony. Zapisz jednobajtową liczbę całkowitą (albo 4 bity dla int4); wspólne podróżuje obok, zapisane raz na grupę, więc jego koszt amortyzuje się na wszystkie wagi w grupie. Dla naszych pięciu wag z :
| Waga | Zapisane (wartość int8) | ||
|---|---|---|---|
3.1416 | 42.0 | 42 | 42 |
-1.7 | -22.7 | -23 | -23 |
0.0234 | 0.31 | 0 | 0 |
1.5 | 20.05 | 20 | 20 |
-9.5 | -127.0 | -127 | -127 |
Pięć wag fp32 (20 bajtów) staje się pięcioma wartościami int8 plus jedną skalą fp32 (łącznie 9 bajtów) — 2,2× mniej, a oszczędność rośnie tylko wraz z rozmiarem grupy.
Wybierz wagę, by zobaczyć pełny cykl kwantyzacja–przyciągnięcie–dekwantyzacja na tych samych pięciu wartościach ze wzoru powyżej. Zielone znaczniki to siatka int8 (indeks × S dla każdego indeksu od −127 do +127). Niebieska kropka to oryginalna waga fp32; czerwony znacznik to punkt siatki, do którego się przyciąga. Wiersz przepływu pokazuje arytmetykę z kroku 1 i 2: podziel przez , zaokrąglij do najbliższej liczby całkowitej (to właśnie zostaje zapisane), a potem przy odczycie pomnóż z powrotem przez . Zatem 3.1416 / 0.0748 ≈ 42.0 zaokrągla się do 42 i rekonstruuje do 42 × 0.0748 ≈ 3.142 — prawie identycznie. Spróbuj 0.0234, żeby zobaczyć, co się dzieje, gdy maleńka waga ulega niedomiarowi do punktu siatki 0.
Żeby zrekonstruować wagę, sprzęt odczytuje małą liczbę całkowitą i stosuje odwrotność:
gdzie to zapisana liczba całkowita, a to zmiennoprzecinkowa skala. Różne grupy wag dostają różne — dlatego ta sama wartość int8 42 w dwóch różnych kanałach może dekodować się na dwie różne liczby rzeczywiste.
Odtworzenie polega na zamianie liczby całkowitej na zmiennoprzecinkową i pomnożeniu przez skalę. Implementacja może łączyć te operacje i używać fp16, bf16 lub fp32.
Bez obcinania zakresu zaokrąglenie do najbliższego punktu siatki zmienia wartość najwyżej o , pomijając błędy arytmetyki przy obliczaniu skali. Wartości o module mniejszym niż stają się zerem. To granica błędu pojedynczej liczby, a nie zmiany predykcji modelu.
Gdzie to faktycznie działa
W praktyce prawdziwe wdrożenia idą przez tę arytmetykę jedną z dwóch ścieżek:
- Całkowitoliczbowe mnożenie macierzy: kwantyzujemy wagi i aktywacje, sumujemy iloczyny całkowitoliczbowe, a następnie stosujemy odpowiednie skale i konwersję wyniku.
- Kwantyzacja samych wag: aktywacje pozostają zmiennoprzecinkowe, a wagi odtwarzamy na potrzeby obliczeń, często wewnątrz połączonego kernela.
Szczegóły zależą od ziarnistości i punktów zerowych. Jedną skalę można wyłączyć przed sumę tylko wtedy, gdy jest wspólna dla jej składników. Obliczenia całkowitoliczbowe odtwarzają wybrane przybliżenie kwantowane, a nie dokładnie oryginalny model fp32.
Wybór ziarnistości
Ziarnistość określa, które wagi dzielą jedną skalę:
- Na tensor: jedna skala dla całego tensora; mało metadanych, ale rozdzielczość może być zbyt mała, gdy zakres wyznaczają wartości odstające.
- Na kanał: jedna skala na kanał wyjściowy, uwzględniająca różnice między kanałami.
- Na grupę: jedna skala na blok wag. Mniejsze grupy mogą poprawić lokalną rozdzielczość, ale wymagają więcej metadanych.
Podział na kanały wynika z wymiaru wyjściowego warstwy. Kwantyzacja grupowa wymaga też rozmiaru grupy. Formaty i implementacje mają różne wartości domyślne, dlatego sprawdzaj specyfikację checkpointu i porównuj jakość oraz rozmiar obsługiwanych wariantów.
Dlaczego to działa
Dla idealnego kwantyzatora jednorodnego bez obcinania zakresu błąd skalarny jest ograniczony przez . Wzór na wariancję dodatkowo zakłada jednostajny rozkład błędu w tym przedziale; nie jest gwarancją dla dowolnych wag. Zaokrąglanie jest nieliniowe i nie zachowuje automatycznie odległości ani jakości modelu.
Odstępy normalnych liczb zmiennoprzecinkowych są równe w przedziałach między kolejnymi potęgami dwójki i podwajają się przy przejściu do następnego przedziału. Jednorodna kwantyzacja całkowitoliczbowa używa stałego kroku w grupie. Rozdzielczość blisko zera zależy więc od skali grupy, a nie wykładnika każdej wartości.
Zmieniaj zakres, aby porównać siatki. Odstępy zmiennoprzecinkowe rosną skokowo wraz z wartością; każdy wiersz kwantyzacji całkowitoliczbowej używa równych odstępów w pokazanym zakresie.
Obraz przechowywania wygląda wtedy tak przy int4 z rozmiarem grupy 64:
- 4 bity na wagę = 0,5 bajta
- plus jedna skala fp16 na 64 wagi ≈ 2 bajty / 64 = 0,031 bajta/wagę
- razem ≈ 0,53 bajta/wagę
Dlatego „int4” w praktyce podaje się jako „0,5 bajta na parametr” — narzut jest realny, ale mały.
Kwantyzacja klasyfikatora MNIST
Żeby uczynić to konkretnym na modelu, który już poznaliśmy, zastosujmy ten sam przepis do pierwszej warstwy Dense klasyfikatora MNIST z wcześniejszej części serii — warstwy Dense(128, input_shape=(784,)) z macierzą wag (784, 128) w fp32. Wybierzmy ziarnistość na kanał: 128 grup, po jednej na kanał wyjściowy, każda zawierająca 784 wagi. Dla każdego kanału policz . Jeśli największa co do modułu waga kanału 0 to 0.234, to , a siatka tego kanału to — 255 punktów rozstawionych co 0.00184, rozciągniętych dokładnie na zakres kanału. Kanał 1 dostaje inne , więc ta sama wartość int8 42 dekoduje się na — inną liczbę rzeczywistą dla każdego kanału:
import keras
import numpy as np

model = keras.models.load_model('mnist_classifier.keras')
W = model.layers[0].kernel.numpy()         # (784, 128), fp32
print(W.shape, W.dtype, W.nbytes)          # (784, 128) float32 401408

INT8_MAX = 127

# Per-channel int8: one scale per output channel (128 channels)
scales = np.maximum(np.abs(W).max(axis=0) / INT8_MAX, np.finfo(np.float32).tiny)  # (128,), fp32

# Quantize: divide by scale (broadcasts), round to nearest int, cast to int8
W_q = np.round(W / scales).astype(np.int8) # (784, 128), int8

# Dequantize on read: cast to fp32, multiply by per-channel scale
W_back = W_q.astype(np.float32) * scales

# Storage: 100,352 bytes (int8 weights) + 128 * 4 = 512 bytes (scales)
# vs original 401,408 bytes — ~4× smaller, scale overhead ~0.13%
Macierz pierwszej warstwy zmniejsza się z 401 408 bajtów do 100 352 bajtów plus 512 bajtów skal. W_back odtwarza przybliżenie float32 i samo nie oszczędza pamięci. Aby zmierzyć jakość, przypisz odtworzone wagi do kopii modelu i oceń ją na odłożonych danych; ten fragment nie przedstawia takiego testu.
Zastosuj ten sam przepis do wag (128, 10) drugiej warstwy, a mamy obraz całego modelu:
| Warstwa | Kształt | Wagi fp32 | Wagi int8 | Skale na kanał | Razem int8 |
|---|---|---|---|---|---|
| Dense 1 | (784, 128) | 401 408 B | 100 352 B | 128 × 4 = 512 B | 100 864 B |
| Dense 2 | (128, 10) | 5 120 B | 1 280 B | 10 × 4 = 40 B | 1 320 B |
| Razem | 406 528 B (~397 KiB) | 102 184 B (~100 KiB) |
Dwie macierze zajmują 406 528 bajtów w fp32 i 102 184 bajty w tej reprezentacji int8, ze skalami. Zachowanie 138 biasów w fp32 dodaje po 552 bajty. Parametry zajmują więc około 407 KB wobec 103 KB, czyli prawie cztery razy mniej. Oszczędność podczas działania zależy od tego, czy implementacja przechowuje i wykorzystuje skompresowane wagi.