在 MNIST 上训练一个真正的网络
在上一篇文章中,我们介绍了训练神经网络的主要步骤和概念:前向传播、损失函数、反向传播、梯度下降、学习率、小批量和梯度消失。我们用一个只有 2 个参数的直线拟合例子来说明这些过程:给定输入 ,预测 。这是回归:网络输出一个连续取值的数,例如价格或温度。我们用均方误差作为损失函数,衡量预测值与目标值的偏差。
这篇文章讨论分类。给定一张手写数字图像,网络会为各个类别分配概率,并把概率最高的数字作为预测结果。我们使用经典的 MNIST 数据集,其中有 70,000 张数字 0 到 9 的手写图像。
我们先用 NumPy 从零实现前向传播、损失函数、反向传播和梯度下降,逐步查看训练中的计算。然后用 Keras 实现同一个模型。这个高层框架可以自动完成这些操作。Keras 可以使用 PyTorch、TensorFlow 或 JAX 作为后端,由它们负责 GPU 加速和自动梯度计算,Keras 则提供易用的接口。我们的 NumPy 实现每次处理一张图像,便于跟踪每一步。Keras 能高效处理整个批次,并在更大的任务中使用 GPU。
数据集
MNIST 是一个包含 70,000 个手写数字(0–9)的集合——60,000 个用于训练,10,000 个用于测试。每张图像是 28×28 像素的灰度图。
这里是几个例子:
图像和标签以 NumPy 数组的形式存放。我们来看看原始数据。
# 60,000 images, each a matrix of 28×28 pixels
>>> train_images.shape
(60000, 28, 28)

# A single image: 28 rows × 28 columns of pixel values (0–255)
>>> train_images[0].shape
(28, 28)

>>> train_images[0].dtype
dtype('uint8')

# 60,000 labels: first image is "5", second is "0", ...
>>> train_labels
array([5, 0, 4, ..., 5, 6, 8], dtype=uint8)

# 10,000 test images, same 28×28 matrices
>>> test_images.shape
(10000, 28, 28)

# 10,000 labels for test images
>>> test_labels
array([7, 2, 1, ..., 4, 5, 6], dtype=uint8)
28×28 网格中的每个值表示一个像素的强度。每个像素占一个字节(8 位),可以表示 个值,即 0 到 255。在原始数据中,0 表示黑色,255 表示白色,所以 MNIST 的数字是黑底上的白色笔画。这是灰度图像的一种常见存储格式。每通道 8 位的 RGB 图像用三个值表示一个像素(红、绿、蓝),而 MNIST 只需要一个值。
这张 28×28 的数字网格就是图像——每个数字直接对应一个灰阶。点击下面任意一个像素并输入新值,看看效果。用那个开关可以在原始表示(黑底白字)和反色视图(白底黑字,更易读)之间切换:
切换视图时,放大网格中的像素值不变,始终显示数组中存储的原始数据。开关只改变这些值的显示颜色:值为 255 的像素在原始模式下显示为白色,在反色模式下显示为黑色。网络接收的图像数据就是这 784 个数。
每张图像都带一个标签——它所代表的数字(0–9)。这两个数组合起来——图像和标签——就是网络将要学习的全部。任务很简单:给定一张 28×28 的图像,预测它是哪个数字。这是一个有 10 个类别的分类问题——我们要构建的网络叫作多类别分类器。在分类里,一个类别就是一个可能的标签,是模型可以选的一个类目。我们有 10 个类别(数字 0–9),每个数字大约 6,000 个训练样本(并非完全均匀——数字 1 有 6,742 个样本,而数字 5 只有 5,421 个)。
从回归到分类
从上一篇文章的回归任务()走到数字分类,我们需要:
- 输出层——我们需要 10 个神经元(每个数字对应一个),再用激活函数 softmax 把它们的分数转换成概率分布。
- 损失函数——均方误差衡量预测值与目标值的距离;这里使用交叉熵损失,它取决于模型分配给正确类别的概率。
- 梯度——梯度公式需要与新的损失函数对应。交叉熵与 softmax 结合后,可以得到一个简单的梯度公式。
- 隐藏层激活——层与层之间需要非线性激活函数,网络才能学到复杂模式。我们使用 ReLU,它也出现在上一篇文章的神经元和层的示例中。
核心算法——前向传播、反向传播、梯度下降、小批量——保持不变。我们逐一过一遍。
输出层与 softmax
在回归里,网络输出一个数字。在分类里,它需要从一组类别中做选择——我们这里是从 10 个数字里挑一个。网络得说出「我认为这是 2」,还要带上某种确信程度。
我们的做法是给输出层配 10 个神经元——每个数字一个。每个神经元产生一个分数,叫作 logit(这名字来自逻辑回归里的「log-odds」,但实践中它就是指「softmax 之前的原始分数」),表示网络有多强地相信输入就是那个数字。分数越高,信心越足。
有 10 个数字,我们的输出层就产生 10 个 logit——每类一个。 为了让例子和可视化更简单,下面的代码里我们只用 3 个类别(数字 0、1、2)——数学完全一样,只是要看的数少一些。
对某张输入图像,输出可能长这样:
图像进去,网络让它穿过各层,出来 3 个数字——每个数字一个。数字 2 拿到了最高分(4.2),所以那就是网络的预测。用代码写:
logits = [1.5, -0.3, 4.2]
#          0     1    2

# The network's guess: digit 2 (highest logit = 4.2)
# argmax returns the index of the largest value, not the value itself
prediction = np.argmax(logits)  # 2
原始 logit 不是概率:它们可以为正或为负,总和也不一定为 1。我们用 softmax 函数把它们转换成概率分布。图像分类器和语言模型都使用这个函数;在语言模型中,它把词表中各 token 的分数转换成下一个 token 的概率:
为什么叫「softmax」?因为它是 max 的柔化版本。硬性的 max 只会挑出最大值、无视其余一切——[0, 0, 1]。当某个 logit 一枝独秀时,softmax 做的几乎是同一件事;但当各 logit 大小相近时,其他值也会拿到可观的权重。对比一下:
| logits | 硬 max | softmax |
|---|---|---|
| [1.0, 8.5, 1.0] | [0, 1, 0] | [0.1%, 99.9%, 0.1%] |
| [3.0, 3.5, 3.0] | [0, 1, 0] | [27.4%, 45.2%, 27.4%] |
| [3.0, 3.0, 3.0] | 未定义(平手) | [33.3%, 33.3%, 33.3%] |
硬 max 给出二值答案——赢家通吃。softmax 给出一个平滑分布,随着输入变化而连续改变。当模型不确定时(logit 彼此接近),softmax 会反映出这种不确定。当模型确信时(某个 logit 大得多),softmax 逼近硬 max。这种平滑的行为也正是反向传播得以工作的原因——你能穿过 softmax 计算梯度,因为它处处可导。
硬 max 无法提供有用的梯度,因为它的输出在跳变之间保持不变。softmax 则是可导的,可以用来反向传播梯度。从数学上说,有限的 logit 对应的概率严格介于 0 和 1 之间,但浮点运算可能把极小的概率舍入为 0。在下面的组件中,试着把前两个 logit 设为 0,把第三个设为一个很大的数。
softmax 分三步走(用我们的示例 logits [1.5, -0.3, 4.2]):
- 把 提升到每个 logit 的幂次——因为对任意 都有 ,这会把每个值(哪怕是负的)都变成正数: 、、
- 把所有正值加起来——
- 把每个值除以这个和——、,依此类推
这就把这串数归一化到恰好加起来等于 1——一个正经的概率分布。
softmax 利用了指数函数的放大效应:logit 之间的差值会转换为指数值之间的比例。,而 、。4.2 与 1.5 相差 2.7,取指数后相差约 15 倍。再除以总和,数字 2 得到 92.7% 的概率。这使概率集中在分数最高的类别上,但高概率并不保证预测正确。
你可以用温度参数 来控制这种放大效应。公式变成:
在取指数之前先除以 ,会缩放 logit 之间的差距。试着拖动 T 滑块:
- T → 0(低温)——差距被放大,分布变得尖锐。最高的 logit 拿到接近 100%。这逼近硬 max。
- T = 1——标准 softmax。除以 1 什么都不改变,所以等同于根本没有 。
- T → ∞(高温)——差距被压平,所有 logit 变得相近,分布趋于均匀(各 33.3%)。
语言模型在采样下一个 token 时也使用温度参数。低温让概率集中在最可能的 token 上,使输出更容易预测。高温让概率分布更均匀,增加选择的多样性,但有时也会降低文本的连贯性。
我们会这样用 Python 实现 softmax:
def softmax(logits):
    # Subtract max for numerical stability (doesn't change the result,
    # but prevents overflow when computing e^z for large values)
    exp = np.exp(logits - np.max(logits))
    return exp / np.sum(exp)

probs = softmax(logits)
# [0.063, 0.010, 0.927]
#   0      1      2
# The highest probability is 92.7% for digit 2
注意,我们还减去了最大的 logit。这是因为 softmax 需要计算 ,而指数函数增长很快。如果某个 logit 为 1000,那么 会超出浮点数的表示范围,溢出为无穷大:
>>> import numpy as np
>>> np.exp(1000)
inf                    # overflow — can't compute

>>> np.exp(1000) / (np.exp(1) + np.exp(2) + np.exp(1000))
nan                    # infinity / infinity = undefined
在取指数之前把最大的 logit 从所有值里减掉,会把最大值挪到 0,其余全都变成负的。相对顺序被保住了—— 依然最大,因为 永远小于 1——所以算出来的概率是一样的:
>>> logits = [1, 2, 1000]
>>> max(logits)
1000

>>> [z - max(logits) for z in logits]
[-999, -998, 0]        # largest becomes 0, others become negative

>>> np.exp([-999, -998, 0])
array([0., 0., 1.])    # e⁰ = 1 is the largest (e^negative is always < 1), no overflow
从数学上可以看出,减与不减得到的概率完全相同:
被约掉了,而我们避免了计算任何危险的大指数。这是每个 softmax 实现里都能见到的标准数值稳定性技巧。
ReLU:隐藏层的激活函数
我们已经讲过一个激活函数——输出层上的 softmax,它把 logit 变成概率。但我们在隐藏层上也需要一个激活函数。上一篇文章训练出来的模型()是单个线性运算——没有激活函数,也没有隐藏层。
那篇文章还解释了为什么不加激活函数地堆层毫无意义:一连串线性运算会坍缩成一个线性运算。要学到复杂模式而不只是直线,层与层之间就需要非线性。 上一篇文章把激活函数作为解法引入,并在神经元组件里展示了几个选项(sigmoid、感知机、ReLU)。
我们使用 ReLU(Rectified Linear Unit,修正线性单元),一种常见的隐藏层激活函数:
它把正值原样放行,把负值截成零。拖动下面的滑块——当加权和为正时(绿色),值直接通过。当它为负时(红色),输出被截到 0:
同时调两个滑块就能看出这种行为——起作用的是加权和 w × x,而不是单个值。试着把输入和权重都设成负数:乘积是正的,所以 ReLU 会放行。只有当乘积本身为负时,它才截成零。
ReLU 的导数很简单,便于进行反向传播。计算损失梯度时,激活函数的导数是链式法则乘积中的一个因子。在上一篇文章中,隐藏层某个权重的梯度如下:
dw11 = x1 * relu_deriv(z1) * v1 * 2 * error
# ↑ activation derivative — one factor in the chain损失梯度是计算路径上各局部导数的乘积。relu_deriv 是其中一个因子:值为 1 时,梯度不变;值为 0 时,神经元无法从这个输入获得梯度。如果一个神经元对所有训练输入都保持不激活,它就可能完全停止学习,这就是 ReLU 死亡问题。sigmoid 的限制则不同:它的导数最大为 0.25,当激活值接近 0 或 1、进入饱和区时,导数趋近于零。这些较小的因子可能在多层之间累积。
就梯度而言,为什么 sigmoid 比 ReLU 差?
sigmoid 的导数是 。既然 sigmoid 输出的是 0 到 1 之间的值 ,那这就是 ——它在 时(即 处)取到最大:。当 朝任一方向远离 0 时,sigmoid 就朝 0 或 1 饱和,导数缩向 0。
对于五个 sigmoid 层,仅激活函数导数的乘积就至多为 。完整梯度还受权重矩阵影响,但这些较小的导数因子可能使前面几层难以学习。ReLU 对活跃神经元的导数为 1,因此在激活这一步不会缩小梯度。
于是我们的网络有两个不同的激活函数,各司其职:隐藏层里的 ReLU(引入非线性,好让网络学到复杂模式)和输出层上的 softmax(把原始分数转换成概率)。
损失函数
现在我们需要一个损失函数。上一篇文章里我们用的是均方误差——预测与目标之差的平方,在所有数据点上取平均。那对回归来说说得通:预测是一个数、目标是一个数,我们希望它们靠近。
对分类,我们用交叉熵损失。 想法很简单:取模型分配给正确类别的那个概率的负对数。
概率越低,损失越高:
- 模型说有 95% 的把握是对的:——损失低,预测好
- 模型说 60%:——损失中等,信心不够
- 模型说 1%:——损失很高,几乎完全错了
为什么使用负对数?
- 当 时,损失为零:。
- 当 趋近于 0 时,损失无限增大,从而惩罚那些给正确类别分配极低概率的预测。
- 导数为 ,所以相同幅度的概率变化在接近 0 时对损失的影响远大于接近 1 时。
下面并排展示了 和 的曲线。两条曲线在接近 0 时都很陡。负号使曲线沿水平轴翻转,得到非负的损失值;正确类别的概率越高,损失越小。
例如,损失对 的导数在 时为 ,在 时约为 。这只是反向传播中的一个因子。要计算损失对 logit 和权重的梯度,还需要 softmax 以及前面各层的导数。下面会推导这些内容。
拖动下面的滑块,观察黄点在 曲线上的移动:
正确类别是数字 2。提高它的概率,损失就趋近于零;降低它的概率,损失就会迅速增大。
在 Python 里损失函数长这样。它接收模型预测的概率和真实标签(正确类别的下标——0、1 或 2),返回分配给该类别的那个概率的 :
def cross_entropy_loss(probs, label):
    # label is the index of the correct class
    p_correct = probs[label]       # e.g. probs[2] = 0.94
    return -np.log(p_correct)      # -log(0.94) = 0.062

# Model is confident and correct → low loss
cross_entropy_loss([0.05, 0.01, 0.94], label=2)   # 0.062

# Model is uncertain → moderate loss
cross_entropy_loss([0.30, 0.30, 0.40], label=2)    # 0.916

# Model is confident but wrong → high loss
cross_entropy_loss([0.80, 0.15, 0.05], label=2)    # 2.996
损失与准确率
训练过程中我们同时追踪损失和准确率——它们相关,但不是一回事。
准确率衡量预测正确的比例。每次预测只计对错,置信度不影响计数。给正确类别分配 0.51 或 0.99 的概率,都算一次正确预测。但两者的损失不同:前者为 0.67,后者为 0.01。
损失(交叉熵)取决于分配给正确类别的概率——概率越低,惩罚越大。两个模型可以有相同的准确率,但如果其中一个给正确类别分配了更高的概率,它们的损失就会不同。
在真实的训练日志里,长这样:
Epoch 1/10  — accuracy: 0.5117 — loss: 1.7934 — val_accuracy: 0.7520 — val_loss: 1.3155
Epoch 2/10  — accuracy: 0.7806 — loss: 1.0726 — val_accuracy: 0.8377 — val_loss: 0.8382
Epoch 5/10  — accuracy: 0.8627 — loss: 0.5560 — val_accuracy: 0.8798 — val_loss: 0.4901
在第 1 个 epoch,accuracy: 0.5117 表示模型在 51% 的训练图像上预测出了正确的数字——对每张图像,把概率最高的那个类别与真实标签比较,然后统计正确预测的比例。这已经远高于在 10 个类别里随机猜测的 10% 基线,但仍有一半图像是错的。
损失为 1.79,说明模型经常给正确类别分配较低的概率。它可能选对了类别,但置信度较低(例如 0.3 而不是 0.9);也可能给错误类别分配了很高的概率。少量高置信度的错误预测,就可能大幅拉高平均损失。
准确率和损失的这种差别,意味着它们并不总是同向变化:
- 损失下降,准确率不动——模型对那些本来就预测正确的样本变得更有信心了。比如模型已经把一张 7 的图像预测成「7」,但它的信心从 0.4 涨到 0.9,准确率不变(本来就对),损失却明显下降。
- 准确率上升,损失也上升——模型答对了更多,却在答错的那些上变得过度自信。想象模型修好了 5 张原本判错的图像(准确率变好),但同时在 2 张判错的图像上变得非常自信(0.95)。这 2 个自信错误带来的损失,可能盖过那 5 个新增正确带来的改善。
- 两者都不动——模型卡住了。权重在变,但预测并没有实质性不同。这常发生在学习率过小、或模型已经到达其容量上限时。
正常训练时,这两个指标通常一起改善,上面的日志就是一个例子。如果它们的变化方向不一致,可以检查模型是否在错误预测上变得更加自信。
梯度
上一篇文章里我们看到,训练需要计算损失对每个参数的梯度——那个告诉我们该往哪个方向推动每个权重以减小误差的导数。对拟合直线的例子,我们展示了我们是怎么得到 MSE 梯度公式的。 现在我们需要交叉熵损失对 logit(softmax 之前的原始分数)的梯度。
下面是输出层里单个神经元的样子——logit 是施加激活函数之前的加权和:
softmax 本身没有可学习的参数,它只把 logit 转换成概率。可学习的权重属于计算加权和、输出 logit 的神经元。我们利用损失对 logit 的梯度,计算输出层权重和隐藏层的梯度,然后由优化器根据这些梯度更新参数。
我们在上一篇文章中得到的 MSE 公式结构清晰:dw = 2 * mean(error * x)——误差乘输入,再在样本上取平均。
每一部分都来自把链式法则用到损失函数上。 现在我们要为交叉熵配 softmax 做同样的事。我们分三部分来推:
- 穿过 softmax 的梯度(输出层)——推导交叉熵 + softmax 对 logit 的梯度,得到干净的 公式
- 穿过 ReLU 的梯度(隐藏层)——展示梯度如何流经隐藏层的激活函数
- 把它们串起来——把两部分接成完整的反向传播
完整的前向链条是:输入 → 隐藏层(权重 + ReLU)→ logit → softmax → 概率 → 交叉熵 → 损失。 反向传播反着走——我们从损失出发,用链式法则一路回穿交叉熵、softmax,再到隐藏层。
下面的数学比上一篇文章里的 MSE 梯度更繁一些——要用这个结果,并不需要跟住每一步。如果你愿意,可以直接跳到最终公式和代码。但如果你想看看它从哪来,这里是一步步的推导。
穿过 softmax 的梯度(输出层)
第 1 步:损失的导数。 损失是 ,其中 是正确类别。 的导数我们已经知道:是 。所以:
第 2 步:softmax 的导数。我们已经知道损失对 的导数,但需要的是损失对 logit 的导数,因为 logit 才是这一层根据权重计算出的结果。因此,还需要知道 的变化如何通过 softmax 影响 。
softmax 是 。用商的求导法则,有两种情况:
若 (改变正确类别的 logit):
这看起来像 sigmoid 的导数——确实就是。每个 softmax 输出在局部都像一个 sigmoid。
若 (推动另一个 logit):
分子的第一项是 0,因为 不依赖 。增大一个 logit 总会压低其他概率——它们必须加起来等于 1。
第 3 步:链式法则。 把两个导数乘起来:
- 对正确类别():
- 对错误类别():
结果
把这些导数组合起来,就得到交叉熵损失对每个 logit 的梯度:
实践中怎么算?用 ,即 one-hot 向量——除了正确类别处是 1,其余全是 0。既然正确类别处 、其他地方 ,那么用 减去 就给出正确类别的 和其余的 ——正是上面那个分段公式:
在 Python 里就一行:
grad_z = probs - one_hot_label # gradient w.r.t. logits损失对 logit 的梯度,就是预测概率向量减去 one-hot 目标向量。
我们用 3 个类别的具体例子看看这意味着什么。如果模型输出的概率是 [0.06, 0.01, 0.93],而正确类别是 2:
- 目标(one-hot)是
[0, 0, 1]——全部概率都该在类别 2 上 - 梯度是
[0.06 − 0, 0.01 − 0, 0.93 − 1]=[0.06, 0.01, −0.07]
符号告诉你方向:类别 2 拿到一个负梯度(−0.07),意思是「把这个 logit 往上推,提高它的概率」。类别 0 和 1 拿到正梯度,意思是「把这些 logit 往下压」。大小告诉你推多少——类别 0(0.06)需要的修正比类别 1(0.01)更大,因为漏到它那里的概率更多。
注意 是对 logit 的梯度,不是对权重的。记住,输出神经元算的是 (logit),然后 softmax 把它转成概率。所以从损失到权重的完整链条有两部分:
第一部分()就是我们刚推出来的——损失如何随 logit 变化。第二部分()是 对 的导数,也就是输入本身。两者相乘就给出权重梯度:
grad_z = probs - one_hot_label       # part 1: loss → logits (p - y)
grad_W = np.outer(grad_z, x)         # part 1 × part 2: logits → weights
grad_b = grad_z                       # bias gradient (same as grad_z)
grad_input = W.T @ grad_z            # gradient to pass to the previous layer
grad_input = W.T @ grad_z 是传给前一层的梯度信号。那一层接着做同样的事——只不过用的是 ReLU 而不是 softmax。
穿过 ReLU 的梯度(隐藏层)
隐藏层算的是 ,然后施加 ReLU:。我们在上一篇文章里推导过——当梯度从下一层传来(grad_output)时,链式法则把它乘上 ReLU 的导数:
如果这个神经元是活跃的(),梯度原样通过。如果它不活跃(),梯度被归零。然后,跟输出层一样,我们继续这条链,得到权重的梯度:
grad_z = grad_output * (z > 0)       # multiply by ReLU derivative (0 or 1)
grad_W = np.outer(grad_z, x)         # chain rule: gradient for weights
grad_b = grad_z                       # gradient for biases
grad_input = W.T @ grad_z            # pass to the previous layer
把它们串起来
完整的反向传播从损失出发,链式地穿过每一层:
- 输出层: → 计算
grad_W、grad_b,把grad_input往回传 - 隐藏层:接收
grad_input,乘上 ReLU 的导数 → 计算grad_W、grad_b,把grad_input往回传 - 对任何额外的隐藏层重复这一过程
每一层的套路都一样——唯一的差别是激活函数的导数(softmax 还是 ReLU)。下面是我们这个网络(一个隐藏层 + 输出层)的完整反向传播:
# Forward pass (for reference)
z1 = W1 @ x + b1              # hidden layer: weighted sum
h = relu(z1)                   # ReLU activation
z = W2 @ h + b2                 # output layer: hidden → logits
p = softmax(z)                  # softmax: logits → probabilities
loss = -np.log(p[label])        # cross-entropy loss

# Backward pass: chain rule from loss back to weights
# 1. Output layer gradient (softmax + cross-entropy)
grad_z2 = p.copy()
grad_z2[label] -= 1             # p - y

grad_W2 = np.outer(grad_z2, h)  # weight gradient
grad_b2 = grad_z2               # bias gradient
grad_h = W2.T @ grad_z2         # pass gradient to hidden layer

# 2. Hidden layer gradient (ReLU)
grad_z1 = grad_h * (z1 > 0)     # multiply by ReLU derivative

grad_W1 = np.outer(grad_z1, x)  # weight gradient
grad_b1 = grad_z1               # bias gradient

# 3. Update all weights
W2 -= lr * grad_W2
b2 -= lr * grad_b2
W1 -= lr * grad_W1
b1 -= lr * grad_b1
下面 NumPy 代码里的 HiddenLayer.backward() 和 OutputLayer.backward() 要实现的正是这些——同样的步骤,只是包进了类里。
下面的组件在一个小网络上演示这套计算:输入为 2×2 的简化图像,隐藏层有 2 个神经元,输出层有 3 个类别。选择输入并指定正确数字,便可逐步查看输出误差 grad_z2 = p − y、隐藏层误差 grad_z1,以及权重梯度矩阵 grad_W2 和 grad_W1。点击 Apply update,即可观察执行 W -= lr * grad_W 后损失的变化。
小批量与 epoch
上一篇文章里我们引入了随机梯度下降(SGD):与其把所有数据点都过一遍、逐个收集梯度再平均成一次更新,不如把数据切成小的小批量,每处理完一个批次就更新一次权重。 批大小无非就是「你在做一次权重更新之前,会在多少个样本上取平均」——同样的梯度公式、同样的平均,只是样本数不同。
正如我们在上一篇文章里看到的(5 个点中每批取 2 个),这会引入一些噪声——基于 2 个样本的梯度不会与基于全部 5 个的梯度指向完全相同的方向——但更新频繁得多,这一点绰绰有余地补偿回来。
来看看在我们 60,000 张训练图像上,这会怎么展开。
不用小批量(全批量梯度下降)时,把数据过一遍长这样:
- 让全部 60,000 张图像做前向传播
- 计算在全部 60,000 个预测上平均的损失
- 反向传播得到梯度(在所有图像上平均)
- 更新一次权重
那是看完每一张图像之后才有的1 次权重更新。梯度非常准(它考虑了整个数据集),但在处理完全部 60,000 张图像之前,模型什么都学不到。
用大小为 32 的小批量时,同样这一遍长得很不一样:
- 取图像 1–32,前向传播,算损失,反向传播,更新权重
- 取图像 33–64,前向传播,算损失,反向传播,更新权重
- 取图像 65–96,前向传播,算损失,反向传播,更新权重
- …… 对全部 个小批量重复
同样遍历一遍数据,这里会进行 1,875 次权重更新。
每个梯度的噪声更大,因为它只基于 32 张图像,而不是 60,000 张;但模型会更新权重 1,875 次,而不是一次。它在遍历数据的过程中就开始调整参数。极端情况是批大小为 1:每处理一张图像就更新一次,每个 epoch 共更新 60,000 次,但每次梯度只来自一个样本。
处理完全部 1,875 个小批量后,模型恰好看过每张训练图像一次。这样完整遍历一次数据集,称为一个 epoch。我们通常训练多个 epoch,每一轮都让模型有机会继续调整权重。
每个 epoch 的批次数由数据集大小和批大小决定:
在每个 epoch 开始时,我们把数据打乱,好让小批量每次都不一样——这能防止模型去学数据顺序里的规律,而不是图像本身的规律。
你可能想问,epoch 数该怎么选。这取决于模型在没见过的数据上何时不再提升。epoch 太少,模型学得不够;太多,它就开始死记训练数据而不是泛化。实践中会把 epoch 上限设得高一些,让早停来决定何时真正停下——它监控验证准确率,在其走平时中止训练。
如果我们把训练跑 5 个 epoch,就会得到:
也就是说梯度下降跑了 9,375 次——每次处理一批 32 张图像,计算平均梯度,并推动网络里的每一个权重。
搭建模型
我们来搭一个接收 784 个输入(像素)、输出 10 个类别概率(每个数字一个)的模型。我们会沿用上一篇文章里的 HiddenLayer 结构——一个权重矩阵 、一个偏置向量 和一个激活函数:
上一篇文章里,我们的模型是一个线性方程——只有 2 个参数,没有层,也没有激活函数。我们直接算出梯度,不需要往后传任何东西,因为它后面什么都没有。现在有了多层,每一层都要计算自己的梯度并且把梯度信号传给它前面的那一层——这就是反向传播过程。
链式法则的数学和我们上面推的一样,只是包进了一个类里:
class HiddenLayer:
    def __init__(self, n_inputs, n_neurons):
        # We use initialization proposed by Kaiming He et al. (2015):
        # random weights scaled by sqrt(2/n) — keeps activations balanced
        # for ReLU networks (too large → explode, too small → vanish)
        self.W = np.random.randn(n_neurons, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_neurons)

    def forward(self, x):
        self.x = x                          # save for backward pass
        self.z = self.W @ x + self.b        # weighted sum
        self.out = np.maximum(0, self.z)    # ReLU activation
        return self.out

    def backward(self, grad_output):
        # ReLU derivative: 1 if z > 0, else 0
        grad_z = grad_output * (self.z > 0)

        # Gradients for this layer's parameters (chain rule)
        self.grad_W = np.outer(grad_z, self.x)   # ∂loss/∂W = grad_z ⊗ x
        self.grad_b = grad_z                      # ∂loss/∂b = grad_z

        # Gradient to pass to the previous layer (chain rule continues)
        return self.W.T @ grad_z                  # ∂loss/∂x = Wᵀ · grad_z

    def update(self, lr):
        # Gradient descent: update parameters
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
这一层有三个方法:
forward:计算 ,施加 ReLUbackward:接收来自下一层的梯度,用链式法则算出局部梯度,并返回要传给上一层的梯度update:施加梯度下降——从每个参数里减去lr × 梯度
我们把 backward 和 update 分开,是为了能在一个小批量上先累积梯度、再做更新——就跟 Keras 一样。
末尾的 grad_input 是往回传给前一层的梯度信号——链式法则就是这样在网络里「流动」的,正如上一篇文章那张图所示:
Forward:   x ──▶ Layer 1 ──▶ Layer 2 ──▶ Output ──▶ Loss
Backward:  x ◀── Layer 1 ◀── Layer 2 ◀── Output ◀── ∂L
每一层从右边收到一个梯度,算出自己参数的梯度(用来更新 和 ),再把剩下的梯度往左传。
现在我们再造一个用 softmax 而不是 ReLU 的输出层(因为最后一层要产出概率,而不是 ReLU 激活值):
class OutputLayer:
    def __init__(self, n_inputs, n_classes):
        self.W = np.random.randn(n_classes, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_classes)

    def forward(self, x):
        self.x = x
        self.z = self.W @ x + self.b
        # Softmax instead of ReLU
        exp = np.exp(self.z - np.max(self.z))
        self.probs = exp / np.sum(exp)
        return self.probs

    def backward(self, label):
        # Combined softmax + cross-entropy gradient: p - y
        grad_z = self.probs.copy()
        grad_z[label] -= 1

        # Same gradient formulas as Layer
        self.grad_W = np.outer(grad_z, self.x)
        self.grad_b = grad_z
        return self.W.T @ grad_z

    def update(self, lr):
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
现在可以把网络装起来了。先从一个简单架构开始——一个 128 个神经元的隐藏层:
# 784 inputs → 128 hidden neurons → 10 output classes
layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)
但为什么是 128?为什么不是 1,或者 10?
每个隐藏神经元都是一个特征检测器。它透过自己的权重向量去看全部 784 个像素,输出一个数字——「我的这个模式在这张图里表现得有多强?」某个神经元可能最终调成对顶部的一段水平笔画敏感(对区分 5 和 7 有用),另一个对下半部分的闭合环敏感(6、8、9),还有一个对右上方的斜线敏感。然后输出层把这 128 个信号加权起来,判断哪个数字最有可能。
每个输出神经元计算点积 output.W[digit] @ hidden,再加上偏置。它的权重向量决定哪些隐藏层激活值会提高或降低该数字的分数。点积既取决于两个向量的方向关系,也取决于它们的长度。分数最高的类别成为预测结果。
如果只有一个隐藏神经元,每张图像在进入输出层前都会被压缩成一个数。这很难充分表示区分手写数字所需的各种笔画和形状。增加隐藏神经元,可以让网络学习更丰富的特征。
我们先使用 128 个隐藏神经元。在这个示例中,训练五个 epoch 后,验证准确率约为 97%。更小的隐藏层参数更少;更大的隐藏层表达能力更强,但也需要更多计算。下一篇文章会比较不同宽度的效果。
第一层是 个参数,输出层是 个——总共 101,770 个参数。相比上一篇文章拟合直线例子里的 2 个参数( 和 ),这是 5 万倍。可训练算法完全相同。
同一个网络的 Keras 版本
Keras 把它的层叫作 Dense——是「densely connected」(密集连接,也就是「全连接」)的简称,意思是每个输入都连到每个神经元。Dense 层做的计算与我们上面的 NumPy 类完全相同:——输入乘权重、加偏置、施加激活函数。区别在于 Keras 自动处理了权重初始化、前向传播、梯度计算和参数更新。
我们带 ReLU 的 HiddenLayer(784, 128) 变成 Dense(128, activation="relu"),带 softmax 的 OutputLayer(128, 10) 变成 Dense(10, activation="softmax")。注意在 Keras 里你只需要指定输出个数——模型顶部需要一个 keras.Input(shape=(784,)) 来知道输入尺寸,此后 Keras 会自动从上一层的输出推断每一层的输入。所以 Dense(10) 知道自己有 128 个输入,因为它前面那层输出 128。
Dense 层、全连接、FFNN、MLP——有什么区别?
这些词常被混用,但它们描述的是不同的东西:
- Dense / 全连接层——说的是某一层的接线方式:每个输入都连到每个神经元,也就是我们一直在搭的那个运算 。它是一个构件。
- MLP(多层感知机)——由若干堆叠的全连接层、层间夹着非线性构成的整个网络。我们刚搭的这个模型就是一个 MLP:784 → 128(ReLU)→ 10(softmax)。
- FFNN(前馈神经网络)——描述的是拓扑:数据单向流动,输入 → 输出,没有回路,也不记得之前的输入。我们的网络也是前馈的。
我们的网络是全连接的 MLP,也是一种前馈网络。「前馈」描述的是数据流动方式,范围比「全连接」更广。例如,卷积神经网络(CNN)通常也是前馈网络,但使用卷积层。循环神经网络(RNN)则在序列中传递状态,具有循环连接,因此不属于前馈网络。讨论语言等与顺序有关的任务时,这一区别尤其有用。
Sequential 把它们叠成一个模型,每层的输出喂进下一层:
model = keras.Sequential([
    # 784 inputs (28×28 image pixels)
    keras.Input(shape=(784,)),
    # 128 neurons/outputs, ReLU activation
    keras.layers.Dense(128, activation="relu"),
    # 10 neurons/outputs (one per digit), softmax activation
    keras.layers.Dense(10, activation="softmax"),
])

model.summary()
# Total params: 101,770 — same number we counted by hand
搭建训练循环
训练循环还是上一篇文章里那个 4 步流程——前向传播、损失、反向传播、梯度下降。对每个小批量,我们在每张图像上跑前向传播和反向传播以累积梯度,然后取平均并更新一次权重。这与 Keras 内部所做的相匹配:
def train(layers, output_layer, X_train, y_train, X_val, y_val,
          epochs=5, lr=0.1, batch_size=32):
    n = X_train.shape[0]
    history = {"train_loss": [], "train_acc": [], "val_acc": []}

    for epoch in range(epochs):
        # Shuffle training data at the start of each epoch
        indices = np.random.permutation(n)
        X_shuffled = X_train[indices]
        y_shuffled = y_train[indices]

        epoch_loss = 0.0
        correct = 0

        all_layers = layers + [output_layer]

        for i in range(0, n, batch_size):
            X_batch = X_shuffled[i:i+batch_size]
            y_batch = y_shuffled[i:i+batch_size]
            bs = len(X_batch)

            # Accumulate gradients over the mini-batch
            accumulated = {id(l): (np.zeros_like(l.W), np.zeros_like(l.b))
                           for l in all_layers}

            for x, label in zip(X_batch, y_batch):
                # 1. Forward pass
                h = x
                for layer in layers:
                    h = layer.forward(h)
                probs = output_layer.forward(h)

                # 2. Loss computation
                loss = -np.log(probs[label] + 1e-10)
                epoch_loss += loss
                correct += (np.argmax(probs) == label)

                # 3. Backpropagation (compute gradients, don't update yet)
                grad = output_layer.backward(label)
                for layer in reversed(layers):
                    grad = layer.backward(grad)

                # Accumulate gradients
                for l in all_layers:
                    accumulated[id(l)][0][:] += l.grad_W
                    accumulated[id(l)][1][:] += l.grad_b

            # 4. Gradient descent: average gradients and update
            for l in all_layers:
                l.grad_W = accumulated[id(l)][0] / bs
                l.grad_b = accumulated[id(l)][1] / bs
                l.update(lr)

        # Track metrics
        train_loss = epoch_loss / n
        train_acc = correct / n
        val_acc = evaluate(layers, output_layer, X_val, y_val)
        history["train_loss"].append(train_loss)
        history["train_acc"].append(train_acc)
        history["val_acc"].append(val_acc)

        print(f"Epoch {epoch+1}/{epochs} — loss: {train_loss:.4f}, "
              f"train acc: {train_acc:.2%}, val acc: {val_acc:.2%}")

    return history


def evaluate(layers, output_layer, X, y):
    correct = 0
    for x, label in zip(X, y):
        h = x
        for layer in layers:
            h = layer.forward(h)
        probs = output_layer.forward(h)
        correct += (np.argmax(probs) == label)
    return correct / len(y)
这与上一篇文章的 SGD 循环相同:打乱数据、划分小批量,计算并平均每个批次内的梯度,然后更新一次权重。这里的数据和参数更多了:从 5 个数据点、2 个参数,变成了 60,000 张图像、101,770 个参数。
在 Keras 中,我们用 compile 配置训练,用 fit 启动训练:
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),  # gradient descent with lr=0.1
    loss="sparse_categorical_crossentropy",              # cross-entropy loss
    metrics=["accuracy"],
)

history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # hold out 20% of training data for validation
)
compile 设定损失函数和优化器,fit 跑完整个循环——为每个 epoch 里的每个小批量做前向传播、损失、反向传播和梯度下降。
我们拆解一下这些参数:
"sparse_categorical_crossentropy"——就是我们上面推导的交叉熵损失。这名字有三部分:「sparse」表示我们把标签作为整数传入(例如3),而不是 one-hot 向量([0,0,0,1,0,0,0,0,0,0]);「categorical」表示我们在做多类别分类;「crossentropy」就是 这个损失函数。Keras 还有"categorical_crossentropy"(不带「sparse」),用于标签已经是 one-hot 编码的情形——数学一样,只是输入格式不同。SGD(learning_rate=0.1)——随机梯度下降,也就是上一篇文章里那条w = w - lr * dw更新规则。Keras 还提供更高级的优化器(Adam、RMSprop 等)来自动调整学习率,但我们一直用的是朴素 SGD,在这里它表现不错。validation_split=0.2——从训练数据里划出 20%(12,000 张图像)作为验证集。每个 epoch 之后,Keras 会在这些留出的图像上评估模型(只做前向传播,不更新权重),好让我们追踪它的泛化情况。剩下的 48,000 张图像用于实际训练。
准备数据
在开始训练网络之前,我们得先把原始像素数据准备好——网络没法直接处理 28×28 的整数网格。我们要做两件事:
- 摊平——把 28×28 的网格重排成一个 784 个数字的向量
- 归一化——把像素值从 缩放到
摊平把一张 28×28 的图像转换成模型需要的 784 维输入向量。第一个全连接层的每个神经元都连接全部 784 个输入。卷积网络可以利用像素的空间排列,而我们的全连接网络把它们当作一列数来处理。
flatImage = image.reshape(784) # [0, 0, 0, ..., 156, 252, 128, ..., 0, 0] — 784 values归一化有助于让输入值和权重处在同一个量级上。 权重通常被初始化成 0 附近的小随机数,所以如果输入高达 255,加权和就会变得很大,进而导致大的激活值、大的梯度和不稳定的训练。除以 255 把一切放进 ——在这个范围里,小的随机权重从一开始就能给出合理的输出。这是机器学习里的标准做法,并非 MNIST 特有。
较大的输入可能让 sigmoid 进入饱和区,此时导数趋近于零,加剧梯度消失问题。ReLU 在正半轴上不会饱和,但较大的梯度可能导致过大的权重更新,使神经元持续处于不激活状态。我们会在 ReLU 死亡问题的文章中进一步讨论。
归一化把像素值从 缩放到 :
# Normalize pixel values from [0, 255] to [0, 1]
normalizedImage = flatImage / 255.0  # [0.0, 0.0, 0.0, ..., 0.61, 0.99, 0.50, ..., 0.0, 0.0]
训练集、验证集与测试集
在跑训练之前,有一个重要区分需要弄明白。我们有 60,000 张训练图像和 10,000 张测试图像——但实际上我们需要三套,而不是两套:
- 训练集——模型用于学习的数据。每个 epoch 都会遍历其中的图像,计算梯度并更新权重。
- 验证集——每个 epoch 后,模型只进行前向传播,计算损失和准确率,不更新权重。这些指标有助于评估泛化能力:如果训练准确率为 98%,验证准确率只有 90%,就可能存在过拟合。验证准确率不再提高,而训练准确率继续上升,也是一个信号。
- 测试集——完全独立的数据集,在所有训练决策确定之后,于最后评估一次。它用来估计模型在同一数据分布下、未见过的图像上的表现。
用我们那 4 步训练循环来说:
| 训练集 | 验证集 | 测试集 | |
|---|---|---|---|
| 1. 前向传播 | 是 | 是 | 是 |
| 2. 计算损失 | 是 | 是(仅用于汇报) | 是(仅用于汇报) |
| 3. 反向传播 | 是 | 否 | 否 |
| 4. 更新权重 | 是 | 否 | 否 |
对训练图像,4 步全跑——模型在学习。对验证和测试图像,只跑第 1、2 步——模型衡量自己表现如何,但不会因为看到的内容而改动权重。
为什么不干脆用测试集兼任两职?因为每当你在某个数据集上检查表现并据此做决定(比如「还要继续训练吗?」),你就在悄悄地往那份数据上拟合。如果你用测试集来决定何时停止训练,测试准确率就会变得乐观偏高。让验证集来吸收这份偏差,测试集才能保持诚实。
验证集也是你用来调超参数的地方——像学习率、批大小、层数和 epoch 数这些选择。你试不同的设置,比较验证准确率,挑最好的那个。整个过程中测试集始终封存不动,这样它才能给出一个无偏的最终评估。
实践中,你可以从训练数据里切出一部分来做验证集。Keras 用 validation_split 让这件事很轻松:
history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # use 20% of training data as validation
)
你也可以手动划分,并用 validation_data=(X_val, y_val) 传入一份单独的数据集。我们会用 validation_split=0.2——Keras 会留出 20% 的训练数据(12,000 张图像)用于验证,在剩下的 48,000 张上训练。那 10,000 张测试图像完全另放一边,留作最终评估。
训练模型
先用 Keras 内置的 MNIST 加载函数读取并准备数据:
import keras
import numpy as np

(train_images, train_labels), (test_images, test_labels) = keras.datasets.mnist.load_data()

# Flatten 28×28 → 784 and normalize to [0, 1]
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0
X_test = test_images.reshape(-1, 784).astype("float32") / 255.0
y_train = train_labels
y_test = test_labels

print(f"Training: {X_train.shape[0]} images, {X_train.shape[1]} pixels each")
print(f"Test:     {X_test.shape[0]} images")
# Training: 60000 images, 784 pixels each
# Test:     10000 images
我们现在有 60,000 张训练图像(每张是一个 784 维、取值在 0 到 1 之间的向量)以及它们的标签(每个 0–9)。测试集是分开的——我们只用它来检查模型对训练中从未见过的数字泛化得如何。
来训练我们的网络:
# Split: 80% train, 20% validation
n_val = int(0.2 * len(X_train))
X_val, y_val = X_train[:n_val], y_train[:n_val]
X_train_sub, y_train_sub = X_train[n_val:], y_train[n_val:]

layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)

history = train([layer1], output, X_train_sub, y_train_sub, X_val, y_val,
                epochs=5, lr=0.1, batch_size=32)

# Epoch 1/5 — loss: 0.3260, train acc: 90.70%, val acc: 94.58%
# Epoch 2/5 — loss: 0.1608, train acc: 95.30%, val acc: 95.97%
# Epoch 3/5 — loss: 0.1147, train acc: 96.64%, val acc: 96.49%
# Epoch 4/5 — loss: 0.0898, train acc: 97.45%, val acc: 96.94%
# Epoch 5/5 — loss: 0.0737, train acc: 97.87%, val acc: 97.27%
下面是 5 个 epoch 的训练过程——左图显示随着模型学习损失在下降,右图显示准确率在攀升。绿点是验证准确率(val_accuracy),在每个 epoch 结束时于模型从不训练的留出图像上测得:
训练五个 epoch 后,网络能正确分类约 97% 的验证图像。
第一个 epoch 的训练准确率就达到约 90%。这是模型在整个 epoch 的学习过程中做出的预测的平均结果,涵盖了 1,500 个批次和权重更新。验证准确率则在 epoch 结束后,用已经更新的模型单独测量。
观察蓝色训练曲线与绿色验证曲线之间的差距,尤其是损失图。训练损失持续下降,但验证损失在第 4–5 个 epoch 左右不再改善,甚至开始上升。这是过拟合的迹象:模型继续拟合训练数据,却不再改善对新图像的预测。继续训练时,这个差距可能增大,训练准确率继续提高,验证准确率却停滞或下降。因此,验证集可以帮助我们决定何时停止训练。下一篇文章会详细讨论过拟合。
自己动手试试
我们准备了一份配套 notebook,可以运行并比较 Keras 和 NumPy 的实现。所有单元格都会自动执行,先显示 Keras 的训练输出,再显示 NumPy 的训练输出,两者报告相同种类的指标。
Keras 的输出长这样:
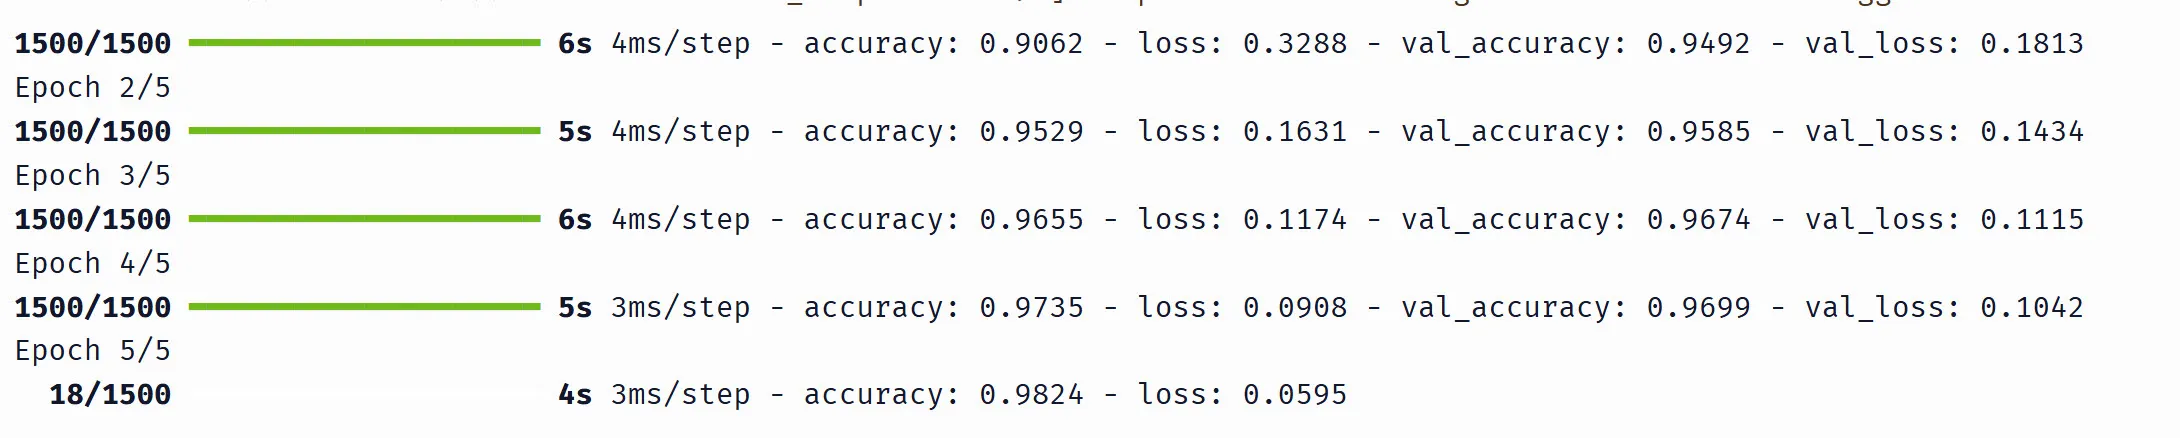
各部分的含义如下:
1500/1500——1,500 个小批量中已完成 1,500 个(48,000 张训练图像 / 每批 32 张)。训练进行中你会看到这个数往上走(比如18/1500表示已完成 18 个批次)。5s 4ms/step——这个 epoch 花了 5 秒,每批约 4 毫秒accuracy: 0.9529和loss: 0.1631——训练指标,在该 epoch 的所有批次上取平均val_accuracy: 0.9585和val_loss: 0.1434——验证指标,在 epoch 结束时于留出的 12,000 张图像上算一次
Keras 和 NumPy 的结果不会完全相同,因为随机权重初始化存在差异,但应该接近:五个 epoch 后的验证准确率都在 97% 左右。这与两种实现使用相同训练算法的预期一致。
我们讲了什么
我们把上一篇文章里的每个概念都拿来用到了一个真实问题上——用 10 万多个参数分类手写数字,而不是用 2 个参数拟合一条直线:
- 分类 vs 回归:softmax 把原始 logit 变成概率,交叉熵衡量这些概率错得有多离谱
- 前向传播:输入流经各层,每层计算 ——同一个公式,如今写成矩阵形式
- 反向传播:softmax + 交叉熵的梯度简化成 ,而链式法则正如我们手推的那样向后流经各层
- 训练循环:打乱、切成小批量、前向传播 → 损失 → 反向传播 → 更新——在每个 epoch 的每个批次上重复
算法与我们在上一篇文章里搭的完全相同。Keras 把它自动化了,但底下仍是我们 NumPy 代码一步步执行的那套计算。
我们始终使用固定设置:一个含 128 个神经元的隐藏层、学习率 0.1、批大小 32。改变它们会怎样?在下一篇文章中,我们将比较不同的学习率、批大小、网络深度和激活函数,并讨论过拟合、早停,以及如何诊断训练问题。