Float, bfloat и как биты определяют память модели
Нейросеть хранит обучаемые параметры, в том числе веса и смещения. Число параметров, умноженное на количество байтов на параметр, даёт объём памяти для самих параметров. При выполнении также нужны активации, временные буферы и, в зависимости от задачи, кеши или состояние обучения.
Возьмём маленькую сеть, которую мы обучили в статье про MNIST, — плотный классификатор с двумя слоями Dense в Keras: 784 развёрнутых в вектор пикселя подаются в скрытый слой из 128 нейронов, а тот — в выходной слой из 10 нейронов (по одному на цифру).
Сокращённая запись этой формы — 784 → 128 → 10, где 784 — размер входа, а не слой. Число параметров складывается так:
При стандартной политике fp32 эти параметры занимают 407 080 байт: около 407 КБ, или 398 КиБ. Остальная память, необходимая работающей модели, сюда не входит.
Репозитории моделей часто содержат карточку модели с описанием модели и обучения. Метаданные файлов весов также могут указывать число параметров и типы данных для их хранения.
На скриншоте показана панель Hugging Face для PaddleOCR-VL-1.5 с округлённым числом параметров и типом тензоров:
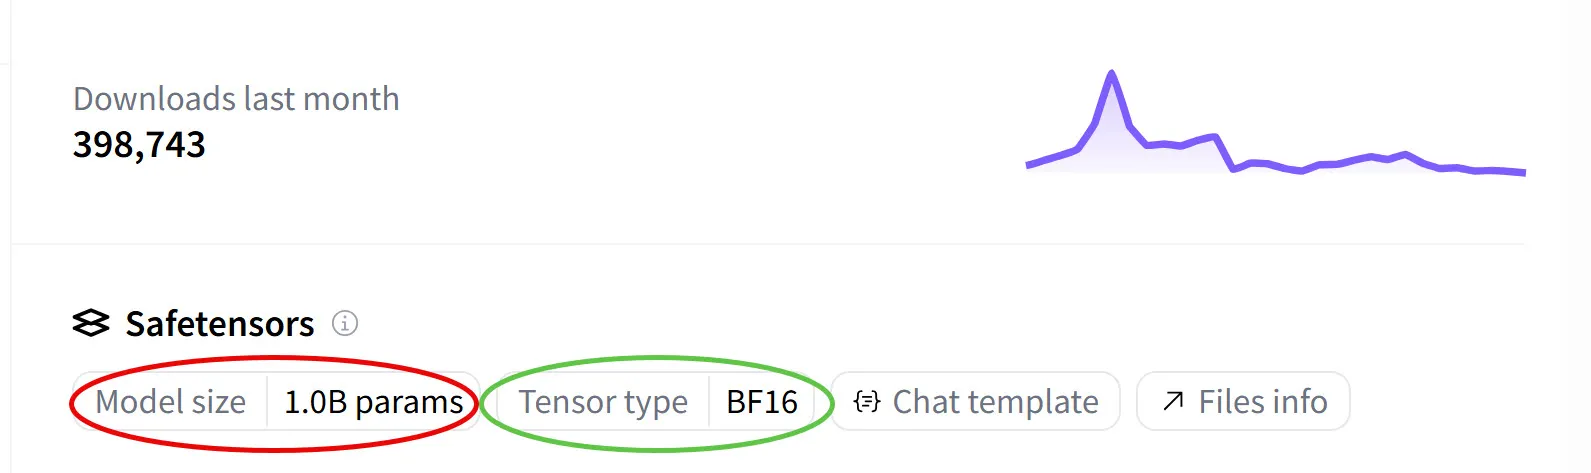
Model size указывает число параметров. Tensor type — это dtype, тип данных для хранения. dtype тензора описывает его элементы, например float32, int8 или bfloat16, а Python-функция type() — сам объект.
В коде проверьте .dtype; формат вывода зависит от библиотеки:
>>> import torch
>>> torch.tensor([0.5], dtype=torch.bfloat16).dtype
torch.bfloat16

>>> import numpy as np
>>> np.array([0.5], dtype=np.float16).dtype
dtype('float16')
Hugging Face читает ту же информацию прямо из файла safetensors: safetensors — это формат файлов Hugging Face для сохранения и распространения обученных весов, и dtype каждого тензора хранится в его метаданных, что панель и показывает как «Tensor type».
BF16 обозначает bfloat16, 16-битный формат с плавающей точкой, разработанный в Google. Он содержит поля знака, порядка и дробной части, но распределяет биты иначе, чем IEEE binary16. В одном чекпойнте могут быть тензоры разных типов; для точного расчёта памяти проверяйте метаданные.
Так что шаги вычисления объёма памяти модели те же, что мы применяли к MNIST, просто с числами покрупнее. Цифра 1.0B — это сумма параметров по всем слоям модели, та же послойная арифметика, что мы делали вручную для MNIST, только Hugging Face уже сделал её за нас, пройдясь по каждому тензору в файле safetensors и сложив количества элементов.
Итак, карточка говорит: 1 миллиард параметров («B» — сокращение от billion, ). Умножаем на 2 байта на bf16-вес и получаем вес модели в памяти:
Это оценка только для весов. При инференсе также нужны активации, рабочие буферы и иногда KV-кеш, который при длинных последовательностях или больших батчах может занимать значительную часть памяти. Для обучения дополнительно нужны градиенты, состояние оптимизатора и сохранённые активации.
Только веса модели с 7 млрд параметров занимают около 28 ГБ в fp32, 14 ГБ в fp16/bf16 или 7 ГБ в int8 без метаданных квантования. Для 70 млрд параметров веса fp16 требуют около 140 ГБ. Поместится ли модель на устройстве, зависит и от остальных затрат памяти.
Снижение точности уменьшает размер весов: fp16 и bf16 занимают вдвое меньше байтов, чем fp32, а 8- или 4-битное квантование сжимает их ещё сильнее. Качество и скорость зависят от модели, метода преобразования и оборудования; их нужно измерять.
Не всякое число в сети — это вес
Работающая сеть использует несколько видов тензоров. Статья об обратном распространении объясняет происхождение параметров, активаций и градиентов.
Веса и активации нужны и при инференсе, и при обучении. При инференсе промежуточные тензоры можно освобождать, когда они больше не нужны, хотя остаточные связи и рабочие буферы могут требовать нескольких тензоров одновременно. При обучении активации обычно сохраняют для обратного прохода; checkpointing позволяет заменить часть хранения повторными вычислениями. Тип активаций не обязан совпадать с типом весов.
На инференсе LLM на трансформерах несут ещё и KV-кэш — ключи и значения, закэшированные по прошлым токенам во время авторегрессивной генерации, чтобы внимание не пересчитывало их для каждого нового токена. Часто хранится в fp16 или fp8 ради экономии памяти на длинных контекстах.
Во время обучения в картину входят ещё две категории:
- Градиенты описывают изменение потерь по каждому параметру. Их величины могут сильно различаться, поэтому важен диапазон формата.
- Состояние оптимизатора зависит от алгоритма. Adam хранит две обновляемые статистики на параметр; их тип зависит от реализации и политики точности.
В коде dtype задаётся в нескольких конкретных местах. Вот соответствующий фрагмент из нашей статьи про обучение на MNIST:
# Input data — explicitly cast to float32
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0

# Model — Dense layers default to fp32 for weights and biases (no dtype= passed)
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,)),
    keras.layers.Dense(10, activation="softmax"),
])

# Optimizer — owns its own state, allocated separately
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)
.astype("float32") задаёт тип входного массива. У слоёв Keras есть отдельные типы переменных и вычислений, определяющие хранение параметров и выполнение операций. Здесь стандартная политика использует fp32 для обоих. Для слоя можно задать другую политику:
# Same architecture, but weights and biases stored in bf16
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,), dtype="bfloat16"),
    keras.layers.Dense(10, activation="softmax", dtype="bfloat16"),
])
# PyTorch equivalent — nn.Linear takes the dtype directly
model = nn.Sequential(
nn.Linear(784, 128, dtype=torch.bfloat16),
nn.ReLU(),
nn.Linear(128, 10, dtype=torch.bfloat16),
)В Keras dtype="bfloat16" задаёт тип и переменных, и вычислений. Политика смешанной точности, например "mixed_bfloat16", сохраняет переменные в fp32, а вычисления выполняет в bf16. В PyTorch конструктор задаёт тип параметров; входы и операции должны быть совместимы с ним либо обрабатываться через autocast. Типы градиентов и состояния оптимизатора также зависят от реализации.
Смешанная точность означает разные форматы для разных операций или видов данных. В этой статье «модель bf16» означает формат хранения весов, если не указано иное.
Один из вариантов Adam со смешанной точностью требует 16 байт на параметр, не считая активаций:
- bf16 веса: 2 байта
- bf16 градиенты: 2 байта (той же формы, что веса)
- fp32 моменты Adam: 8 байт (два момента × 4 байта)
- fp32 мастер-копия весов (хранится оптимизатором для стабильных обновлений): 4 байта
При этих допущениях хранение данных, связанных с параметрами, требует при обучении в восемь раз больше памяти, чем сами веса bf16. Это пример расчёта, а не обязательная норма: мастер-копии, типы градиентов, варианты оптимизатора и распределение между устройствами меняют итог. Активации добавляют расходы, зависящие от задачи.
Для 7 млрд параметров такой вариант требует около 112 ГБ плюс активации и буферы, против 14 ГБ для самих весов bf16. При полном обучении память устройства можно экономить распределением состояния или выгрузкой; дообучение адаптеров меняет расчёт, поскольку обновляет лишь часть параметров.
Стандартные форматы чисел с плавающей точкой в Python и JavaScript
Прежде чем смотреть на числовые форматы, которые ML реально использует, полезно начать со знакомых числовых типов, которыми мы каждый день пользуемся в Python и JavaScript:
| Язык | Вид | Тип | Подробности |
|---|---|---|---|
| Python | Целое (без дробной части, точное) | int | Произвольной точности. CPython наращивает хранилище по мере надобности, так что 2**1000 просто работает, и результат точен. |
| Float (64-битный double по IEEE-754) | float | Тот самый формат, разбору которого посвящена остальная часть статьи. Само число занимает 8 байт; объект Python требует дополнительной памяти. | |
| JavaScript | Целое (без дробной части, точное) | BigInt | Целое произвольной точности, добавленное позже отдельным типом. Пишется с суффиксом n (например, 5n). Ближайший аналог питоновского int. |
| Float (64-битный double по IEEE-754) | Number | Тот же формат, что питоновский float. JavaScript использует его и для целых, и для дробей; отдельного целочисленного типа по умолчанию нет. |
float в типичных сборках CPython и Number в JavaScript используют IEEE binary64. Поэтому они одинаково представляют 0.1 и дают 0.1 + 0.2 = 0.30000000000000004. Поведение языков всё же различается: деление на ноль в Python вызывает исключение, а JavaScript может вернуть бесконечность. Хранение объекта также требует памяти сверх восьми байтов самого числа.
Механику того, как эти 64 бита делятся на знак, порядок и мантиссу, почему порядок хранится со смещением, а не в дополнительном коде, и как округляется 0.1, я подробно разбираю в предыдущих статьях серии. Всё сказанное там применимо к обоим языкам напрямую, потому что под капотом у них один и тот же 64-битный формат.
Обычные вещественные литералы используют эти стандартные форматы. Массивы и тензоры позволяют выбрать другое хранение; в JavaScript также есть Float32Array. ML-фреймворки добавляют bf16 и квантованные представления с малым числом битов.
Как конвертации теряют биты: от языковых float к ML-dtype
Всякий раз, когда значение переходит из одного числового формата в другой — питоновский float в int, float в int8, fp64 в fp16, — есть шанс, что биты не поместятся. Чем-то придётся пожертвовать, и куда денутся лишние биты, зависит от исходного и целевого форматов.
Простейший случай — float → int: отбросить всё после точки.
>>> int(3.7)
3
>>> int(-3.7)
-3               # truncates toward zero — drops the fractional bits
>>> import math
>>> math.floor(-3.7)
-4               # floor rounds toward -infinity instead
Усечение удобно понимать как восстановление двоичного значения с отбрасыванием дробной части. Конкретные инструкции преобразования зависят от реализации.
Например, возьмём 5.75. В двоичном это 101.11 — три бита до точки (101 = 4 + 1 = 5) и два после (.11 = 0.5 + 0.25 = 0.75). Однако IEEE-754 хранит это не так: он нормализует число, чтобы перед точкой была ровно одна 1, и запоминает сдвиг в порядке:
   101.11   →   1.0111 × 2^2
   ^^^ ^^       ^ ^^^^   ^
   │   │        │ │      └── exponent: how far to shift the radix back
   │   │        │ └───────── mantissa (fractional part of the 1.xxx form)
   │   │        └─────────── the implicit leading 1 (not stored)
   │   └──────────────────── original fractional bits
   └──────────────────────── original integer bits
Сохранённая дробная часть начинается с 0111, а порядок без смещения равен 2. Восстановление неявной единицы и сдвиг двоичной точки объясняют преобразование в целое:
   mantissa:    1.0111
   shift by 2:  101.11
                ^^^ ^^
                │   └── fractional bits → discarded
                └────── integer bits    → 101 = 5
Отбрасывание .11 удаляет 0.75, поэтому int(5.75) возвращает 5. Это округление к нулю, или усечение, а не к ближайшему целому. Поэтому int(-3.7) возвращает -3.
Преобразование в более узкий тип может усекать, округлять, переполнять диапазон или выдавать ошибку. API имеет значение: конструктор может отклонить целое вне диапазона, хотя преобразование готового тензора даст циклический перенос.
>>> torch.tensor([3.7, -3.7], dtype=torch.int8)       # float → int, truncates toward zero
tensor([3, -3], dtype=torch.int8)                     # → fractional bits dropped on each element

>>> torch.tensor([1000, 1001], dtype=torch.int64).to(torch.int8)      # int → int8, overflows (int8 max is 127)
tensor([-24, -23], dtype=torch.int8)                  # → low 8 bits kept, neighbours wrap together

>>> torch.tensor([1e5, -1e10], dtype=torch.float16)   # fp64 → fp16, overflows (fp16 max is ~65504)
tensor([inf, -inf], dtype=torch.float16)              # → saturate to ±inf; magnitudes are lost

>>> torch.tensor([2**24 + 1, 2**24 + 2], dtype=torch.float32)  # int → fp32, exceeds mantissa precision
tensor([16777216., 16777218.], dtype=torch.float32)            # → +1 rounds away (24-bit mantissa); +2 is exact
Примеры показывают четыре возможных результата преобразования:
| Сценарий | Из | В | Пример | Результат |
|---|---|---|---|---|
| Усечение | float | int | 3.7 → int8 | 3 |
| Заворачивание | int | более узкий int | 1000 → int8 | -24 |
| Насыщение до бесконечности | float | более узкий float | 1e5 → fp16 | inf |
| Потеря точности | int | float | 2^24 + 1 → fp32 | 2^24 |
Циклический перенос. При преобразовании целочисленного тензора в int8 сохраняются младшие восемь битов. В дополнительном коде 1000 превращается в -24. Это не означает, что любой конструктор примет значение вне диапазона.
Переполнение с плавающей точкой. При округлении к ближайшему преобразование 1e5 в fp16 даёт inf, поскольку наибольшее конечное значение fp16 — 65 504. При других режимах округления результат переполнения может отличаться.
Потеря точности. 2^24 + 1 → fp32 становится 2^24. Мантисса fp32 — 24 бита (23 явных + 1 неявный), так что каждое целое от 0 до 2^24 (16 777 216) представимо точно, но за этой границей расстояние между представимыми значениями удваивается на каждой степени двойки. Целое 2^24 + 1 попадает между двумя представимыми значениями fp32 и округляется к ближайшему (2^24, поскольку +1 — ровно середина, а при равном расстоянии выбирается чётное). Это та же история, что стоит за тем, почему fp64 начинает терять целочисленную точность на 2^53 ≈ 9 × 10^15: Number.MAX_SAFE_INTEGER в JavaScript — это ровно 2^53 − 1.
Результат преобразования зависит от значения, исходного и целевого форматов, режима округления и API. Их нужно учитывать вместе.
Явный выбор типа данных
Экосистема ML предлагает куда более широкое меню, чем Python или JavaScript нативно. Каждый крупный численный фреймворк — NumPy, PyTorch, JAX и TensorFlow — позволяет выбрать dtype явно. Вот одна и та же операция в четырёх фреймворках:
import torch
x = torch.tensor([0.5])                        # fp32 by default — 4 bytes
y = torch.tensor([0.5], dtype=torch.float16)   # fp16 — 2 bytes
z = torch.tensor([0.5], dtype=torch.bfloat16)  # bf16 — 2 bytes
w = torch.tensor([0.5], dtype=torch.float64)   # fp64 — 8 bytes, same as Python float
import tensorflow as tf
x = tf.constant([0.5]) # fp32 by default — 4 bytes
y = tf.constant([0.5], dtype=tf.float16) # fp16 — 2 bytes
z = tf.constant([0.5], dtype=tf.bfloat16) # bf16 — 2 bytes
w = tf.constant([0.5], dtype=tf.float64) # fp64 — 8 bytesimport numpy as np
x = np.array([0.5], dtype=np.float32) # 4 bytes per element
y = np.array([0.5], dtype=np.float16) # 2 bytes
# NumPy core has no bfloat16 — you need the `ml_dtypes` package, or JAX/TF/Torch arraysimport jax.numpy as jnp
x = jnp.array([0.5], dtype=jnp.bfloat16) # bf16 — 2 bytesЭти конструкторы позволяют выбрать тип элементов. В основных типах NumPy нет bf16, но его могут добавлять расширения. PyTorch, JAX и TensorFlow предоставляют bf16; поддержка операций зависит от устройства и бэкенда.
Литерал 0.5 с точки зрения Python по-прежнему 64-битный double — конверсия происходит при конструировании тензора. Внутри каждый элемент занимает 8, 4, 2 или 2 байта в зависимости от dtype. На fp8 это становится 1 байтом, на int4 — половиной байта.
Чтобы увидеть, что эти байты на самом деле кодируют — и почему их сокращение вдвое не просто делит представимый диапазон пополам, — нужно посмотреть на формат под капотом.
Форматы с плавающей точкой в ML
Современный ML использует горстку форматов с плавающей точкой, и у всех у них одна и та же трёхполевая раскладка, унаследованная от IEEE-754:
- Знак (1 бит) — положительное или отрицательное.
- Порядок — насколько сдвинуть точку, хранится в смещённом двоичном коде.
- Мантисса (значащая часть) — ведущие цифры числа в нормализованной научной форме, с отброшенной неявной ведущей
1.
Для нормальных чисел порядок определяет масштаб, а значащая часть — точность. Специальные коды представляют ноль, бесконечность, NaN и субнормальные числа, но поддержка различается: некоторые варианты fp8 не имеют бесконечностей, а часть оборудования обнуляет субнормальные значения.
| Формат | Всего бит | Знак | Порядок | Мантисса | Байт/параметр |
|---|---|---|---|---|---|
| fp64 (IEEE-754 double) | 64 | 1 | 11 | 52 | 8 |
| fp32 (IEEE-754 single) | 32 | 1 | 8 | 23 | 4 |
| bf16 (Brain Float 16) | 16 | 1 | 8 | 7 | 2 |
| fp16 (IEEE-754 binary16) | 16 | 1 | 5 | 10 | 2 |
Два 16-битных формата по-разному распределяют один бюджет. Перенос бита из дробной части в порядок удваивает шаг при заданном нормальном порядке и сильно расширяет диапазон порядков, а не просто удваивает наибольшее значение.
[1, 4) (128 per octave; gap doubles at 2)Для нормальных чисел с битами дробной части шаг равен в и вдвое больше в . bf16 достигает примерно с шагом около 0.008 вблизи единицы; fp16 — 65 504 с шагом около 0.001 вблизи единицы.
Полоса внизу виджета делает зазор видимым: при выбранном bf16 видны отдельные засечки, расставленные по [1, 2], — эти зазоры и есть предел точности формата на единичном масштабе. Переключитесь на fp16 — и засечки сливаются в сплошную линию, потому что расстояние стало меньше пикселя. Сетка по-прежнему дискретна; просто она достаточно плотная, чтобы дискретности больше не было видно, — а это ровно то, что здесь значит «больше точности».
Полоса также продолжается в следующую октаву [2, 4) (за пунктирную отметку на 2), чтобы стало ясно: удвоение зазора не уникально для диапазона [1, 2) — то же число засечек (по одной на состояние мантиссы) растягивается на вдвое более широкий интервал, так что визуальное расстояние в правой половине вдвое больше, чем в левой. Потяните ползунок к малой мантиссе (например, M=4) — и удвоение станет очевидным.
Для конкретики, первые несколько представимых значений в [1, 2] для каждого пресета:
| bf16 (128 значений, зазор = 1/128) | fp16 (1024 значения, зазор = 1/1024) |
|---|---|
1.0 | 1.0 |
1.0078125 | 1.0009765625 |
1.015625 | 1.001953125 |
1.0234375 | 1.0029296875 |
1.03125 | 1.00390625 |
| … | … |
1.9921875 | 1.9990234375 |
(2.0) | (2.0) |
Каждое очередное значение bf16 приземляется ровно на каждое 8-е значение fp16 — сетка bf16 в этой октаве является строгим подмножеством сетки fp16, просто из каждых восьми засечек убраны семь. Это отношение равно в точности (у fp16 10 бит мантиссы, у bf16 — 7): каждый дополнительный бит мантиссы удваивает число представимых значений на октаву.
Шаг одинаков внутри каждого нормального интервала . В следующем интервале он удваивается, а по направлению к нулю уменьшается до субнормальной области, где становится постоянным.
Вот как это выглядит для bf16 на нескольких октавах:
| Октава bf16 | Зазор |
|---|---|
[1, 2) | 1/128 ≈ 0.0078 |
[2, 4) | 2/128 = 1/64 ≈ 0.0156 |
[4, 8) | 4/128 = 1/32 ≈ 0.0313 |
| … | … |
[1024, 2048) | 1024/128 = 8 |
bf16 даёт более широкий диапазон порядков, а fp16 — более высокую точность при сравнимых нормальных значениях. Слишком большие числа могут вызвать переполнение, а очень малые — потерю точности или округление до нуля. Выбор зависит от задачи и оборудования.
Почему биты bf16 разбиты именно так
Google разработала bf16 для ML, сохранив восемь битов порядка fp32 и сократив дробную часть с 23 до семи битов. Диапазон порядков поэтому близок к fp32, но точность существенно ниже.
При одинаковом нормальном порядке шаг bf16 в раз больше шага fp32. Вот как округляется 1.005 в трёх форматах:
| Формат | Хранимое значение | Ошибка |
|---|---|---|
| fp32 | 1.005 (практически точно) | ~10⁻⁸ |
| fp16 | 1.0048828125 | ~1.2 × 10⁻⁴ |
| bf16 | 1.0078125 | ~2.8 × 10⁻³ |
Для 1.005 fp16 точнее. При малых величинах 1e-7 представляется ненулевым субнормальным fp16: примерно 1.192e-7. При округлении к ближайшему 1e-8 уже превращается в ноль, тогда как bf16 может сохранить близкое значение.
Переполнение, потеря малых значений и округление влияют на обучение. Переполнение может распространять бесконечности или NaN, а потеря малых значений — обнулять градиенты. Округление также может мешать малым обновлениям изменять вес низкой точности. Один лишь широкий диапазон не гарантирует стабильности.
Масштабирование потерь увеличивает потери перед обратным проходом и убирает масштаб из градиентов перед обновлением, помогая сохранить малые градиенты в fp16. Динамический вариант также реагирует на переполнение. В PyTorch есть torch.amp.GradScaler("cuda"). Широкий диапазон bf16 обычно позволяет обходиться без масштабирования потерь.
Тот же размен на любой ширине
Преобразование fp32 в bf16 просто, но не обязательно сводится к сдвигу: Cloud TPU округляет к ближайшему с выбором чётного при равенстве и обнуляет субнормальные bf16. Обратное преобразование в fp32 точно, но не восстанавливает потерянные биты.
fp16 полезен, когда задаче подходят его три дополнительных бита дробной части или аппаратная поддержка. bf16 часто удобен при обучении, но ни один формат не заменяет другой во всех случаях.
Аппаратная поддержка форматов
Нативные вычисления низкой точности могут повысить пропускную способность, а компактное хранение — сократить обмен с памятью даже при вычислениях в более широком типе. Скорость зависит от ядра и задачи.
Примеры аппаратной поддержки:
| Формат | Где работает нативно |
|---|---|
| fp64 / fp32 | Широко поддерживаются CPU и GPU; производительность зависит от устройства. |
| fp16 | Тензорные ядра NVIDIA начиная с Volta (V100, 2017); другие вендоры подтянулись. |
| int8 | Среди примеров — тензорные ядра NVIDIA Turing (T4, 2018). |
| bf16 | Google TPU v2 (2017), NVIDIA Ampere (A100, 2020), Intel AVX-512 BF16, Arm Armv8.6-A BF16. |
| fp8 (E4M3, E5M2) | NVIDIA Hopper (H100, 2022), AMD CDNA 3 (MI300), Intel Gaudi 2/3. |
| int4 | Режимы int4 появились в тензорных ядрах NVIDIA Turing; поддержка зависит от поколения и API. |
Матричные блоки, например Tensor Cores и TPU MXU, ускоряют группы операций умножения с накоплением. Точность операндов, накопления и правила округления зависят от инструкции; округление матричной операции не обязано совпадать со скалярной FMA.
Хранение с меньшим числом битов уменьшает размер тензоров. Для ускорения нужны подходящие ядра, оборудование и достаточный объём работы. Преобразования и другие узкие места могут перевесить выигрыш в вычислениях.
Проверяйте отдельно формат чекпойнта и поддержку устройства средой выполнения. Например, упакованные веса int4 можно деквантовать для вычислений с плавающей точкой без нативных матричных инструкций int4. Измеряйте поддерживаемый путь выполнения, а не судите о скорости по названию типа.
Взгляд вперёд: fp8
Два распространённых варианта fp8 по-разному распределяют восемь битов:
| Формат | Знак | Порядок | Мантисса | Для чего |
|---|---|---|---|---|
| fp8 E4M3 | 1 | 4 | 3 | веса и активации прямого прохода (смещение в точность) |
| fp8 E5M2 | 1 | 5 | 2 | градиенты (смещение в диапазон) |
В работе FP8 Formats for Deep Learning описаны E4M3, E5M2 и их роли в обучении со смешанной точностью.
Часто E4M3 используют для операндов прямого прохода, а E5M2 — для градиентов. Масштабы переводят значения тензора в доступный диапазон. Ниже используется один масштаб на тензор; другие варианты работают с меньшими блоками или иными стратегиями масштабирования.
import torch

w_fp32 = torch.randn(1024, 1024, dtype=torch.float32) * 0.1

# Per-tensor scale: |max| / fp8_max maps the tensor's range into fp8's
FP8_E4M3_MAX = 448.0
scale = (w_fp32.abs().max() / FP8_E4M3_MAX).clamp_min(torch.finfo(torch.float32).tiny)

# Quantize: divide by scale, then cast to fp8
w_fp8 = (w_fp32 / scale).to(torch.float8_e4m3fn)

# Reconstruct on read: cast back, multiply by scale
w_back = w_fp8.to(torch.float32) * scale
Библиотеки вроде NVIDIA Transformer Engine предоставляют схемы fp8, управляющие масштабированием и состоянием повышенной точности. Само хранение тензора как torch.float8_e4m3fn не реализует такую схему обучения.
Ползунок меняет максимальный модуль значения тензора. Зелёные отметки показывают представимые fp8 после масштабирования, синие точки — пример данных. Это иллюстрация масштабирования, а не полная реализация обучения или инференса.
Почему модели терпят меньшее число бит
Многие сети допускают некоторую ошибку округления, но отдельные веса и каналы могут быть чувствительны. Качество квантования зависит от распределения ошибок, выбросов, накопления и задачи. При объединении значений ошибки не обязательно компенсируются.
Исследования ниже демонстрируют полезные методы низкой точности в конкретных условиях оценки. Они не гарантируют сохранения качества любой модели и не доказывают, что большие модели всегда лучше переносят меньшее число битов.
Deep Compression сочетает прунинг, квантование и кодирование для сжатия сетей, включая AlexNet. Mixed Precision Training показала обучение с арифметикой fp16 и мастер-весами fp32 с сохранением точности в проведённых экспериментах.
Для LLM LLM.int8() сочетает матричное умножение int8 с повышенной точностью для выбросов, а GPTQ квантует веса до малого числа битов. QLoRA замораживает квантованную базовую модель и обучает адаптеры. BitNet b1.58 обучается с троичными весами; это не означает, что любую готовую модель можно свести к трём значениям без потери качества.
Квантизация — та же идея, доведённая дальше
Здесь рассмотрим равномерное целочисленное квантование: каждый вес представляется небольшим целым числом и общим масштабом, иногда с нулевой точкой. Другие схемы, например NF4, используют неравномерные уровни.
Прежде чем перейти к механике, вот что квантизация реально даёт:
- Память: данные весов int8 и упакованных int4 соответственно в четыре и восемь раз меньше fp32, без метаданных.
- Скорость: меньший обмен с памятью и подходящие ядра могут ускорять работу, но важны и затраты на преобразования и запуск.
- Развёртывание: некоторые ускорители требуют целочисленные модели, другие поддерживают несколько форматов.
- Энергия: сокращение обмена данными и точности вычислений может снижать энергозатраты в зависимости от оборудования и задачи.
Есть два потока собственно квантизации, в зависимости от того, на каком этапе жизненного цикла модели вы её делаете. Они разделяют одну и ту же арифметику «защёлкивания на сетку», которую мы разберём в следующем подразделе.
Квантование после обучения (PTQ) преобразует готовую модель без повторного обучения параметров. Некоторые методы требуют калибровочных данных и значительных вычислений. Примеры — GPTQ и AWQ. Библиотеки и среды выполнения поддерживают разные алгоритмы и форматы чекпойнтов; проверяйте совместимость.
Обучение с учётом квантования (QAT) моделирует квантование при обучении, позволяя параметрам адаптироваться к ошибке. Нужен процесс обучения или дообучения, но не обязательно размеченные данные: LLM-QAT использует дистилляцию. Преимущество перед PTQ зависит от модели, разрядности и оценки.
Меньшая разрядность обычно ограничивает точность представления. Проверяйте сжатую модель на целевых задачах: экономия памяти сама по себе не доказывает приемлемого качества.
Рецепт «защёлкни и отмасштабируй»
В этом симметричном примере храним одно целое число на вес и один масштаб на группу. Для int8 используем индексы от -127 до 127: 255 уровней. Аналогичный диапазон int4 от -7 до 7 содержит 15 уровней; другие схемы могут использовать все 256 или 16 битовых комбинаций.
Деквантование приближает вес как index × S. Некоторые ядра объединяют этот шаг с матричным умножением, другие сначала создают тензор более широкого типа. Тип восстановленных значений также различается.
Рассмотрим группу из пяти весов:
Процесс состоит из двух шагов, которые виджет ниже позволяет прокликать. На верхнем уровне: сначала мы вычисляем один масштаб для всей группы — он даёт сетку, на которую защёлкнутся все веса. Затем для каждого веса применяем собственно сжатие — защёлкиваем на ближайшую точку сетки (с выбором чётного при равном расстоянии) и сохраняем целочисленный индекс. Шаг 1 выполняется раз на группу; шаг 2 — раз на вес.
Чтобы задать дискретный набор, посмотрите на диапазон значений в группе весов и вычислите масштаб из данных. Вот общая формула для симметричной -битной квантизации:
Знаменатель — это , наибольший абсолютный индекс в симметричном -битном знаковом целом. Для int8 это ; для int4 — ; для int2 — .
Числитель — наибольший по модулю вес в группе: , где — те весов, которые вы квантизуете вместе.
Итак, замысел таков: поделить наибольший по модулю вес на наибольший абсолютный индекс. Это гарантирует, что самый крайний вес отображается ровно в точку сетки — без обрезки, с полным использованием сетки.
Для наших пяти примерных весов и int8 (, то есть знаменатель ):
Заметьте, что играет сразу две роли: это множитель (индекс × S восстанавливает fp32-значение) и шаг сетки (соседние индексы различаются на 1, так что соседние позиции сетки различаются ровно на ). Например, индекс 41 декодируется в 41 × 0.0748 ≈ 3.067, а индекс 42 — в 42 × 0.0748 ≈ 3.142; разрыв между ними ровно 0.0748, то есть . Одно число, два смысла.
Теперь, когда у нас есть , сетка следует прямо из него: каждая точка сетки — это индекс × S для некоторого целого индекса от -127 до +127:
Подставляя наш — каждая точка сетки есть индекс × 0.0748:
Чтобы защёлкнуть каждый вес на ближайшую точку сетки, вспомним, что шаг 1 лишь построил сетку; вот здесь и происходит собственно сжатие каждого веса. Для каждого веса в группе вычисляем его индекс:
Это даёт целочисленный индекс ближайшей точки сетки — та же механика округления к ближайшему из статьи о двоичном округлении: выбрать ближайшее представимое значение, при равном расстоянии выбирать чётное. Разница лишь в том, что множество представимых значений теперь гораздо меньше и явно перечислено. Сохраните однобайтовое целое (или 4 бита для int4); общий путешествует рядом, храня́сь по одному на группу, так что его стоимость амортизируется по всем весам группы. Для наших пяти весов с :
| Вес | Хранится (значение int8) | ||
|---|---|---|---|
3.1416 | 42.0 | 42 | 42 |
-1.7 | -22.7 | -23 | -23 |
0.0234 | 0.31 | 0 | 0 |
1.5 | 20.05 | 20 | 20 |
-9.5 | -127.0 | -127 | -127 |
Пять fp32-весов (20 байт) становятся пятью int8-значениями плюс один fp32-масштаб (9 байт всего) — в 2.2 раза меньше, и экономия только растёт с размером группы.
Выберите вес, чтобы увидеть полный цикл «квантизовать — защёлкнуть — деквантизовать» на тех же пяти значениях из формулы выше. Зелёные засечки — сетка int8 (индекс × S для каждого индекса от −127 до +127). Синяя точка — исходный fp32-вес; красная метка — точка сетки, на которую он защёлкивается. Строка потока показывает арифметику шагов 1 и 2: поделить на , округлить до ближайшего целого (именно оно сохраняется), затем при чтении умножить обратно на . Так 3.1416 / 0.0748 ≈ 42.0 округляется до 42 и реконструируется в 42 × 0.0748 ≈ 3.142 — почти идентично. Попробуйте 0.0234, чтобы увидеть, что происходит, когда крошечный вес проваливается в точку сетки 0.
Чтобы восстановить вес, железо читает маленькое целое и применяет обратную операцию:
где — хранимое целое, а — масштаб с плавающей точкой. Разные группы весов получают разный — поэтому одно и то же int8-значение 42 в двух разных каналах может декодироваться в два разных вещественных числа.
При восстановлении целое преобразуется в число с плавающей точкой и умножается на масштаб. Реализация может объединять эти операции и использовать fp16, bf16 или fp32.
Без ограничения диапазона округление к ближайшему узлу меняет значение не более чем на , если не учитывать ошибки арифметики при расчёте масштаба. Значения с модулем меньше округляются до нуля. Это граница скалярной ошибки, а не изменения предсказания модели.
Где это реально исполняется
На практике реальные развёртывания идут через эту арифметику одним из двух путей:
- Целочисленное матричное умножение: квантуем веса и активации, накапливаем целочисленные произведения, затем применяем соответствующие масштабы и преобразуем результат.
- Квантование только весов: активации остаются вещественными, а веса восстанавливаются для вычисления, часто внутри объединённого ядра.
Детали зависят от гранулярности и нулевых точек. Масштаб можно вынести за сумму, только если он общий для её слагаемых. Целочисленные вычисления воспроизводят выбранное квантованное приближение, а не исходную модель fp32 в точности.
Выбор гранулярности
Гранулярность определяет, какие веса имеют общий масштаб:
- На тензор: один масштаб для всего тензора; мало метаданных, но выбросы могут задать слишком грубый шаг.
- На канал: один масштаб на выходной канал с учётом различий между каналами.
- На группу: один масштаб на блок весов. Меньшие группы могут улучшить локальное разрешение, но требуют больше метаданных.
Поканальная группировка следует выходному измерению слоя. Для группового квантования нужен и размер группы. Форматы и реализации используют разные значения по умолчанию; проверяйте спецификацию чекпойнта и сравнивайте качество и размер поддерживаемых вариантов.
Почему это работает
Для идеального равномерного квантователя без ограничения диапазона скалярная ошибка ограничена . Формула дисперсии дополнительно предполагает равномерное распределение ошибки в этом интервале; для произвольных весов это не гарантировано. Округление нелинейно и не сохраняет автоматически расстояния или качество модели.
Шаг нормальных чисел с плавающей точкой постоянен внутри интервала между соседними степенями двойки и удваивается в следующем. Равномерное целочисленное квантование использует постоянный шаг внутри группы. Разрешение около нуля зависит от масштаба группы, а не порядка каждого значения.
Меняйте окно, чтобы сравнить сетки. Шаг плавающей точки растёт ступенчато с величиной числа; каждая строка целочисленного квантования использует равномерные уровни в показанном диапазоне.
Картина хранения при int4 с размером группы 64 выглядит так:
- 4 бита на вес = 0.5 байта
- плюс один fp16-масштаб на 64 веса ≈ 2 байта / 64 = 0.031 байта/вес
- итого ≈ 0.53 байта/вес
Вот почему «int4» на практике цитируют как «0.5 байта на параметр» — накладные расходы реальны, но малы.
Квантизуем MNIST-классификатор
Чтобы сделать это конкретным на модели, с которой мы уже знакомы, применим тот же рецепт к первому Dense-слою MNIST-классификатора из более ранней статьи серии — слою Dense(128, input_shape=(784,)) с матрицей весов (784, 128) в fp32. Возьмём гранулярность на канал: 128 групп, по одной на выходной канал, в каждой по 784 веса. Для каждого канала вычисляем . Если наибольший по модулю вес канала 0 равен 0.234, то , и сетка этого канала — : 255 точек с шагом 0.00184, растянутых ровно на диапазон канала. Канал 1 получает другой , так что то же int8-значение 42 декодируется в — своё вещественное число для каждого канала:
import keras
import numpy as np

model = keras.models.load_model('mnist_classifier.keras')
W = model.layers[0].kernel.numpy()         # (784, 128), fp32
print(W.shape, W.dtype, W.nbytes)          # (784, 128) float32 401408

INT8_MAX = 127

# Per-channel int8: one scale per output channel (128 channels)
scales = np.maximum(np.abs(W).max(axis=0) / INT8_MAX, np.finfo(np.float32).tiny)  # (128,), fp32

# Quantize: divide by scale (broadcasts), round to nearest int, cast to int8
W_q = np.round(W / scales).astype(np.int8) # (784, 128), int8

# Dequantize on read: cast to fp32, multiply by per-channel scale
W_back = W_q.astype(np.float32) * scales

# Storage: 100,352 bytes (int8 weights) + 128 * 4 = 512 bytes (scales)
# vs original 401,408 bytes — ~4× smaller, scale overhead ~0.13%
Матрица первого слоя уменьшается с 401 408 байт до 100 352 байт плюс 512 байт масштабов. W_back восстанавливает приближение float32 и само по себе не экономит память. Для оценки качества присвойте восстановленные веса копии модели и проверьте её на отложенных данных; этот фрагмент не содержит такого результата.
Применим тот же рецепт к весам (128, 10) второго слоя — и получим картину по всей модели:
| Слой | Форма | fp32-веса | int8-веса | Масштабы на канал | Итого int8 |
|---|---|---|---|---|---|
| Dense 1 | (784, 128) | 401 408 Б | 100 352 Б | 128 × 4 = 512 Б | 100 864 Б |
| Dense 2 | (128, 10) | 5 120 Б | 1 280 Б | 10 × 4 = 40 Б | 1 320 Б |
| Итого | 406 528 Б (~397 КиБ) | 102 184 Б (~100 КиБ) |
Две матрицы занимают 406 528 байт в fp32 и 102 184 байта в данном представлении int8, включая масштабы. Сохранение 138 смещений в fp32 добавляет по 552 байта. Итого параметры занимают около 407 КБ против 103 КБ, почти четырёхкратное сокращение. Экономия при выполнении зависит от того, хранит ли реализация веса в сжатом виде и использует ли их напрямую.