Floats, bfloat і те, як біти формують пам’ять моделі
Нейронна мережа зберігає вивчені параметри, включаючи ваги та зміщення. Кількість параметрів, помножена на байти на параметр, дає пам’ять, необхідну для цих параметрів. Виконувана пам’ять також включає активації, тимчасові буфери та, залежно від робочого навантаження, кеші або стан навчання.
Візьмемо невелику мережу, яку ми навчили в Стаття МНІСТ — щільний класифікатор із двома шарами Keras Dense: 784 згладжених піксельних входу надходять у прихований шар із 128 нейронів, який надходить у вихідний рівень із 10 нейронів (по одному на цифру).
Скорочення для цієї форми: 784 → 128 → 10, де 784 – це вхідний розмір, а не шар. Кількість параметрів складає:
З політикою fp32 за замовчуванням ці параметри займають 407 080 байт: приблизно 407 КБ, або 398 КБ. Це виключає іншу пам’ять, яку використовує запущена модель.
Репозиторії моделей часто містять картку моделі з описом моделі та її навчання. Метадані файлу ваги також можуть показувати кількість параметрів і dtypes зберігання.
На знімку екрана нижче показано бічну панель Hugging Face для PaddleOCR-VL-1.5 із округленою кількістю параметрів і вказаним типом тензора:
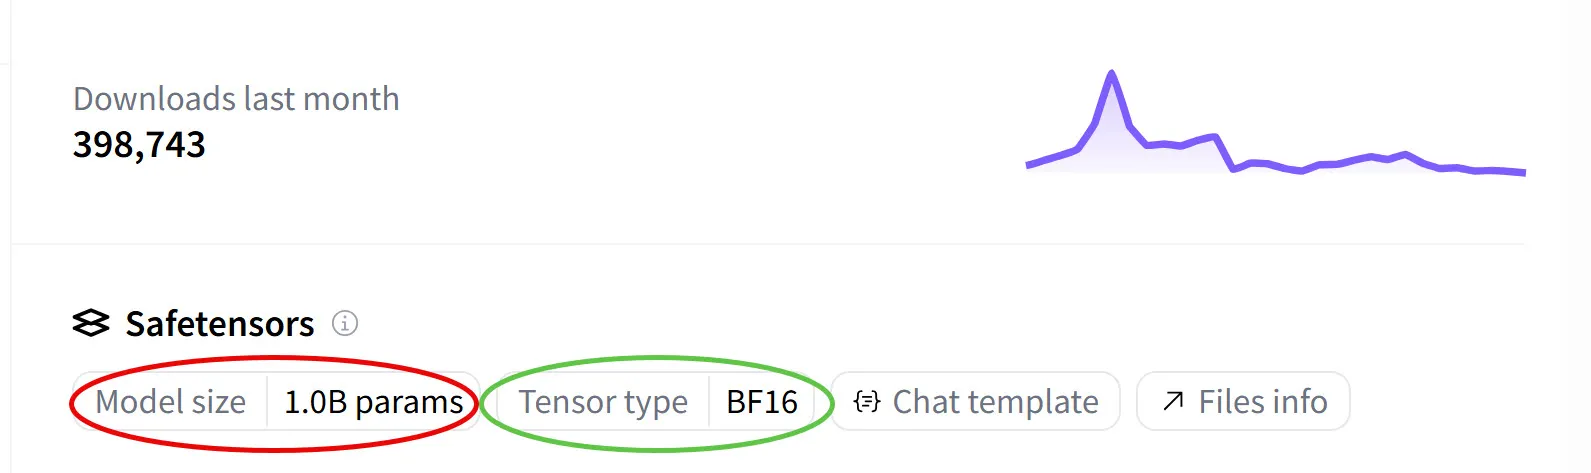
Розмір моделі повідомляє кількість параметрів. Тип тензора повідомляє про сховище dtype, скорочення від типу даних. dtype тензора описує його елементи, такі як float32, int8 або bfloat16; type() Python описує сам об’єкт.
У коді перевірте .dtype; друковане представлення відрізняється між бібліотеками:
>>> import torch
>>> torch.tensor([0.5], dtype=torch.bfloat16).dtype
torch.bfloat16

>>> import numpy as np
>>> np.array([0.5], dtype=np.float16).dtype
dtype('float16')
Hugging Face зчитує ту саму інформацію безпосередньо з файлу safetensors — safetensors — це формат файлу Hugging Face для збереження та розповсюдження навчених вагових коефіцієнтів моделі, а dtype кожного тензора зберігається в його метаданих, що відображається на бічній панелі як «Тип тензора».
BF16 позначає bfloat16, 16-бітний формат із плаваючою комою, розроблений Google. Він використовує ту саму структуру знака/експоненти/дробу, що й інші формати нижче, з розподілом бітів, відмінним від двійкового IEEE16. Контрольна точка може містити тензори з більш ніж одним dtype, тому перевіряйте її метадані, коли вам потрібна точна кількість пам’яті.
Тож кроки для обчислення обсягу пам’яті моделі такі ж, як і для MNIST, лише з більшими числами. Фігура 1.0B — це сума параметрів на кожному шарі моделі — та сама арифметика для кожного шару, яку ми робили вручну для MNIST, за винятком того, що Hugging Face вже зробив це за нас, пройшовши кожен тензор у файлі safetensors і додавши кількість елементів.
Отже, на картці зазначено 1 мільярд параметрів («B» — скорочення від billion, ). Помножимо це на 2 байти на вагу bf16, і ми отримаємо ваговий слід моделі:
Це лише оцінка ваги зберігання. Висновок також потребує активацій, робочих областей, а іноді й кешу KV, що може стати серйозною витратою з довгими послідовностями або великими пакетами. Для навчання додатково потрібні градієнти, стан оптимізатора та збережені активації.
Для моделі з параметрами 7B одні ваги займають приблизно 28 ГБ у fp32, 14 ГБ у fp16/bf16 або 7 ГБ у int8 до метаданих квантування. Модель 70B потребує приблизно 140 ГБ для ваги fp16. Чи підійде будь-яка модель до пристрою також залежить від інших вимог до пам’яті.
Зменшення точності може зменшити вагу пам’яті: fp16 і bf16 використовують удвічі менше байтів, ніж fp32, тоді як 8- або 4-бітне квантування стискає ще більше. Якість і швидкість залежать від моделі, методу перетворення та обладнання; їх потрібно виміряти.
Не кожне число в мережі є вагою
Працююча мережа використовує кілька видів тензорів. У статті про зворотне поширення пояснюється, звідки беруться параметри, активації та градієнти.
Ваги та активації виникають як у висновках, так і в навчанні. Під час логічного висновку проміжні тензори можуть бути звільнені, коли вони не знадобляться подальшій операції, хоча залишкові зв’язки та робочі області можуть підтримувати кілька тензорів. Навчання зазвичай зберігає активації для зворотного поширення; checkpointing може обміняти частину цієї пам’яті на повторне обчислення. Для активації не потрібно використовувати той самий dtype, що й ваги.
За висновком, LLM на основі трансформаторів також містять KV-кеш — ключі та значення, кешовані в минулих токенах під час авторегресійної генерації, тому увага не потребує повторного обчислення для кожного нового токена. Часто зберігається в fp16 або fp8, щоб зберегти пам’ять у довгих контекстах.
Під час навчання з’являються ще дві категорії:
- Градієнти записують, як змінюються втрати з кожним параметром. Їх величини можуть варіюватися в широких межах, що робить числовий діапазон важливим.
- Стан оптимізатора залежить від оптимізатора. Адам зберігає дві поточні статистики для кожного параметра; їх dtype зберігання залежить від реалізації та політики точності.
У коді dtype живе в кількох конкретних місцях. Ось відповідний уривок із нашого навчання МНІСТ ст:
# Input data — explicitly cast to float32
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0

# Model — Dense layers default to fp32 for weights and biases (no dtype= passed)
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,)),
    keras.layers.Dense(10, activation="softmax"),
])

# Optimizer — owns its own state, allocated separately
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)
.astype("float32") встановлює dtype вхідного масиву. Шари Keras мають власні змінні та обчислювальні dtypes, які визначають збереження та обчислення параметрів. Тут стандартна політика використовує fp32 для обох. Ви можете встановити іншу політику для кожного шару:
# Same architecture, but weights and biases stored in bf16
model = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(784,), dtype="bfloat16"),
    keras.layers.Dense(10, activation="softmax", dtype="bfloat16"),
])
# PyTorch equivalent — nn.Linear takes the dtype directly
model = nn.Sequential(
nn.Linear(784, 128, dtype=torch.bfloat16),
nn.ReLU(),
nn.Linear(128, 10, dtype=torch.bfloat16),
)У Keras dtype="bfloat16" встановлює як змінні, так і обчислювальні dtypes. Політика змішаної точності, наприклад "mixed_bfloat16", замість цього зберігає змінні у fp32, використовуючи для обчислення bf16. У PyTorch конструктор встановлює збереження параметрів; вхідні дані та операції мають бути сумісними або оброблятися автокастом. Dtypes градієнта та стану оптимізатора також залежать від реалізації, тому вони не можуть бути визначені незалежно від налаштувань шару.
Змішана точність використовує різні цифрові формати для різних операцій або ролей зберігання. У цій статті «модель bf16» стосується зберігання ваги, якщо не вказано інше.
Одне розташування Адама зі змішаною точністю використовує 16 байт на параметр перед активаціями:
- bf16 ваги: 2 байти
- bf16 градієнти: 2 байти (така ж форма, що й ваги)
- fp32 Моменти Адама: 8 байтів (два моменти × 4 байти кожен)
- fp32 основна копія ваги (зберігається оптимізатором для стабільних оновлень): 4 байти
Згідно з цими припущеннями, пам’ять, пов’язана з параметрами, у вісім разів перевищує пам’ять ваги bf16. Це приклад обліку, а не фіксована вимога: головні копії, dtypes градієнта, варіанти оптимізатора та шардинг змінюють загальну суму. Активації додають вартість, яка залежить від робочого навантаження.
Для параметрів 7B для цього розташування потрібно приблизно 112 ГБ плюс активації та буфери, у порівнянні з 14 ГБ лише для ваг bf16. Повне навчання може зменшити обсяг пам’яті пристрою через шардинг або розвантаження; Точне налаштування адаптера змінює облік шляхом навчання лише піднабору параметрів.
Стандартні значення для Python і JavaScript з плаваючою комою
Перш ніж дивитися на цифрові формати, які насправді використовує ML, корисно почати зі знайомих типів чисел, які ми вже використовуємо щодня в Python і JavaScript:
| Мова | Добрий | Тип | Подробиці |
|---|---|---|---|
| Python | Ціле число (без десяткових знаків, точне) | внутр | Довільно-точний. CPython збільшує резервне сховище за потреби, тому 2**1000 просто працює і результат точний. |
| Float (64-розрядний IEEE-754 подвійний) | плавати | У такому ж форматі ми проведемо розпакування решти статті. Числове корисне навантаження використовує 8 байтів; об’єкт Python потребує додаткового сховища. | |
| JavaScript | Ціле число (без десяткових знаків, точне) | BigInt | Ціле число довільної точності, додане пізніше як окремий тип. Написано з an n суфікс (наприклад, 5n). Найближчий еквівалент Python внутр. |
| Float (64-розрядний IEEE-754 подвійний) | Номер | Той самий формат, що й у Python плавати. JavaScript використовує його як для цілих чисел, так і для дробів; немає окремого цілого типу за замовчуванням. |
float Python у типових збірках CPython і Number JavaScript використовують двійковий файл IEEE64. Це пояснює їх спільне представлення 0.1 і результат 0.1 + 0.2 = 0.30000000000000004. Поведінка на рівні мови все ще відрізняється: ділення Python на нуль викликає виключення, тоді як JavaScript може повертати нескінченність. Зберігання об’єктів також додає додаткові витрати, окрім восьмибайтового числового корисного навантаження.
Механіка того, як ці 64 біти розбиваються на знак, експонента та мантиса, чому експонента зберігається з зміщення замість доповнення до двох і як 0.1 округляється — я детально розглянув у попередніх статтях цієї серії. Усе, що там є, стосується безпосередньо обох мов, тому що це той самий 64-розрядний формат.
Звичайні літерали з плаваючою комою використовують ці значення за замовчуванням. Явні масиви та тензори пропонують інші формати зберігання; JavaScript також надає Float32Array. Фреймворки ML додають такі формати, як bf16 і низькорозрядні квантовані представлення.
Як перетворення втрачають біти: від мовних floats до ML dtypes
Щоразу, коли значення переміщується з одного числового формату в інший — Python float у int, float у int8, fp64 у fp16 — є шанс, що біти не підходять. Щось потрібно дати, і куди підуть відсутні біти, залежить від вихідного та цільового форматів.
Найпростіший випадок — float → int: відкинути все, що виходить за точку основи.
>>> int(3.7)
3
>>> int(-3.7)
-3               # truncates toward zero — drops the fractional bits
>>> import math
>>> math.floor(-3.7)
-4               # floor rounds toward -infinity instead
Корисний спосіб зрозуміти скорочення — реконструювати двійкове значення та відкинути його дробову частину. Фактичні інструкції з перетворення залежать від реалізації.
Наприклад, візьмемо 5.75. У двійковій системі це 101.11 — три біти перед точкою основи (101 = 4 + 1 = 5) і два після (.11 = 0,5 + 0,25 = 0,75). Однак IEEE-754 не зберігає це таким чином; він нормалізує число, щоб перед точкою основи було рівно один 1, і запам’ятовує зсув експоненти:
   101.11   →   1.0111 × 2^2
   ^^^ ^^       ^ ^^^^   ^
   │   │        │ │      └── exponent: how far to shift the radix back
   │   │        │ └───────── mantissa (fractional part of the 1.xxx form)
   │   │        └─────────── the implicit leading 1 (not stored)
   │   └──────────────────── original fractional bits
   └──────────────────────── original integer bits
Збережений дріб починається з 0111, а незміщеним показником є 2. Відновлення неявного початкового 1 і зміщення двійкової точки пояснює цілочисельне перетворення:
   mantissa:    1.0111
   shift by 2:  101.11
                ^^^ ^^
                │   └── fractional bits → discarded
                └────── integer bits    → 101 = 5
Вилучення .11 видаляє 0,75, тому int(5.75) повертає 5. Це округлення до нуля, що також називається скороченням, а не округлення до найближчого цілого числа. Отже, int(-3.7) повертає -3.
Перетворення на вужчі dtypes можуть обрізати, округляти, переповнюватися або викликати помилку. API має значення: конструктор може відхилити ціле число, що виходить за межі діапазону, навіть якщо приведення існуючого тензора обертає його.
>>> torch.tensor([3.7, -3.7], dtype=torch.int8)       # float → int, truncates toward zero
tensor([3, -3], dtype=torch.int8)                     # → fractional bits dropped on each element

>>> torch.tensor([1000, 1001], dtype=torch.int64).to(torch.int8)      # int → int8, overflows (int8 max is 127)
tensor([-24, -23], dtype=torch.int8)                  # → low 8 bits kept, neighbours wrap together

>>> torch.tensor([1e5, -1e10], dtype=torch.float16)   # fp64 → fp16, overflows (fp16 max is ~65504)
tensor([inf, -inf], dtype=torch.float16)              # → saturate to ±inf; magnitudes are lost

>>> torch.tensor([2**24 + 1, 2**24 + 2], dtype=torch.float32)  # int → fp32, exceeds mantissa precision
tensor([16777216., 16777218.], dtype=torch.float32)            # → +1 rounds away (24-bit mantissa); +2 is exact
Ці приклади ілюструють чотири результати перетворення:
| Візерунок | Від | до | приклад | Результат |
|---|---|---|---|---|
| Скорочення | плавати | внутр | 3.7 → int8 | 3 |
| Обертання | внутр | вужчий міжн | 1000 → int8 | -24 |
| Насиченість до нескінченності | плавати | вужчий поплавок | 1e5 → fp16 | inf |
| Втрата точності | внутр | плавати | 2^24 + 1 → fp32 | 2^24 |
Огортання. Приведення існуючого цілочисельного тензора до int8 зберігає його молодші вісім бітів. Таким чином 1000 стає -24 у доповненні двох. Це не означає, що кожен конструктор приймає введення за межами діапазону.
Переповнення числа з плаваючою комою. З округленням до найближчого, перетворення 1e5 на fp16 дає inf, оскільки найбільше кінцеве значення fp16 становить 65 504. Інші режими округлення можуть дати інші результати переповнення.
Втрата точності. 2^24 + 1 → fp32 стає 2^24. Мантиса fp32 становить 24 біти (23 явних + 1 неявний), тому кожне ціле число від 0 до 2^24 (16 777 216) є точно представленим, але крім цього інтервал між представленими значеннями подвоює кожен ступінь 2. Ціле число 2^24 + 1 потрапляє між двома представленими значеннями fp32 і округлюється до ближчого (2^24, оскільки +1 рівно на половині і рівний до рівних). Це та сама історія, чому fp64 починає втрачати точність цілого числа на 2^53 ≈ 9 × 10^15 — Number.MAX_SAFE_INTEGER JavaScript є точно 2^53 − 1.
Поведінка перетворення залежить від значення, вихідного та цільового форматів, режиму округлення та API. Перевірте їх разом, а не припускайте, що кожне звужувальне перетворення поводиться ідентично.
Вихід за межі стандартної мови
Екосистема ML надає набагато ширше меню, ніж у Python або JavaScript. Кожен основний чисельний фреймворк — NumPy, PyTorch, JAX і TensorFlow — дозволяє вам явно вибрати dtype. Ось така сама операція в чотирьох фреймворках:
import torch
x = torch.tensor([0.5])                        # fp32 by default — 4 bytes
y = torch.tensor([0.5], dtype=torch.float16)   # fp16 — 2 bytes
z = torch.tensor([0.5], dtype=torch.bfloat16)  # bf16 — 2 bytes
w = torch.tensor([0.5], dtype=torch.float64)   # fp64 — 8 bytes, same as Python float
import tensorflow as tf
x = tf.constant([0.5]) # fp32 by default — 4 bytes
y = tf.constant([0.5], dtype=tf.float16) # fp16 — 2 bytes
z = tf.constant([0.5], dtype=tf.bfloat16) # bf16 — 2 bytes
w = tf.constant([0.5], dtype=tf.float64) # fp64 — 8 bytesimport numpy as np
x = np.array([0.5], dtype=np.float32) # 4 bytes per element
y = np.array([0.5], dtype=np.float16) # 2 bytes
# NumPy core has no bfloat16 — you need the `ml_dtypes` package, or JAX/TF/Torch arraysimport jax.numpy as jnp
x = jnp.array([0.5], dtype=jnp.bfloat16) # bf16 — 2 bytesЦі конструктори дозволяють вибрати елемент dtype. NumPy не включає bf16 серед своїх основних dtypes; розширення можуть надати його. PyTorch, JAX і TensorFlow надають bf16, хоча підтримка роботи залежить від пристрою та серверної частини.
Для Python літерал 0.5 все ще є 64-бітним дублем — перетворення відбувається під час створення тензора. Внутрішньо кожен елемент займає 8, 4, 2 або 2 байти залежно від dtype. На fp8 він стає 1 байтом; в int4, половина байта.
Щоб побачити, що насправді кодують ці байти — і чому їх удвічі не скорочують репрезентований діапазон навпіл — нам потрібно поглянути на формат нижче.
Формати з плаваючою комою, які використовуються в ML
Сучасне ML використовує кілька форматів із плаваючою комою, і всі вони мають однакову структуру трьох полів, успадковану від IEEE-754:
- Знак (1 біт) — позитивний або негативний.
- Експонента — як далеко зсунути точку виразки, зберігається як зсув двійковий.
- Мантиса (значуще) — початкові цифри числа в нормалізованій науковій формі, з неявним початковим
1.
Для нормальних значень експонента задає масштаб, а значуще – точність. Спеціальні кодування обробляють значення нуля, нескінченності, NaN і субнормальні значення, але підтримка різна: деякі варіанти fp8 пропускають нескінченність, а деякі апаратні засоби скидають субнормальні значення до нуля.
| Формат | Всього біт | Знак | Експонента | Мантиса | Байти/параметр |
|---|---|---|---|---|---|
| fp64 (подвійний IEEE-754) | 64 | 1 | 11 | 52 | 8 |
| fp32 (IEEE-754 одинарний) | 32 | 1 | 8 | 23 | 4 |
| bf16 (Brain Float 16) | 16 | 1 | 8 | 7 | 2 |
| fp16 (IEEE-754 binary16) | 16 | 1 | 5 | 10 | 2 |
Два 16-бітних формати по-різному розподіляють той самий бюджет. Переміщення одного біта від частки до експоненти подвоює відстань у заданому нормальному показнику степеня та значно розширює діапазон показника степеня; це не просто подвоює найбільше значення.
[1, 4) (128 per octave; gap doubles at 2)Для нормальних значень із дробовими бітами інтервал становить у і удвічі більший у . bf16 досягає приблизно з інтервалом близько 0,008 біля одиниці; fp16 досягає 65 504 з інтервалом близько 0,001 біля одиниці.
Смужка в нижній частині віджета робить проміжок видимим: якщо вибрано bf16, ви можете бачити окремі галочки, розташовані через [1, 2] — ці проміжки є межею точності формату в одиничному масштабі. Переключіться на fp16, і галочки зливаються в суцільну лінію, оскільки інтервал зменшився на субпіксель. Сітка все ще дискретна; він достатньо щільний, щоб ви більше не могли помітити дискретність — це саме те, що тут означає «більша точність».
Смуга також простягається через наступну октаву [2, 4) (повз пунктирний маркер у 2), щоб було зрозуміло, що це подвоєння проміжків не є унікальним для діапазону [1, 2) — однакова кількість позначок (по одному на стан мантиси) розтягується через інтервал, який вдвічі ширший, тому візуальний відстань у правій половині вдвічі перевищує ліву. Перетягніть повзунок до значення низької мантиси (наприклад, M=4), і подвоєння стане очевидним.
Для конкретності, перші кілька репрезентованих значень у [1, 2] для кожного стилю:
| bf16 (128 значень, розрив = 1/128) | fp16 (1024 значення, розрив = 1/1024) |
|---|---|
1.0 | 1.0 |
1.0078125 | 1.0009765625 |
1.015625 | 1.001953125 |
1.0234375 | 1.0029296875 |
1.03125 | 1.00390625 |
| … | … |
1.9921875 | 1.9990234375 |
(2.0) | (2.0) |
Кожне послідовне значення bf16 припадає точно на кожне 8-е значення fp16 — сітка bf16 у цій октаві є суворою підмножиною fp16, лише сім із кожних восьми вилучених галочок. Це співвідношення точно дорівнює (fp16 має 10 бітів мантиси, bf16 має 7) — кожен додатковий біт мантиси подвоює кількість значень, які можна представити на октаву.
Відстань рівномірна в межах кожного нормального інтервалу . Він подвоюється на наступному інтервалі та стає тоншим у напрямку до нуля до субнормальної області, де відстань постійна.
Ось це для bf16 через кілька октав:
| bf16 октава | Розрив |
|---|---|
[1, 2) | 1/128 ≈ 0.0078 |
[2, 4) | 2/128 = 1/64 ≈ 0.0156 |
[4, 8) | 4/128 = 1/32 ≈ 0.0313 |
| … | … |
[1024, 2048) | 1024/128 = 8 |
bf16 пропонує ширший діапазон експонент; fp16 пропонує кращу точність при порівнянних нормальних величинах. Значення, що перевищують діапазон формату, можуть переповнюватись, тоді як дуже малі значення можуть втратити точність або опуститися до нуля. Обидва формати залишаються корисними, залежно від робочого навантаження та апаратного забезпечення.
Чому біти bf16 розділені так, як вони є
Google розробив bf16 для ML, зберігши вісім біт експоненти fp32 і зменшивши збережену частку з 23 біт до семи. Таким чином, його діапазон експонент подібний до fp32, але зі значно нижчою точністю.
За того самого нормального показника ступеня відстань bf16 у разів більша, ніж відстань fp32. Ось як 1.005 округлює в трьох форматах:
| Формат | Збережена вартість | Помилка |
|---|---|---|
| fp32 | 1.005 (фактично точний) | ~10⁻⁸ |
| fp16 | 1.0048828125 | ~1.2 × 10⁻⁴ |
| bf16 | 1.0078125 | ~2.8 × 10⁻³ |
fp16 точніший для 1.005. На іншому кінці свого діапазону 1e-7 можна представити приблизно як ненульове fp16 subnormal: воно округлюється приблизно до 1.192e-7. З округленням до найближчого 1e-8 замість цього округлює до нуля; bf16 може представляти значення поруч із ним.
Переповнення, недоповнення та помилка округлення можуть вплинути на навчання. Переповнення може поширювати нескінченність або NaN; underflow може видалити невеликі градієнти. Повторне округлення також може завадити невеликим оновленням змінити вагу з низькою точністю. Сам по собі більш широкий діапазон не гарантує стабільного навчання.
Масштабування втрат збільшує втрати перед зворотним розповсюдженням і зменшує масштаб градієнтів перед оновленням оптимізатора, допомагаючи fp16 зберігати малі градієнти. Динамічне масштабування також реагує на переповнення. PyTorch надає torch.amp.GradScaler("cuda"). bf16 зазвичай уникає необхідності масштабування втрат через його більш широкий діапазон.
Той самий компроміс для кожної ширини
Перетворення з fp32 на bf16 просте, але не обов’язково з бітовим зсувом: Cloud TPU використовує округлення до найближчого парного і скидає субнормальні значення bf16 до нуля. Перетворення bf16 назад у fp32 є точним, але не може відновити вже втрачені біти.
fp16 залишається корисним, якщо його додаткові три дробові біти або апаратна підтримка відповідають робочому навантаженню. bf16 часто зручний для навчання, але жоден формат не є універсальною заміною іншого.
Кожен формат має свій власний кремній
Власна арифметика низької точності може підвищити пропускну здатність, а компактне сховище може зменшити трафік пам’яті, навіть якщо обчислення використовує ширший dtype. Фактична швидкість залежить від ядра та навантаження.
Приклади апаратної підтримки:
| Формат | Де він працює нативно |
|---|---|
| fp64 / fp32 | Широко підтримується процесорами та графічними процесорами; пропускна здатність залежить від пристрою. |
| fp16 | NVIDIA Tensor Cores починаючи з Volta (V100, 2017); інші постачальники пішли. |
| int8 | NVIDIA Turing Tensor Cores (T4, 2018), серед інших прискорювачів. |
| bf16 | Google TPU v2 (2017), NVIDIA Ampere (A100, 2020), Intel AVX-512 BF16, Arm Armv8.6-A BF16. |
| fp8 (E4M3, E5M2) | NVIDIA Hopper (H100, 2022), AMD CDNA 3 (MI300), Intel Gaudi 2/3. |
| int4 | NVIDIA Turing Tensor Cores представила режими int4; підтримка залежить від покоління та API. |
Матричні блоки, такі як Tensor Cores і TPU MXU, прискорюють блоки операцій множення-накопичення. Точність операнда, точність накопичення та поведінка округлення залежать від інструкції; Матрична операція не повинна мати таку саму семантику округлення, як один скалярний FMA.
Зберігання молодших розрядів зменшує розмір збережених тензорів. Для швидшого виконання додатково потрібні відповідні ядра, апаратне забезпечення та достатньо роботи, щоб отримати від них вигоду. Витрати на перетворення та інші вузькі місця можуть переважити арифметичний виграш.
Окремо перевірте формат контрольної точки та підтримку середовища виконання для вашого пристрою. Упаковані ваги int4, наприклад, можуть бути деквантовані для обчислень із плаваючою комою без власних інструкцій матриці int4. Порівняйте підтримуваний шлях, а не виводьте швидкість з назви dtype.
З нетерпінням: fp8
Два поширених варіанти fp8 розподіляють свої вісім бітів по-різному:
| Формат | Знак | Експонента | Мантиса | Використовується для |
|---|---|---|---|---|
| fp8 E4M3 | 1 | 4 | 3 | ваги прямого проходу та активації (зі зміщенням точності) |
| fp8 E5M2 | 1 | 5 | 2 | градієнти (зі зміщенням діапазону) |
У документі FP8 Formats for Deep Learning описано E4M3 і E5M2 та їхні передбачувані ролі в навчанні змішаної точності.
Загальний рецепт використовує E4M3 для операндів прямого проходу та E5M2 для градієнтів. Коефіцієнти масштабу відображають значення тензора в доступному діапазоні. У прикладі нижче використовується одна шкала для всього тензора; в інших рецептах використовуються менші блоки або інші стратегії масштабування.
import torch

w_fp32 = torch.randn(1024, 1024, dtype=torch.float32) * 0.1

# Per-tensor scale: |max| / fp8_max maps the tensor's range into fp8's
FP8_E4M3_MAX = 448.0
scale = (w_fp32.abs().max() / FP8_E4M3_MAX).clamp_min(torch.finfo(torch.float32).tiny)

# Quantize: divide by scale, then cast to fp8
w_fp8 = (w_fp32 / scale).to(torch.float8_e4m3fn)

# Reconstruct on read: cast back, multiply by scale
w_back = w_fp8.to(torch.float32) * scale
Такі бібліотеки, як NVIDIA Transformer Engine, надають рецепти fp8, які керують масштабуванням і станом вищої точності. Просте збереження тензора як torch.float8_e4m3fn не реалізує цей рецепт навчання.
Використовуйте повзунок, щоб змінити максимальну величину тензора. Зелені галочки показують репрезентативні значення fp8 після застосування шкали, а сині крапки показують зразки даних. Це ілюструє масштабування, а не повне навчання чи реалізацію висновку.
Чому моделі допускають менше бітів
Багато мереж допускають деякі помилки округлення, але окремі ваги та канали все одно можуть бути чутливими. Якість квантування залежить від розподілу помилок, викидів, накопичення та завдання. Помилки не обов’язково скасовуються, коли значення комбінуються.
Наведені нижче дослідження демонструють корисні низькоточні методи за конкретних умов оцінювання. Вони не гарантують незмінну якість для кожної моделі або встановлюють, що більші моделі завжди допускають менше бітів.
Глибоке стиснення поєднало скорочення, квантування та кодування для стиснення мереж, включаючи AlexNet. Mixed Precision Training продемонстрував тренування з арифметикою fp16 і основними вагами fp32, зберігаючи при цьому точність у своїх експериментах.
Для LLM LLM.int8() поєднує множення матриці int8 із вищою точністю для викидів, тоді як GPTQ націлено на квантування низької бітової ваги. QLoRA закріплює квантовану базову модель і навчає адаптери. BitNet b1.58 замість цього тренується з потрійними вагами; це не обіцянка того, що довільну попередньо навчену модель можна перетворити на три значення без втрати якості.
Квантування - це та сама ідея, якщо взяти далі
Тут ми зосереджуємося на уніфікованому цілочисельному квантуванні: кожна вага представлена маленьким цілим числом і спільною шкалою, іноді з нульовою точкою. Інші схеми, такі як NF4, використовують неоднорідні рівні.
Перш ніж ми перейдемо до механіки, ось що насправді купує квантування:
- Пам’ять: вагові навантаження int8 і упакованого int4 відповідно в чотири і вісім разів менші за fp32, до метаданих.
- Швидкість: зменшений трафік пам’яті та відповідні низькоточні ядра можуть допомогти, але перетворення та накладні витрати на ядро також мають значення.
- Розгортання: деякі прискорювачі вимагають цілочисельних моделей; інші підтримують декілька форматів.
- Енергія: менше переміщення даних і нижча точність арифметики можуть зменшити споживання енергії залежно від апаратного забезпечення та робочого навантаження.
Існує два потоки фактичного виконання квантування, залежно від того, коли в життєвому циклі моделі ви це робите. Вони мають однакову арифметику прив’язки до сітки, яку ми розглянемо в наступному підрозділі.
Квантування після навчання (PTQ) перетворює навчену модель без повторного навчання її параметрів. Деякі методи вимагають даних калібрування та значних обчислень. GPTQ і AWQ є прикладами; бібліотеки та середовища виконання підтримують різні алгоритми та формати контрольних точок, тому перевірте сумісність.
Навчання з урахуванням квантування (QAT) імітує квантування під час навчання, щоб параметри могли адаптуватися до його помилки. Для цього потрібне навчання або процедура тонкого налаштування, але не обов’язково позначені дані: LLM-QAT використовує дистиляцію. Те, чи покращується PTQ, залежить від моделі, розрядності та оцінки.
Менша бітова ширина зазвичай залишає менше місця для точного представлення значень. Оцініть стиснуту модель щодо завдань, які вона повинна виконувати; лише економія пам’яті не забезпечує прийнятної якості.
Швидкий рецепт
У цьому прикладі симетричного цілого числа ми зберігаємо одне ціле число на вагу та одну шкалу на групу. Ми використовуємо індекси від -127 до 127 для int8: 255 рівнів. Аналогічний симетричний діапазон int4, від -7 до 7, має 15 рівнів; інші схеми можуть використовувати всі 256 або 16 бітові шаблони.
Деквантування наближає вагу як index × S. Деякі ядра поєднують цей крок із множенням матриці; інші спочатку матеріалізують ширший тензор. Dtype реконструкції також різниться.
Розглянемо цю групу з п’яти ваг:
Тепер цей процес складається з двох кроків, які можна виконати інтерактивно за допомогою віджета нижче. На високому рівні: спочатку ми обчислюємо одну шкалу для всієї групи — це дає нам сітку, до якої будуть прив’язані всі ваги. Потім для кожної ваги ми застосовуємо фактичне стиснення — прив’язуємо до найближчої точки сітки (використовуючи округлення до найближчого навіть для зв’язків) і зберігаємо цілочисельний індекс. Крок 1 виконується один раз на групу; крок 2 виконується один раз на вагу.
Щоб визначити дискретний набір, подивіться на діапазон значень у групі ваг і обчисліть масштаб на основі даних. Ось загальна формула для симетричного -бітового квантування:
Знаменник є — найбільший абсолютний індекс у симетричному -розрядному цілому числу зі знаком. Для int8 це ; для int4 це ; для int2 це .
Чисельник — це найбільша абсолютна вага в групі: , де — це ваги , які ви квантуєте разом.
Отже, проект такий: ділимо найбільшу абсолютну вагу на найбільший абсолютний індекс. Це гарантує, що найекстремальніша вага точно відповідає точці сітки — без відсікання, повне використання сітки.
Для наших п’яти зразків ваг згори та int8 (, тому знаменник = ):
Зверніть увагу, що виконує дві ролі одночасно: це множник (index × S відновлює значення fp32) і інтервал сітки (послідовні індекси відрізняються на 1, тому послідовні позиції сітки відрізняються рівно на ). Наприклад, індекс 41 декодує до 41 × 0.0748 ≈ 3.067, а індекс 42 декодує до 42 × 0.0748 ≈ 3.142 — розрив між ними дорівнює точно 0.0748, тобто . Те саме число, два значення.
Тепер, коли ми маємо , сітка слідує безпосередньо: кожна точка сітки є index × S для деякого цілого індексу від -127 до +127:
Підключаємо наш — кожна точка сітки index × 0.0748:
Щоб прив’язати кожну вагу до найближчої точки сітки, пам’ятайте, що крок 1 створив лише сітку; саме тут відбувається фактичне стиснення на вагу. Для кожної ваги у групі обчисліть її індекс:
Це дає цілочисельний індекс найближчої точки сітки — та сама механіка округлення до найближчого з бінарне округлення статті: виберіть найближче значення, яке можна представити, розірвіть зв’язки до парного. Єдина відмінність полягає в тому, що набір значень, які можна представити, тепер набагато менший і явно перерахований. Зберігає 1-байтове ціле число (або 4 біти для int4); спільний подорожує поруч, зберігаючи один раз на групу, тому його вартість амортизується для кожної ваги в групі. Для наших п’яти ваг з :
| Вага | Збережено (значення int8) | ||
|---|---|---|---|
3.1416 | 42.0 | 42 | 42 |
-1.7 | -22.7 | -23 | -23 |
0.0234 | 0.31 | 0 | 0 |
1.5 | 20.05 | 20 | 20 |
-9.5 | -127.0 | -127 | -127 |
П’ять вагових коефіцієнтів fp32 (20 байтів) стають п’ятьма значеннями int8 плюс одна шкала fp32 (загалом 9 байтів) — у 2,2 раза менше, і економія лише зростає разом із розміром групи.
Виберіть вагу, щоб побачити повний цикл квантування–прив’язка–деквантування для тих самих п’яти значень із формули вище. Зелені галочки позначають сітку int8 (index × S для кожного індексу від −127 до +127). Синя крапка — це оригінальна вага fp32; червона позначка — це точка сітки, до якої він прив’язується. Рядок потоку показує арифметику з кроку 1 і кроку 2: розділити на , округлити до найближчого цілого числа (це те, що зберігається), а потім помножити на під час читання. Отже, 3.1416 / 0.0748 ≈ 42.0 округляється до 42 і реконструюється до 42 × 0.0748 ≈ 3.142 — майже ідентично. Спробуйте 0.0234, щоб побачити, що відбувається, коли крихітна вага опускається до точки сітки 0.
Щоб відновити вагу, апаратне забезпечення зчитує мале ціле число та застосовує зворотний результат:
де — збережене ціле число, а — масштаб із плаваючою комою. Різні групи ваг отримують різні — ось чому те саме значення int8 42 у двох різних каналах може декодуватися у два різні реальні числа.
Концептуально, реконструкція перетворює ціле число на значення з плаваючою комою та множить на масштаб. Реалізація може поєднувати ці операції та використовувати fp16, bf16 або fp32.
Без відсікання округлення до найближчої точки сітки змінює значення щонайбільше на , ігноруючи арифметику кінцевої точності в обчисленні масштабу. Значення, менші за величиною, ніж , округляються до нуля. Це обмежує кожну скалярну помилку, а не результуючу зміну в прогнозі моделі.
Де він насправді працює
На практиці реальне розгортання виконується одним із двох шляхів за цією арифметикою:
- Множення матриці цілих чисел: квантуйте вагові коефіцієнти та активації, накопичуйте цілі добутки, а потім застосовуйте відповідні масштаби та перетворення виходу.
- Квантування лише за вагою: зберігайте активації з плаваючою комою та реконструюйте ваги для обчислень, часто всередині злитого ядра.
Деталі залежать від зернистості та нульових балів. Одна шкала може бути виведена з суми лише тоді, коли вона поділяється членами цієї суми. Цілочисельне обчислення точно відтворює вибране квантоване наближення, а не оригінальну модель fp32.
Вибір деталізації
Гранулярність визначає, які ваги мають одну шкалу:
- На тензор: одна шкала для всього тензора з невеликою кількістю метаданих, але потенційно грубою роздільною здатністю, коли викиди встановлюють діапазон.
- На канал: одна шкала на вихідний канал, адаптація до відмінностей між каналами.
- На групу: одна вага на блок ваг. Менші групи можуть покращити локальну роздільну здатність, але вимагають метаданих більшого масштабу.
Групування по каналах відповідає вихідним розмірам шару. Для групового квантування також потрібен розмір групи. Формати та реалізації використовують різні параметри за замовчуванням, тому перевірте специфікацію контрольної точки та порівняйте якість і пам’ять для підтримуваних варіантів.
Чому це працює
Для ідеального рівномірного квантователя без відсікання скалярна похибка округлення обмежена . Знайома дисперсія додатково передбачає помилку, рівномірно розподілену в цьому інтервалі; це не гарантується для довільної ваги. Округлення є нелінійним, і ні відстані, ні якість моделі не зберігаються автоматично.
Нормальний інтервал між числами з плаваючою комою є рівномірним у межах кожного інтервалу степеня двох і подвоюється між наступними інтервалами. Натомість уніфіковане цілочисельне квантування використовує постійний крок у кожній групі. Таким чином, майже нульова роздільна здатність залежить від масштабу групи, а не від експоненти за значенням.
Змініть вікно для порівняння сіток. Відстань між числами з плаваючою комою збільшується поетапно зі збільшенням величини; кожен рядок цілочисельного квантування використовує рівномірно розподілені рівні в межах відображеного діапазону.
Зображення сховища виглядає так на int4 із розміром групи 64:
- 4 біти на вагу = 0,5 байта
- плюс одна шкала fp16 на 64 ваги ≈ 2 байти / 64 = 0,031 байтів/вага
- загальна ≈ 0,53 байт/вага
Ось чому на практиці “int4” цитується як “0,5 байта на параметр” — накладні витрати реальні, але невеликі.
Квантування класифікатора MNIST
Щоб зробити це конкретним на моделі, з якою ми вже знайомі, давайте застосуємо той самий рецепт до першого щільного шару Класифікатор МНІСТ із попередньої серії — шару Dense(128, input_shape=(784,)) із ваговою матрицею (784, 128) fp32. Виберіть деталізацію каналу: 128 груп, по одній на вихідний канал, кожна з яких містить 784 ваги. Для кожного каналу обчисліть . Якщо найбільша абсолютна вага каналу 0 дорівнює 0.234, тоді , а сітка цього каналу дорівнює — 255 точок, віддалених одна від одної від 0.00184, розтягнутих точно для покриття діапазону каналу. Канал 1 отримує інший , тому те саме значення int8 42 декодується на — інше реальне число для кожного каналу:
import keras
import numpy as np

model = keras.models.load_model('mnist_classifier.keras')
W = model.layers[0].kernel.numpy()         # (784, 128), fp32
print(W.shape, W.dtype, W.nbytes)          # (784, 128) float32 401408

INT8_MAX = 127

# Per-channel int8: one scale per output channel (128 channels)
scales = np.maximum(np.abs(W).max(axis=0) / INT8_MAX, np.finfo(np.float32).tiny)  # (128,), fp32

# Quantize: divide by scale (broadcasts), round to nearest int, cast to int8
W_q = np.round(W / scales).astype(np.int8) # (784, 128), int8

# Dequantize on read: cast to fp32, multiply by per-channel scale
W_back = W_q.astype(np.float32) * scales

# Storage: 100,352 bytes (int8 weights) + 128 * 4 = 512 bytes (scales)
# vs original 401,408 bytes — ~4× smaller, scale overhead ~0.13%
Матриця першого шару зменшується з 401 408 байт до 100 352 байт плюс 512 байт масштабів. W_back реконструює наближення float32 і тому сам не зберігає пам’ять. Щоб виміряти якість, призначте реконструйовані ваги копії моделі та оцініть її на збережених даних; цей фрагмент не повідомляє про такий тест.
Застосуйте той самий рецепт до ваг (128, 10) другого шару, і ми отримаємо зображення повної моделі:
| Шар | Форма | ваги fp32 | ваги int8 | Поканальні масштаби | int8 всього |
|---|---|---|---|---|---|
| Щільний 1 | (784, 128) | 401,408 B | 100,352 B | 128 × 4 = 512 B | 100,864 B |
| Щільний 2 | (128, 10) | 5,120 B | 1,280 B | 10 × 4 = 40 B | 1,320 B |
| Всього | 406 528 Б (~397 КіБ) | 102 184 Б (~100 КБ) |
Дві матриці займають 406 528 байт у fp32 і 102 184 байт у цьому представленні int8, включаючи масштаби. Збереження 138 зміщень у fp32 додає 552 байти в будь-якому випадку. Таким чином, пам’ять параметрів становить приблизно 407 КБ проти 103 КБ, тобто приблизно чотириразове зменшення. Економія часу виконання залежить від того, чи зберігає та використовує реалізація стиснуті ваги.