Навчання справжньої нейронної мережі на MNIST
У попередня стаття ми розглянули основні кроки та концепції навчання нейронної мережі — проходження вперед, функції втрат, зворотне розповсюдження, градієнтний спад, швидкість навчання, міні-пакети, зникаючі градієнти. Ми використали іграшковий приклад встановлення лінії з 2 параметрами, щоб пояснити механіку — за вхідних даних передбачити . Це була регресія: мережа видає єдине число, яке може приймати будь-яке значення в безперервній шкалі — як-от ціна чи температура — і ми виміряли, наскільки далеко це було, за допомогою Середня квадратична помилка (функція втрат, яку ми вибрали для цього завдання).
Тут ми зробимо щось інше — класифікацію. Отримавши зображення рукописної цифри, мережа призначить ймовірність кожній категорії та передбачить цифру з найвищою ймовірністю. Ми будемо використовувати класичний набір даних MNIST — 70 000 зображень рукописних цифр від 0 до 9.
Спочатку ми створимо все з нуля в NumPy — напишемо вручну прямий проход, функцію втрат, зворотне поширення та градієнтний спуск — щоб ви могли бачити кожен крок процесу навчання. Потім ми покажемо те ж саме в Керас, високорівневому фреймворку, який виконує все це автоматично в кількох рядках коду. Keras може працювати поверх PyTorch, TensorFlow або JAX — ці серверні модулі справляються з важкими завданнями (прискорення графічного процесора, автоматичне обчислення градієнта), а Keras надає вам чистий інтерфейс поверх. Наша реалізація NumPy обробляє одне зображення за раз, щоб зробити кожен крок простим. Keras може ефективно обробляти цілі пакети та використовувати GPU для більшого робочого навантаження.
Набір даних
MNIST — це колекція з 70 000 рукописних цифр (0–9) — 60 000 для навчання та 10 000 для тестування. Кожне зображення має розмір 28×28 пікселів, градації сірого.
Ось кілька прикладів:
Зображення та мітки зберігаються як масиви NumPy. Давайте подивимося на вихідні дані.
# 60,000 images, each a matrix of 28×28 pixels
>>> train_images.shape
(60000, 28, 28)

# A single image: 28 rows × 28 columns of pixel values (0–255)
>>> train_images[0].shape
(28, 28)

>>> train_images[0].dtype
dtype('uint8')

# 60,000 labels: first image is "5", second is "0", ...
>>> train_labels
array([5, 0, 4, ..., 5, 6, 8], dtype=uint8)

# 10,000 test images, same 28×28 matrices
>>> test_images.shape
(10000, 28, 28)

# 10,000 labels for test images
>>> test_labels
array([7, 2, 1, ..., 4, 5, 6], dtype=uint8)
Кожне значення в сітці 28×28 є інтенсивністю пікселів. Оскільки кожен піксель зберігається як один байт (8 біт), він може представляти значення — від 0 до 255. У необроблених даних 0 означає чорний, а 255 — білий — отже, цифри MNIST — це білі штрихи на чорному тлі. Це поширений формат зображень у градаціях сірого. 8-бітове зображення RGB використовує три значення на піксель (червоний, зелений і синій); МНІСТ потрібен лише один.
Ця сітка чисел розміром 28 × 28 є зображенням — кожне число безпосередньо відповідає відтінку сірого. Натисніть будь-який піксель нижче та введіть нове значення, щоб побачити це в дії. Використовуйте перемикач для перемикання між вихідним зображенням (біле на чорному) та інвертованим виглядом (чорне на білому, яке легше читається):
Зверніть увагу, що значення пікселів у сітці масштабування залишаються незмінними під час перемикання — вони завжди показують необроблені дані (те, що насправді зберігається в масиві). Перемикач змінює лише спосіб відображення цих значень у кольорах на екрані. Піксель із значенням 255 завжди має значення 255 у даних; він просто відображається як білий у вихідному режимі та чорний у інвертованому режимі. Ці 784 числа є піксельними даними, які отримує мережа.
Кожне зображення має мітку — цифру, яку воно представляє (0–9). Разом ці два масиви — зображення та мітки — це все, на чому навчатиметься мережа. Завдання просте: дано зображення розміром 28×28 передбачити, яка це цифра. Це проблема класифікації з 10 класами — мережа, яку ми побудуємо, називається багатокласовим класифікатором. У класифікації клас — це одна з можливих позначок — одна категорія, з якої модель може вибрати. У нас є 10 класів (цифри 0–9) з приблизно 6000 навчальними прикладами на цифру (не зовсім навіть — цифра 1 містить 6742 приклади, а цифра 5 — лише 5421).
Від регресії до класифікації
Переходячи від завдання регресії з попередньої статті () до класифікації цифр, нам знадобиться:
- Рівень виводу — замість того, щоб один нейрон виводив одне число, нам потрібно 10 нейронів (по одному на цифру), які створюють розподіл ймовірностей. Для цього потрібна нова функція активації на вихідному рівні: softmax.
- Функція втрат — замість середньої квадратичної помилки, яка повідомляє нам, наскільки далеке число, нам потрібна перехресна ентропійна втрата, яка повідомляє нам, наскільки впевнено модель була в правильному класі.
- Градієнт — формула градієнта змінюється відповідно до нової функції втрат. Поєднання крос-ентропії з softmax дає нам просту формулу градієнта.
- Активація прихованого рівня — нам потрібна нелінійна функція активації між рівнями, щоб мережа могла вивчати складні шаблони. Ми будемо використовувати ReLU, ту саму функцію активації, що й у прикладах нейронів і шарів у попередній статті.
Основний алгоритм — передача вперед, зворотне поширення, градієнтний спуск, міні-пакети — залишається незмінним. Давайте пройдемося по кожному фрагменту.
Вихідний шар і softmax
У регресії мережа виводить одне число. У класифікації потрібно вибрати з набору категорій — у нашому випадку одну з 10 цифр. Мережа має сказати «Я думаю, що це 2» з деяким рівнем впевненості.
Ми вирішуємо це, надаючи вихідному рівню 10 нейронів — по одному на цифру. Кожен нейрон створює оцінку, яка називається logit (назва походить від «log-odds» у логістичній регресії, але на практиці це просто означає «необроблена оцінка до softmax»), що вказує, наскільки сильно мережа вірить, що вхідні дані є цією цифрою. Вищий бал означає більше впевненості.
З 10 цифрами наш вихідний рівень створює 10 логітів — по одному на клас. Щоб зробити приклади та візуалізацію простими, ми використаємо лише 3 класи (цифри 0, 1, 2) у наведеному нижче коді — математика працює точно так само, лише з меншою кількістю чисел.
Для заданого вхідного зображення результат може виглядати так:
Зображення надходить, мережа обробляє його через свої шари, а з нього виходять 3 числа — по одному на цифру. Цифра 2 отримала найвищий бал (4,2), тож це прогноз мережі. У коді:
logits = [1.5, -0.3, 4.2]
#          0     1    2

# The network's guess: digit 2 (highest logit = 4.2)
# argmax returns the index of the largest value, not the value itself
prediction = np.argmax(logits)  # 2
Але необроблені логіти не є ймовірностями — вони можуть бути будь-якими числами, додатними чи від’ємними, і їх сума не дорівнює 1. Щоб перетворити їх на правильний розподіл ймовірностей, ми використовуємо функцію softmax — одну з найпоширеніших операцій у глибокому навчанні, яка використовується в класифікаторах зображень і мовних моделях (де вона перетворює оцінки словникових токенів у ймовірності наступного токена):
Чому він називається «softmax»? Тому що це м’якша версія max. Жорсткий максимум просто вибирає найбільше значення та ігнорує все інше — [0, 0, 1]. Softmax робить майже те саме, коли один логіт домінує, але коли логіти однаково великі, інші значення також отримують значущу вагу. Порівняти:
| логіти | жорсткий макс | softmax |
|---|---|---|
| [1.0, 8.5, 1.0] | [0, 1, 0] | [0.1%, 99.9%, 0.1%] |
| [3.0, 3.5, 3.0] | [0, 1, 0] | [27.4%, 45.2%, 27.4%] |
| [3.0, 3.0, 3.0] | undefined (рівня) | [33.3%, 33.3%, 33.3%] |
Жорсткий максимум дає двійкову відповідь — переможець отримує все. Softmax забезпечує плавний розподіл, який постійно змінюється, коли ви змінюєте вхідні дані. Коли модель є невизначеною (логістики близькі один до одного), softmax відображає цю невизначеність. Коли модель впевнена (на один логіт набагато більше), softmax наближається до hard max. Ця плавна поведінка також забезпечує роботу зворотного поширення — ви можете обчислювати градієнти за допомогою softmax, оскільки його можна диференціювати всюди.
Жорсткий максимум не має корисного градієнта: результат постійний між стрибками. Softmax є диференційованим, тому ми можемо здійснювати зворотне поширення через нього. Математично скінченні логіти дають імовірності строго між 0 і 1, хоча арифметика з плаваючою комою може округлити дуже малі ймовірності до 0. Спробуйте встановити перші два логіти на 0, а третій на велике число у віджеті нижче.
Softmax працює в три кроки (використовуючи наш приклад logits [1.5, -0.3, 4.2]):
- Підведіть до степеня кожного логіта — оскільки для будь-якого , це перетворює кожне значення — навіть від’ємне — на додатне число: , ,
- Підсумуйте всі додатні значення —
- Поділіть кожне значення на цю суму — , тощо.
Це нормалізує список, тому він додає рівно 1 — правильний розподіл ймовірностей.
Окрім диференційованості, softmax має ще одну важливу властивість: ефект посилення експоненціальної функції. Ось чому softmax використовує , а не просто ділить необроблені логіти на їхню суму. Оригінальні логіти (1,5, -0,3, 4,2) відрізняються лише кількома пунктами. Але експоненціальна перетворює адитивні різниці на мультиплікативні: , а і . Логічна різниця 2,7 (між 4,2 і 1,5) перетворюється на 15-кратну різницю в степеневих значеннях. Після ділення на суму цифра 2 отримує 92,7% ймовірності. Це зосереджує ймовірність на найвищому класі, хоча висока ймовірність не гарантує правильного прогнозу.
Ви можете керувати цим ефектом посилення за допомогою параметра temperature . Формула виглядає так:
Ділення на перед піднесенням до степеня масштабує різницю між логітами. Спробуйте перетягнути T-повзунок:
- T → 0 (низька температура) — відмінності посилюються, розподіл стає різким. Найвищий логіт отримує майже 100%. Це наближається до жорсткого макс.
- T = 1 — стандартний софтмакс. Ділення на 1 нічого не змінює, тому це еквівалентно відсутності взагалі.
- T → ∞ (висока температура) — відмінності згладжуються, усі логіти стають схожими, а розподіл наближається до рівномірного (33,3% кожен).
Мовні моделі також використовують температуру під час вибірки наступного токена. Низька температура концентрує ймовірність на найбільш ймовірних жетонах, роблячи результат більш передбачуваним. Висока температура розподіляє ймовірність більш рівномірно, дозволяючи більш різноманітний вибір і іноді менш узгоджений результат.
Ось як ми реалізуємо softmax у Python:
def softmax(logits):
    # Subtract max for numerical stability (doesn't change the result,
    # but prevents overflow when computing e^z for large values)
    exp = np.exp(logits - np.max(logits))
    return exp / np.sum(exp)

probs = softmax(logits)
# [0.063, 0.010, 0.927]
#   0      1      2
# The highest probability is 92.7% for digit 2
Зверніть увагу, що ми також віднімаємо максимальний логіт. Ми робимо це тому, що softmax обчислює , а експоненціальна функція зростає надзвичайно швидко. Якщо logit дорівнює 1000, тоді переповнюється до нескінченності у плаваючому комі:
>>> import numpy as np
>>> np.exp(1000)
inf                    # overflow — can't compute

>>> np.exp(1000) / (np.exp(1) + np.exp(2) + np.exp(1000))
nan                    # infinity / infinity = undefined
Віднімання максимального логіту з усіх значень перед піднесенням до степеня зсуває найбільше значення до 0, а все інше робить від’ємним. Відносний порядок зберігається — все ще є найбільшим, оскільки завжди менше 1 — тому ймовірності виходять однаковими:
>>> logits = [1, 2, 1000]
>>> max(logits)
1000

>>> [z - max(logits) for z in logits]
[-999, -998, 0]        # largest becomes 0, others become negative

>>> np.exp([-999, -998, 0])
array([0., 0., 1.])    # e⁰ = 1 is the largest (e^negative is always < 1), no overflow
Ви можете побачити тут, як математика працює з однаковими ймовірностями з або без віднімання:
компенсується, але ми уникали обчислення будь-яких небезпечно великих експонент. Це стандартний прийом чисельної стабільності, який ви побачите в кожній реалізації softmax.
ReLU: функція активації прихованих шарів
Ми вже розглянули одну функцію активації — softmax на вихідному рівні, яка перетворює логіти в ймовірності. Але нам також потрібна функція активації прихованих шарів. Навчена модель попередньої статті () являла собою одну лінійну операцію — без функції активації, без прихованих шарів.
Також безглуздо пояснив чому стекувати шари без функції активації: ланцюжок лінійних операцій згортається в одну лінійну операцію. Щоб вивчати складні візерунки замість прямих ліній, нам потрібна нелінійність між шарами. У попередній статті було представлено функції активації як рішення — показ кількох опцій у віджеті нейронів (сигмоід, перцептрон, ReLU).
Ми будемо використовувати ReLU (Rectified Linear Unit), загальний вибір для прихованих шарів:
Він пропускає позитивні значення без змін, а негативні обнуляє. Перетягніть повзунки нижче — коли зважена сума додатна (зелена), значення проходить. Коли він негативний (червоний), результат обрізається до 0:
Ви можете побачити поведінку, налаштувавши обидва повзунки — важлива зважена сума w × x, а не окремі значення. Спробуйте встановити як введення, так і вагу на від’ємні числа: добуток додатний, тому ReLU передає його. Він обривається до нуля лише тоді, коли сам продукт негативний.
ReLU має просту похідну, яка корисна під час зворотного поширення. Похідна функції активації з’являється безпосередньо в ланцюгове правило продукту, коли ми обчислюємо градієнт втрат. У попередній статті градієнт для ваги прихованого шару виглядав так:
dw11 = x1 * relu_deriv(z1) * v1 * 2 * error
#            ↑ activation derivative — one factor in the chain
Градієнт втрат є добутком локальних похідних уздовж шляху. relu_deriv є одним із таких факторів: коли він дорівнює 1, градієнт проходить без змін; коли воно дорівнює 0, нейрон не отримує градієнта від цього входу. Нейрон, який залишається неактивним для всіх тренувальних вхідних даних, може взагалі припинити навчання — проблема ReLU, що вмирає . Sigmoid має інше обмеження: його похідна становить не більше 0,25 і наближається до нуля, коли активація насичується біля 0 або 1. Ці невеликі фактори можуть поєднуватися між шарами.
Чому sigmoid гірший за ReLU для градієнтів?
Похідною сигмоїда є . Оскільки sigmoid виводить значення від 0 до 1, це — яке максимізується, коли (при ): . Коли віддаляється від 0 у будь-якому напрямку, сигмовид насичується до 0 або 1, а похідна зменшується до 0.
У п’яти сигмоподібних шарах лише похідні активації вносять не більше . Вагові матриці також впливають на повний градієнт, але ці невеликі похідні фактори можуть ускладнити навчання на попередніх рівнях. Похідна ReLU дорівнює 1 для активних нейронів, тому ці нейрони не зменшують градієнт на етапі активації.
Отже, наша мережа має дві різні функції активації, які виконують дві різні ролі: ReLU у прихованих шарах (впроваджуючи нелінійність, щоб мережа могла вивчати складні шаблони) і softmax на вихідному рівні (перетворює необроблені оцінки в ймовірності).
Функція втрат
Тепер нам потрібна функція втрат. У попередній статті ми використовували середню квадратичну помилку — квадрат різниці між прогнозом і метою, усереднений за всіма точками даних. Це мало сенс для регресії: прогноз був одним числом, метою було одне число, і ми хотіли, щоб вони були близькими.
Для класифікації ми використовуємо перехресну втрату ентропії. Ідея проста: візьміть негативний логарифм ймовірності, яку модель присвоїла правильному класу.
Чим менша ймовірність, тим більша втрата:
- Модель каже, що ймовірність 95% правильна: — низькі втрати, хороший прогноз
- Модель каже, що 60% шансів, що це правильно: — помірні втрати, недостатньо впевнено
- Модель каже, що вірогідність 1%: — дуже великі втрати, майже повністю неправильно
Навіщо використовувати від’ємний логарифм?
- При втрати дорівнюють нулю: .
- Коли наближається до 0, втрата безмежно зростає, штрафуючи прогнози, які приписують дуже малу ймовірність правильному класу.
- Похідною є , тому невелика зміна ймовірності впливає на втрату набагато більше біля 0, ніж біля 1.
На графіках нижче показано поруч і . Обидва круті поблизу 0. Від’ємний знак відображає криву поперек горизонтальної осі, даючи нам невід’ємні втрати, які зменшуються зі збільшенням ймовірності правильного класу.
Наприклад, похідною відносно є при і приблизно при . Це лише один фактор у зворотному поширенні: щоб отримати градієнти для логітів і ваг, нам також потрібні похідні від softmax і попередніх шарів. Ми розглянемо їх нижче.
Перетягніть повзунки нижче та спостерігайте за рухом жовтої крапки вздовж кривої :
Цифра 2 - справжній клас. Підвищити його ймовірність і втрати наближаються до нуля; зменшити його, і втрати різко зростають.
У Python функція втрати виглядає так. Він бере передбачені моделлю ймовірності та справжню мітку (індекс правильного класу — 0, 1 або 2) і повертає ймовірності, призначеної цьому класу:
def cross_entropy_loss(probs, label):
    # label is the index of the correct class
    p_correct = probs[label]       # e.g. probs[2] = 0.94
    return -np.log(p_correct)      # -log(0.94) = 0.062

# Model is confident and correct → low loss
cross_entropy_loss([0.05, 0.01, 0.94], label=2)   # 0.062

# Model is uncertain → moderate loss
cross_entropy_loss([0.30, 0.30, 0.40], label=2)    # 0.916

# Model is confident but wrong → high loss
cross_entropy_loss([0.80, 0.15, 0.05], label=2)    # 2.996
Втрата проти точності
Під час навчання ми відстежуємо як втрати, так і точність — вони взаємопов’язані, але не одне й те саме.
Точність вимірює частку правильних прогнозів. Він є двійковим і не дбає про достовірність — кожен прогноз є або правильним, або неправильним, без часткового кредиту. Прогноз 0,51 для правильного класу вважається правильним, і так само 0,99 — обидва додають однаковий +1 до підрахунку точності. Але втрати дуже різні: 0,67 для першого, 0,01 для другого.
Втрата (перехресна ентропія) вимірює, яку ймовірність модель поставила для правильної відповіді — що менша ймовірність, то вищий штраф. Дві моделі можуть мати однакову точність, але різні втрати, якщо призначити вищі ймовірності для правильних класів.
Ось як це виглядає в реальному журналі навчання:
Epoch 1/10  — accuracy: 0.5117 — loss: 1.7934 — val_accuracy: 0.7520 — val_loss: 1.3155
Epoch 2/10  — accuracy: 0.7806 — loss: 1.0726 — val_accuracy: 0.8377 — val_loss: 0.8382
Epoch 5/10  — accuracy: 0.8627 — loss: 0.5560 — val_accuracy: 0.8798 — val_loss: 0.4901
У епоху 1 accuracy: 0.5117 означає, що модель передбачила правильну цифру для 51% навчальних зображень — для кожного зображення клас із найвищою ймовірністю порівнюється з істинною міткою, і підраховується частка правильних прогнозів. Це вже значно вище 10% базового рівня випадкового вгадування серед 10 класів, але все ще неправильно на половині зображень.
Втрата 1,79 говорить вам більше — це означає, що модель в середньому призначає низьку ймовірність правильного класу. Це може статися двома способами: модель може передбачити правильний клас, але з низькою впевненістю (скажімо, 0,3 замість 0,9), або — що ще гірше — вона може бути впевнено невірною, покладаючи більшу частину своєї ймовірності на неправильний клас. Кілька впевнено помилкових прогнозів можуть непропорційно вплинути на середній збиток.
Різниця між точністю та втратою означає, що вони не завжди рухаються разом:
- Втрати зменшуються, точність залишається незмінною — модель стає більш впевненою щодо прогнозів, які вона вже робила правильні. Наприклад, якщо модель вже передбачає «7» для зображення 7, але її достовірність змінюється з 0,4 до 0,9, точність не змінюється (вона вже була правильною), але втрати значно падають.
- Точність зростає, втрати також зростають — модель отримує правильніші прогнози, але стає надто впевненою в неправильних. Уявіть, що модель виправляє 5 зображень, які вона помилялася (точність покращується), але одночасно стає дуже впевненою (0,95) на 2 зображеннях, які вона помиляється. Втрата від цих 2 впевнених помилок може переважити покращення від 5 нових правильних.
- Обидва залишаються плоскими — модель застрягла. Ваги змінюються, але прогнози суттєво не відрізняються. Це часто трапляється, коли швидкість навчання занадто мала або модель досягла своєї потужності.
На практиці обидва показники зазвичай покращуються разом під час здорового тренування — типовим прикладом є журнал тренувань вище. Коли вони розходяться, перевірте, чи стає модель більш впевненою у своїх помилках.
Градієнт
У попередній статті ми побачили, що навчання вимагає обчислення градієнта втрат щодо кожного параметра — похідної, яка вказує нам, у якому напрямку рухати кожну вагову силу, щоб зменшити помилку. Для нашого прикладу підгонки лінії показав як ми дійшли до формули для градієнта MSE. Тепер нам потрібен градієнт втрат перехресної ентропії щодо логітів (необроблені оцінки до softmax).
Ось як виглядає один нейрон у вихідному шарі — логіт є зваженою сумою перед застосуванням функції активації:
Зауважте, що сам softmax не має параметрів, які можна вивчати — це просто функція, яка перетворює логіти в ймовірності. Вагові коефіцієнти, які можна дізнатися, містяться в нейроні, який обчислює зважену суму та створює логіт. Ми використовуємо градієнт відносно логітів для обчислення градієнтів для вихідних ваг і прихованих шарів. Потім оптимізатор використовує ці градієнти для оновлення параметрів.
Формула для MSE, до якої ми дійшли в попередній статті, мала чітку структуру: dw = 2 * mean(error * x) — помилка, помножена на введення, усереднене за прикладами.
Кожна частина виникла з ланцюгового правила, застосованого до функції втрат. Тепер нам потрібно зробити те саме для втрат крос-ентропії в поєднанні з softmax. Ми опрацюємо це в три частини:
- Градієнт через softmax (вихідний рівень) — отримайте градієнт крос-ентропії + softmax відносно логітів, отримуючи чисту формулу
- Градієнт через ReLU (прихований шар) — показує, як градієнт проходить через функцію активації прихованого шару
- З’єднайте все разом — об’єднайте дві частини в повний прохід назад
Повний прямий ланцюжок: вхідні дані → прихований шар (ваги + ReLU) → логіти → м’який максимум → ймовірності → перехресна ентропія → втрати. Зворотний перехід відбувається у зворотному напрямку — ми починаємо з втрати та застосовуємо правило ланцюга назад через крос-ентропію, м’який максимум, а потім приховані шари.
Наведена нижче математика є складнішою, ніж градієнт MSE із попередньої статті — необов’язково виконувати кожен крок, щоб використовувати результат. Якщо ви бажаєте, ви можете перейти до остаточної формули та коду. Але якщо ви хочете побачити, звідки це береться, ось крок за кроком.
Градієнт через softmax (вихідний шар)
Крок 1: похідна від втрати. Втрата , де правильний клас. Ми вже знаємо похідну від : це . Отже:
Крок 2: похідна від softmax. Тепер ми маємо похідну втрати відносно . Але нам потрібна похідна щодо логітів — тому що це те, що насправді створюють ваги шару (як показано на діаграмі вище). Щоб подолати розрив, нам потрібно знати: як softmax перетворює зміну в на зміну в ?
Softmax - . Використовуючи правило частки, є два випадки:
Якщо (підштовхування власної ймовірності логіта):
Це виглядає як похідна сигмоїди — і це так. Кожен вихід softmax локально поводиться як сигмоід.
Якщо (підштовхування іншого логіта):
Перший член чисельника дорівнює 0, оскільки не залежить від . Збільшення одного логіта завжди зменшує інші ймовірності — їх сума повинна дорівнювати 1.
Крок 3: правило ланцюга. Помножте дві похідні разом:
- Для правильного класу ():
- Для неправильного класу ():
Результат
Об’єднання похідних дає нам градієнт втрат крос-ентропії щодо кожного логіта :
Як ми обчислюємо це на практиці? Використовуючи , вектор one-hot — усі нулі, крім 1, у правильному класі. Оскільки для правильного класу та для всього іншого, віднімання від дає нам для правильного класу та для решти — точнісінько за формулою, наведеною вище:
У Python це просто:
grad_z = probs - one_hot_label # gradient w.r.t. logitsГрадієнт по відношенню до логітів є прогнозованим вектором ймовірності за мінусом однієї гарячої цілі.
Давайте подивимося, що це означає, на конкретному прикладі для 3 класу. Якщо модель видає ймовірності [0.06, 0.01, 0.93] і правильний клас дорівнює 2:
- Ціль (одна гаряча) —
[0, 0, 1]— уся ймовірність має бути в класі 2 - Градієнт є
[0.06 − 0, 0.01 − 0, 0.93 − 1]=[0.06, 0.01, −0.07]
Знак вказує вам напрямок: клас 2 отримує негативний градієнт (–0,07), що означає «збільште цей логіт, щоб збільшити його ймовірність». Класи 0 і 1 отримують позитивні градієнти, що означає «знизити ці логіти». Величина показує, наскільки — клас 0 (0,06) потребує більшої корекції, ніж клас 1 (0,01), оскільки до нього просочується більше ймовірності.
Зверніть увагу, що є градієнтом відносно логітів, а не вагових коефіцієнтів. Пам’ятайте, вихідний нейрон обчислює (логіт), а потім softmax перетворює його на ймовірність. Отже, повний ланцюжок від втрати ваги складається з двох частин:
Перша частина () — це те, що ми щойно отримали — як змінюється втрата з логітами. Друга частина () є похідною від по відношенню до , яка є лише вхідними даними. Їх множення дає градієнт ваги:
grad_z = probs - one_hot_label       # part 1: loss → logits (p - y)
grad_W = np.outer(grad_z, x)         # part 1 × part 2: logits → weights
grad_b = grad_z                       # bias gradient (same as grad_z)
grad_input = W.T @ grad_z            # gradient to pass to the previous layer
grad_input = W.T @ grad_z — це градієнтний сигнал, що передається на попередній шар. Тоді цей шар робить те саме — але з ReLU замість softmax.
Градієнт через ReLU (прихований шар)
Прихований рівень обчислює , а потім застосовує ReLU: . Ми отримав це в попередній статті — коли градієнт надходить із наступного шару (grad_output), правило ланцюга множить його на похідну ReLU:
Якщо нейрон був активним (), то градієнт проходить без змін. Якщо він був неактивним (), градієнт обнулюється. Потім, як і вихідний шар, ми продовжуємо ланцюжок, щоб отримати градієнти ваги:
grad_z = grad_output * (z > 0)       # multiply by ReLU derivative (0 or 1)
grad_W = np.outer(grad_z, x)         # chain rule: gradient for weights
grad_b = grad_z                       # gradient for biases
grad_input = W.T @ grad_z            # pass to the previous layer
Все разом
Повний ланцюжок зворотного проходу через кожен шар, починаючи з втрати:
- Вихідний рівень: → обчислити
grad_W,grad_b, передатиgrad_inputназад - Прихований шар: отримати
grad_input, помножити на похідну ReLU → обчислитиgrad_W,grad_b, передатиgrad_inputназад - Повторіть для будь-яких додаткових прихованих шарів
Шаблон однаковий на кожному рівні — єдина різниця полягає в похідній активації (softmax проти ReLU). Ось повний зворотний перехід для нашої мережі (один прихований рівень + вихідний рівень):
# Forward pass (for reference)
z1 = W1 @ x + b1              # hidden layer: weighted sum
h = relu(z1)                   # ReLU activation
z = W2 @ h + b2                 # output layer: hidden → logits
p = softmax(z)                  # softmax: logits → probabilities
loss = -np.log(p[label])        # cross-entropy loss

# Backward pass: chain rule from loss back to weights
# 1. Output layer gradient (softmax + cross-entropy)
grad_z2 = p.copy()
grad_z2[label] -= 1             # p - y

grad_W2 = np.outer(grad_z2, h)  # weight gradient
grad_b2 = grad_z2               # bias gradient
grad_h = W2.T @ grad_z2         # pass gradient to hidden layer

# 2. Hidden layer gradient (ReLU)
grad_z1 = grad_h * (z1 > 0)     # multiply by ReLU derivative

grad_W1 = np.outer(grad_z1, x)  # weight gradient
grad_b1 = grad_z1               # bias gradient

# 3. Update all weights
W2 -= lr * grad_W2
b2 -= lr * grad_b2
W1 -= lr * grad_W1
b1 -= lr * grad_b1
Це саме те, що наші HiddenLayer.backward() і OutputLayer.backward() реалізують у наведеному нижче коді NumPy — ті самі кроки, просто загорнуті в класи.
Наведений нижче віджет запускає саме цей цикл у крихітній мережі — резервне зображення 2×2, що живить прихований шар із 2 нейронами та виводить 3 класи. Виберіть вхідні дані, повідомте правильну цифру та спостерігайте за заповненням зворотного проходу: вихідна помилка grad_z2 = p − y, прихована помилка grad_z1 і матриці вагового градієнта grad_W2 і grad_W1. Натисніть Застосувати оновлення, і втрати зменшаться — той самий крок W -= lr * grad_W стане видимим.
Міні-партії та епохи
У попередній статті ми представили стохастичний градієнтний спуск (SGD): замість того, щоб переглядати всі точки даних, збирати градієнти для кожної з них і усереднювати їх в одне оновлення, ми розбиваємо дані на невеликі міні-пакети та оновлюємо ваги після кожної партії. Розмір пакету — це кількість прикладів, які ви усереднюєте перед оновленням ваги — та сама формула градієнта, те саме усереднення, лише інша кількість прикладів.
Як ми бачили в попередній статті, де ми мали 2 точки даних на пакет із 5 загалом, це створює певний шум — градієнт на основі 2 прикладів не вказуватиме в тому самому напрямку, що й градієнт на основі всіх 5 — але набагато частіші оновлення з лишком компенсують це.
Давайте подивимося, як це буде відбуватися з нашими 60 000 навчальних зображень.
Без міні-пакетів (повнопакетний градієнтний спуск) один прохід через дані виглядає так:
- Передайте всі 60 000 зображень через мережу
- Обчисліть усереднені втрати за всіма 60 000 прогнозами
- Зворотне поширення, щоб отримати градієнт (усереднений для всіх зображень)
- Оновіть ваги один раз
Це одне оновлення ваги після перегляду кожного зображення. Градієнт дуже точний (він враховує весь набір даних), але модель нічого не вивчає, доки не обробить усі 60 000 зображень.
З міні-партіями розміру 32 один і той самий пропуск виглядає зовсім по-різному:
- Зробіть зображення 1–32, передача вперед, обчислення втрат, зворотне поширення, оновлення ваг
- Зробіть зображення 33–64, передача вперед, обчислення втрат, зворотне поширення, оновлення ваг
- Зробіть зображення 65–96, передача вперед, обчислення втрат, зворотне поширення, оновлення ваг
- … повторити для всіх міні-серій
Це 1875 оновлень ваги за той самий проходження даних.
Кожен окремий градієнт шумить (він базується лише на 32 зображеннях замість 60 000), але модель оновлює свої ваги 1875 разів замість одного разу. До того моменту, як він побачив усі дані, він уже вніс сотні виправлень — він навчається по ходу, а не чекає до кінця. (Крайній випадок — розмір пакету = 1 — оновлення після кожного окремого зображення. Це 60 000 оновлень на епоху, але кожен градієнт дуже шумний, оскільки він базується лише на одному прикладі.)
Після того, як модель пройшла кожну міні-партію — усі 1875 із них — вона побачила кожне навчальне зображення рівно один раз. Цей повний прохід через повний набір даних називається епохою. Зазвичай ми тренуємося для кількох епох — кожен прохід дає моделі ще одну можливість налаштувати свої ваги.
Кількість пакетів на епоху визначається розміром набору даних і розміром пакета:
На початку кожної епохи ми перемішуємо дані, щоб міні-пакети щоразу відрізнялися — це не дозволяє моделі вивчати шаблони в порядку, а не в самих зображеннях.
Вам може бути цікаво, як вибрати правильну кількість епох. Це залежить від того, коли модель перестане вдосконалюватися на невидимих даних. Замало епох і модель недостатньо навчилася; занадто багато, і він починає запам’ятовувати навчальні дані замість узагальнення. На практиці ви встановлюєте високу максимальну кількість епох і дозволяєте ранній зупинці вирішувати, коли фактично зупинитися — вона відстежує точність перевірки та зупиняє навчання, коли воно досягає плато.
Якщо ми проведемо навчання протягом 5 епох, ми побачимо:
Це означає, що градієнтний спуск виконується 9375 разів — щоразу обробляється партія з 32 зображень, обчислюється усереднений градієнт і підштовхується кожна вага в мережі.
Побудова моделі
Давайте побудуємо модель, яка приймає 784 входи (пікселі) і виводить 10 класів ймовірностей (по одній на цифру). Ми використаємо структуру HiddenLayer з попередньої статті — вагову матрицю , вектор зміщення і функцію активації:
У попередній статті наша модель являла собою єдине лінійне рівняння — лише 2 параметри, без шарів, без функцій активації. Ми обчислювали градієнт безпосередньо, не потребуючи нічого передати назад, оскільки за ним нічого не було. Тепер із кількома шарами кожен шар має обчислювати власні градієнти і передавати сигнал градієнта попередньому шару — це зворотний перехід.
Математичне правило ланцюга таке ж, як ми вивели вище, просто загорнуте в клас:
class HiddenLayer:
    def __init__(self, n_inputs, n_neurons):
        # We use initialization proposed by Kaiming He et al. (2015):
        # random weights scaled by sqrt(2/n) — keeps activations balanced
        # for ReLU networks (too large → explode, too small → vanish)
        self.W = np.random.randn(n_neurons, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_neurons)

    def forward(self, x):
        self.x = x                          # save for backward pass
        self.z = self.W @ x + self.b        # weighted sum
        self.out = np.maximum(0, self.z)    # ReLU activation
        return self.out

    def backward(self, grad_output):
        # ReLU derivative: 1 if z > 0, else 0
        grad_z = grad_output * (self.z > 0)

        # Gradients for this layer's parameters (chain rule)
        self.grad_W = np.outer(grad_z, self.x)   # ∂loss/∂W = grad_z ⊗ x
        self.grad_b = grad_z                      # ∂loss/∂b = grad_z

        # Gradient to pass to the previous layer (chain rule continues)
        return self.W.T @ grad_z                  # ∂loss/∂x = Wᵀ · grad_z

    def update(self, lr):
        # Gradient descent: update parameters
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
Шар має три методи:
forward: обчислити , застосувати ReLUbackward: отримання градієнта з наступного шару, обчислення локальних градієнтів за допомогою ланцюгового правила та повернення градієнта для переходу до попереднього шаруupdate: застосувати градієнтний спуск — віднятиlr × gradientвід кожного параметра
Ми відокремлюємо backward від update, щоб ми могли накопичувати градієнти в міні-пакеті перед оновленням — як це робить Keras.
grad_input наприкінці — це градієнтний сигнал, що передається назад до попереднього шару — ось як правило ланцюга «тече» по мережі, точно так само, як на діаграмі з попередньої статті:
Forward:   x ──▶ Layer 1 ──▶ Layer 2 ──▶ Output ──▶ Loss
Backward:  x ◀── Layer 1 ◀── Layer 2 ◀── Output ◀── ∂L
Кожен шар отримує градієнт справа, обчислює власні градієнти параметрів (щоб оновити і ) і передає градієнт, що залишився, ліворуч.
Тепер давайте також створимо рівень виводу, який використовує softmax замість ReLU (оскільки останній рівень має створювати ймовірності, а не активації ReLU):
class OutputLayer:
    def __init__(self, n_inputs, n_classes):
        self.W = np.random.randn(n_classes, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_classes)

    def forward(self, x):
        self.x = x
        self.z = self.W @ x + self.b
        # Softmax instead of ReLU
        exp = np.exp(self.z - np.max(self.z))
        self.probs = exp / np.sum(exp)
        return self.probs

    def backward(self, label):
        # Combined softmax + cross-entropy gradient: p - y
        grad_z = self.probs.copy()
        grad_z[label] -= 1

        # Same gradient formulas as Layer
        self.grad_W = np.outer(grad_z, self.x)
        self.grad_b = grad_z
        return self.W.T @ grad_z

    def update(self, lr):
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
Тепер ми можемо зібрати мережу. Почнемо з простої архітектури — один прихований шар із 128 нейронів:
# 784 inputs → 128 hidden neurons → 10 output classes
layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)
Ось як з’єднуються ці два шари. Кожне коло представляє одне вхідне значення або нейрон; крапки позначають решту.
Але чому 128? Чому не 1 чи 10?
Кожен прихований нейрон є детектором ознак. Він розглядає всі 784 пікселя через власний вектор ваги та виводить одне число, яке вказує на те, наскільки сильно його візерунок з’являється на зображенні. Один нейрон може бути налаштований на горизонтальну лінію вгорі (корисно для розділення 5 і 7), інший на замкнутий цикл у нижній половині (6, 8, 9), інший на діагональ у верхньому правому куті. Потім вихідний рівень зважує всі 128 цих сигналів, щоб визначити, яка цифра є найбільш імовірною.
Кожен вихідний нейрон обчислює скалярний добуток output.W[digit] @ hidden, а потім додає своє зміщення. Його ваговий вектор визначає, які приховані активації підвищують або зменшують оцінку для цієї цифри. Скалярний добуток залежить як від вирівнювання векторів, так і від їх величин. Перемагає клас з найбільшою кількістю балів.
Маючи лише 1 прихований нейрон, кожне зображення буде стиснуто до одного числа, перш ніж досягти вихідного шару. Це залишає мало місця для представлення різних штрихів і форм, необхідних для розрізнення рукописних цифр. Більше прихованих нейронів дозволяє мережі вивчати ширший спектр функцій.
Ми почнемо зі 128 прихованих нейронів. У цьому прикладі це дає нам приблизно 97% точності перевірки після п’яти епох. Менший шар використовує менше параметрів; більший має більшу ємність, але вимагає більше обчислень. У наступній статті ми порівняємо різну ширину.
Це параметри на першому рівні та на вихідному рівні — загалом 101 770 параметрів. Порівняно з 2 параметрами ( і ) у нашому прикладі підгонки лінії з попередньої статті, це в 50 000 разів більше. Але алгоритм навчання ідентичний.
Та сама мережа в Keras
Керас називає свої шари Dense — скорочення від «щільно з’єднаних» (або «повністю з’єднаних»), тобто кожен вхідний сигнал підключається до кожного нейрона. Рівень Dense виконує точно такі ж обчислення, як наші класи NumPy вище: — множення вхідних даних на ваги, додавання зміщення, застосування функції активації. Різниця полягає в тому, що Keras автоматично обробляє ініціалізацію ваги, прохід вперед, обчислення градієнта та оновлення параметрів.
Наш HiddenLayer(784, 128) з ReLU стає Dense(128, activation="relu"), а наш OutputLayer(128, 10) з softmax стає Dense(10, activation="softmax"). Зауважте, що в Keras ви вказуєте лише кількість виходів — моделі потрібен keras.Input(shape=(784,)) у верхній частині, щоб знати розмір вхідних даних, але після цього Keras автоматично виводить вхідні дані кожного шару з вихідних даних попереднього шару. Таким чином, Dense(10) знає, що має 128 входів, тому що шар перед ним виводить 128.
Щільний шар, повністю зв'язаний, FFNN, MLP — у чому різниця?
Ці терміни використовуються як синоніми, але вони описують різні речі:
- Щільний / повністю зв’язаний рівень — з’єднання одного рівня: кожен вхід з’єднується з кожним нейроном, операція , яку ми будуємо. Це будівельний блок.
- MLP (багатошаровий персептрон) — ціла мережа, що складається з накладених щільних шарів з нелінійностями між ними. Модель, яку ми щойно побудували є MLP: 784 → 128 (ReLU) → 10 (softmax).
- FFNN (нейронна мережа прямого зв’язку) — описує топологію: дані протікають в одному напрямку, вхід → вихід, без циклів або пам’яті попередніх входів. Наша мережа також є прямою.
Таким чином, для такої мережі, як наша, підходять усі три мітки — це повністю підключена MLP і є прямою передачею. Одна тонкість: “пряма подача” є ширшою, ніж “щільна”. Згорточна нейронна мережа (CNN) також є прямою (без циклів), але її шари є згортковими, а не щільними, тому не кожна FFNN побудована з щільних шарів. А рекурентна нейронна мережа (RNN) не є прямою, тому що вона повертає свій власний вихід назад як вхід для перенесення пам’яті через послідовність. Через цей контраст — прямого та повторюваного — ці назви виявляються як різні архітектури, коли люди порівнюють моделі для таких завдань, як мова, де порядок слів має значення.
Sequential об’єднує їх у модель, де результати кожного шару надходять у наступний:
model = keras.Sequential([
    # 784 inputs (28×28 image pixels)
    keras.Input(shape=(784,)),
    # 128 neurons/outputs, ReLU activation
    keras.layers.Dense(128, activation="relu"),
    # 10 neurons/outputs (one per digit), softmax activation
    keras.layers.Dense(10, activation="softmax"),
])

model.summary()
# Total params: 101,770 — same number we counted by hand
Побудова навчального циклу
Навчальний цикл — це той самий 4-етапний процес, що й у попередній статті — прохід вперед, втрата, зворотне поширення, градієнтний спуск. Для кожного міні-пакета ми запускаємо прямий і зворотний прохід для кожного зображення, щоб накопичити градієнти, потім усереднюємо їх і один раз оновлюємо ваги. Це відповідає внутрішньому виконанню Keras:
def train(layers, output_layer, X_train, y_train, X_val, y_val,
          epochs=5, lr=0.1, batch_size=32):
    n = X_train.shape[0]
    history = {"train_loss": [], "train_acc": [], "val_acc": []}

    for epoch in range(epochs):
        # Shuffle training data at the start of each epoch
        indices = np.random.permutation(n)
        X_shuffled = X_train[indices]
        y_shuffled = y_train[indices]

        epoch_loss = 0.0
        correct = 0

        all_layers = layers + [output_layer]

        for i in range(0, n, batch_size):
            X_batch = X_shuffled[i:i+batch_size]
            y_batch = y_shuffled[i:i+batch_size]
            bs = len(X_batch)

            # Accumulate gradients over the mini-batch
            accumulated = {id(l): (np.zeros_like(l.W), np.zeros_like(l.b))
                           for l in all_layers}

            for x, label in zip(X_batch, y_batch):
                # 1. Forward pass
                h = x
                for layer in layers:
                    h = layer.forward(h)
                probs = output_layer.forward(h)

                # 2. Loss computation
                loss = -np.log(probs[label] + 1e-10)
                epoch_loss += loss
                correct += (np.argmax(probs) == label)

                # 3. Backpropagation (compute gradients, don't update yet)
                grad = output_layer.backward(label)
                for layer in reversed(layers):
                    grad = layer.backward(grad)

                # Accumulate gradients
                for l in all_layers:
                    accumulated[id(l)][0][:] += l.grad_W
                    accumulated[id(l)][1][:] += l.grad_b

            # 4. Gradient descent: average gradients and update
            for l in all_layers:
                l.grad_W = accumulated[id(l)][0] / bs
                l.grad_b = accumulated[id(l)][1] / bs
                l.update(lr)

        # Track metrics
        train_loss = epoch_loss / n
        train_acc = correct / n
        val_acc = evaluate(layers, output_layer, X_val, y_val)
        history["train_loss"].append(train_loss)
        history["train_acc"].append(train_acc)
        history["val_acc"].append(val_acc)

        print(f"Epoch {epoch+1}/{epochs} — loss: {train_loss:.4f}, "
              f"train acc: {train_acc:.2%}, val acc: {val_acc:.2%}")

    return history


def evaluate(layers, output_layer, X, y):
    correct = 0
    for x, label in zip(X, y):
        h = x
        for layer in layers:
            h = layer.forward(h)
        probs = output_layer.forward(h)
        correct += (np.argmax(probs) == label)
    return correct / len(y)
Це той самий цикл SGD із попередньої статті: перетасуйте дані, розділіть їх на міні-пакети, обчисліть і усередніть градієнти в кожній партії, а потім оновіть ваги один раз для партії. Єдина відмінність полягає в тому, що замість 5 точок даних і 2 параметрів ми маємо 60 000 зображень і 101 770 параметрів.
У Keras ми налаштовуємо навчання за допомогою compile і запускаємо його за допомогою fit:
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),  # gradient descent with lr=0.1
    loss="sparse_categorical_crossentropy",              # cross-entropy loss
    metrics=["accuracy"],
)

history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # hold out 20% of training data for validation
)
compile налаштовує функцію втрат і оптимізатор, а fit запускає повний цикл — прямий проход, втрати, зворотне поширення та градієнтний спад для кожної міні-серії в кожній епосі.
Давайте розберемо аргументи:
"sparse_categorical_crossentropy"— це перехресна втрата ентропії, яку ми вивели вище. Ім’я складається з трьох частин: «sparse» означає, що ми передаємо мітки як цілі числа (наприклад,3), а не одноразові вектори ([0,0,0,1,0,0,0,0,0,0]); «категоричний» означає, що ми класифікуємо за кількома категоріями; “кросентропія” - це функція втрат . У Keras також є"categorical_crossentropy"(без «розрідженого»), коли ваші мітки вже закодовані в одному режимі — математика та сама, лише інший формат введення.SGD(learning_rate=0.1)— стохастичний градієнтний спуск, те саме правило оновленняw = w - lr * dwз попередньої статті. Keras пропонує більш просунуті оптимізатори (Adam, RMSprop тощо), які автоматично адаптують швидкість навчання, але ми використовували звичайний SGD, і він добре працює тут.validation_split=0.2— зберігає 20% навчальних даних (12 000 зображень) як набір перевірки. Після кожної епохи Keras оцінює модель на цих відкладених зображеннях (тільки передній прохід, без оновлення ваги), щоб ми могли відстежувати, наскільки добре вона узагальнює. Решта 48 000 зображень використовуються для фактичного навчання.
Підготовка даних
Перш ніж ми зможемо почати навчання мережі, нам потрібно підготувати необроблені піксельні дані — мережа не може працювати безпосередньо з сітками 28×28 цілих чисел. Ми зробимо дві речі:
- Звести — змінити форму сітки 28×28 на один вектор із 784 чисел
- Нормалізувати — масштабувати значення пікселів від до
Зведення змінює форму кожного зображення розміром 28 × 28 у вектор із 784 входів, які очікує наша модель. Кожен нейрон у першому щільному шарі підключається до всіх 784 входів. Натомість згорточна мережа може використовувати просторове розташування пікселів, але наша щільна мережа розглядає їх як плоский список.
flatImage = image.reshape(784) # [0, 0, 0, ..., 156, 252, 128, ..., 0, 0] — 784 valuesНормалізація допомагає підтримувати вхідні значення в тому самому масштабі, що й ваги. Ваги зазвичай ініціалізуються малими випадковими числами близько 0, тому, якщо вхідні дані досягають 255, зважені суми стають величезними, що призводить до великих активацій, великих градієнтів і нестабільного навчання. Ділення на 255 дає все в — діапазон, де малі випадкові ваги дають прийнятні результати з самого початку. Це стандартна практика машинного навчання, не специфічна для MNIST.
Великі вхідні дані можуть підштовхнути активації сигмоїда до насичення, де їхні похідні наближаються до нуля та сприяють проблема зникнення градієнта. ReLU не насичується позитивно, але великі градієнти можуть спричинити оновлення ваги, що залишає нейрони неактивними. Ми розглянемо цю поведінку у вмираючій статті ReLU .
Нормалізація масштабує значення пікселів від до :
# Normalize pixel values from [0, 255] to [0, 1]
normalizedImage = flatImage / 255.0  # [0.0, 0.0, 0.0, ..., 0.61, 0.99, 0.50, ..., 0.0, 0.0]
Набори для навчання, перевірки та тестування
Перш ніж розпочати навчання, слід зрозуміти одну важливу відмінність. У нас є 60 000 навчальних зображень і 10 000 тестових зображень, але насправді нам потрібні три набори, а не два:
- Набір для навчання — дані, на основі яких навчається модель. Кожну епоху модель обробляє кожне зображення в цьому наборі, обчислює градієнти та оновлює ваги. Модель бачить ці зображення знову і знову.
- Набір перевірки — після кожної епохи модель виконує прямий проход цих зображень, щоб обчислити втрати та точність, але ці втрати призначені лише для звітування — без зворотного поширення, без обчислення градієнта, без оновлення ваги. Це суто вимірювання. Це говорить нам про те, наскільки добре модель узагальнюється: якщо вона отримує 98% даних навчання, але лише 90% даних перевірки, цей проміжок свідчить про переобладнання. Якщо точність перевірки перестає покращуватися, а точність навчання продовжує зростати, модель переобладнана.
- Тестовий набір — повністю окремий набір, оцінюваний один раз у самому кінці, після того, як усі рішення щодо навчання є остаточними. Це дає нам остаточну оцінку того, наскільки добре модель узагальнює невидимі зображення з того самого розподілу.
З точки зору нашого 4-етапного навчального циклу:
| Навчальний набір | Набір перевірки | Тестовий набір | |
|---|---|---|---|
| 1. Передача вперед | так | так | так |
| 2. Обчислити втрати | так | так (тільки для звітності) | так (тільки для звітності) |
| 3. Зворотне поширення | так | ні | ні |
| 4. Оновлення ваги | так | ні | ні |
Для тренувальних зображень виконуються всі 4 кроки — модель навчається. Для перевірки та тестування зображень виконуються лише кроки 1 і 2 — модель вимірює, як вона працює, але не змінює свої ваги на основі того, що вона бачить.
Чому б просто не використати тестовий набір для обох? Тому що кожного разу, коли ви перевіряєте продуктивність набору даних і приймаєте рішення на його основі (наприклад, «чи варто продовжувати навчання?»), ви тонко підлаштовуєтеся під ці дані. Якщо ви використовуєте набір тестів, щоб вирішити, коли припинити навчання, точність тесту стає оптимістично упередженою. Натомість набір перевірки поглинає це упередження, зберігаючи набір тестів чесним.
Набір перевірки також використовується для налаштування гіперпараметрів — таких параметрів, як швидкість навчання, розмір партії, кількість шарів і кількість епох. Ви пробуєте різні параметри, порівнюєте точність перевірки та вибираєте найкращий. Тестовий набір залишається запечатаним протягом цього процесу, щоб він міг дати неупереджену остаточну оцінку.
На практиці ви можете створити набір перевірки, відокремивши частину ваших навчальних даних. Keras полегшує це за допомогою validation_split:
history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # use 20% of training data as validation
)
Або ви можете розділити його вручну та передати окремий набір даних за допомогою validation_data=(X_val, y_val). Ми використаємо validation_split=0.2 — Keras надасть 20% тренувальних даних (12 000 зображень) для перевірки, навчаючись на решті 48 000. 10 000 тестових зображень залишаються повністю окремими для остаточної оцінки.
Навчання моделі
Давайте завантажимо та підготуємо набір даних за допомогою вбудованого завантажувача MNIST Keras:
import keras
import numpy as np

(train_images, train_labels), (test_images, test_labels) = keras.datasets.mnist.load_data()

# Flatten 28×28 → 784 and normalize to [0, 1]
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0
X_test = test_images.reshape(-1, 784).astype("float32") / 255.0
y_train = train_labels
y_test = test_labels

print(f"Training: {X_train.shape[0]} images, {X_train.shape[1]} pixels each")
print(f"Test:     {X_test.shape[0]} images")
# Training: 60000 images, 784 pixels each
# Test:     10000 images
Тепер ми маємо 60 000 навчальних зображень (кожне вектор із 784 значеннями від 0 до 1) та їхні мітки (кожне 0–9). Тестовий набір окремий — ми використовуватимемо його лише для того, щоб перевірити, наскільки добре модель узагальнює цифри, яких вона ніколи не бачила під час навчання.
Давайте навчимо нашу мережу:
# Split: 80% train, 20% validation
n_val = int(0.2 * len(X_train))
X_val, y_val = X_train[:n_val], y_train[:n_val]
X_train_sub, y_train_sub = X_train[n_val:], y_train[n_val:]

layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)

history = train([layer1], output, X_train_sub, y_train_sub, X_val, y_val,
                epochs=5, lr=0.1, batch_size=32)

# Epoch 1/5 — loss: 0.3260, train acc: 90.70%, val acc: 94.58%
# Epoch 2/5 — loss: 0.1608, train acc: 95.30%, val acc: 95.97%
# Epoch 3/5 — loss: 0.1147, train acc: 96.64%, val acc: 96.49%
# Epoch 4/5 — loss: 0.0898, train acc: 97.45%, val acc: 96.94%
# Epoch 5/5 — loss: 0.0737, train acc: 97.87%, val acc: 97.27%
Ось як виглядає тренування протягом 5 епох — ліворуч показано зниження втрат у міру навчання моделі, праворуч — підвищення точності. Зелені крапки — це точність перевірки (val_accuracy), виміряна наприкінці кожної епохи на відкладених зображеннях, на яких модель ніколи не тренується:
Після п’яти епох мережа правильно класифікує близько 97% затриманих зображень перевірки.
Перша епоха вже повідомляє про 90% точності навчання. Це середнє значення прогнозів, зроблених протягом епохи, коли модель навчається, охоплюючи 1500 партій і оновлень ваги. Точність перевірки вимірюється окремо в кінці епохи за допомогою оновленої моделі.
Подивіться на розрив між синьою (train) і зеленою (val) лініями — особливо на діаграмі збитків. Втрати під час навчання постійно знижуються, але втрати під час валідації згладжуються приблизно на епосі 4-5 і навіть починають збільшуватися. Це початок переобладнання: модель починає запам’ятовувати тренувальні дані, а не вивчати шаблони, які узагальнюють нові зображення. З подальшим навчанням цей розрив може зростати: точність навчання може продовжувати покращуватися, тоді як точність перевірки зупиняється або знижується. Ось чому нам потрібен набір перевірки — він говорить нам, коли зупинитися. У наступній статті ми детально розглянемо надмірне оснащення.
Спробуйте самі
У нас є блокнот-компаньйон, де ви можете запускати обидві реалізації Keras і NumPy поруч. Усі клітинки виконуються автоматично — ви побачите навчальний вихід Keras, а потім навчальний вихід NumPy з тими самими показниками.
Результат Keras виглядає так:
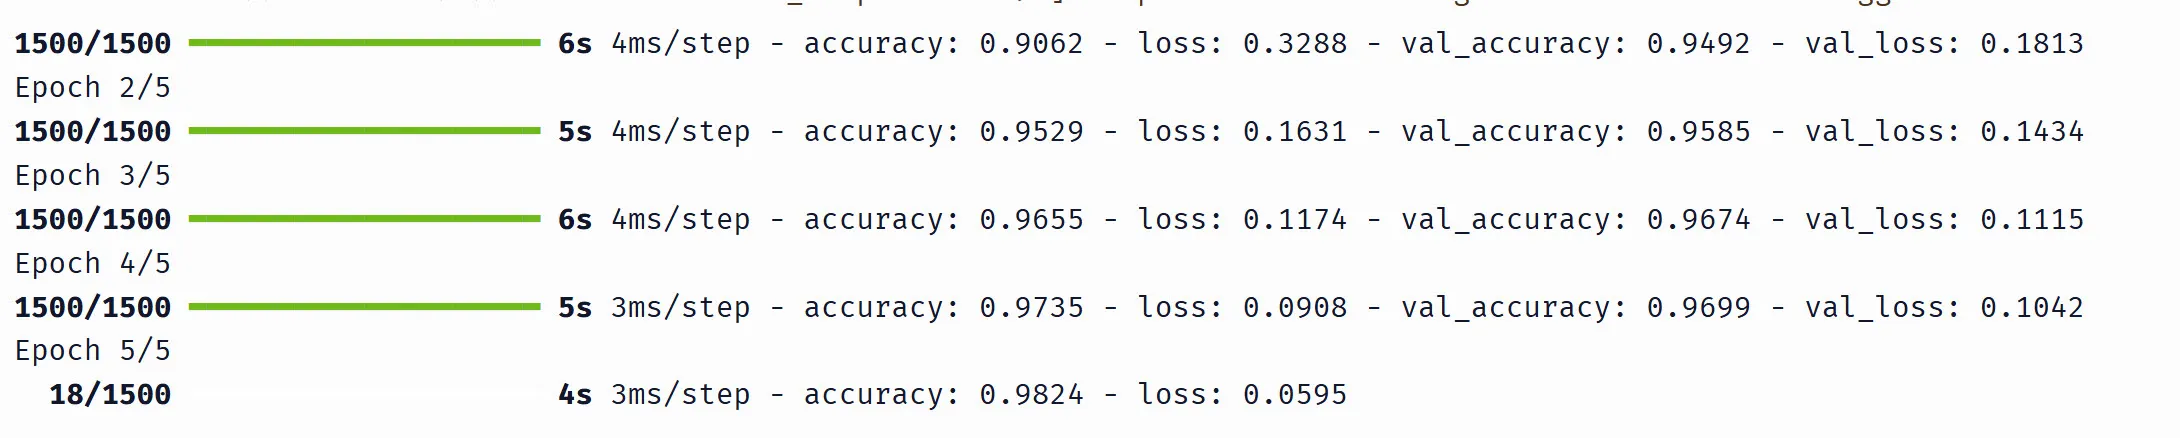
Ось що означає кожна частина:
1500/1500— завершено 1500 міні-пакетів із 1500 (48 000 навчальних зображень / 32 на пакет). Під час навчання ви побачите цей підрахунок (наприклад,18/1500означає 18 виконаних партій).5s 4ms/step— епоха зайняла 5 секунд, ~4 мілісекунди на партіюaccuracy: 0.9529іloss: 0.1631— показники навчання, усереднені за всіма партіями в епосіval_accuracy: 0.9585іval_loss: 0.1434— показники перевірки, обчислені один раз наприкінці епохи на 12 000 відкладених зображень
Числа від Keras і NumPy не будуть ідентичними (різна ініціалізація випадкової ваги), але вони повинні бути близькими — обидва з точністю перевірки приблизно 97% після 5 епох. Ці схожі результати узгоджуються з двома реалізаціями, що використовують той самий алгоритм навчання.
Що ми розглянули
Ми взяли кожну концепцію з попередньої статті та застосували її до реальної проблеми — класифікації рукописних цифр за допомогою 100 000+ параметрів замість підгонки рядка до 2:
- Класифікація проти регресії: softmax перетворює необроблені логіти в імовірності, крос-ентропія вимірює, наскільки помилковими є ці ймовірності
- Перехід: вхідні дані проходять через рівні, кожен обчислює — та сама формула, тепер у матричній формі
- Зворотне розповсюдження: градієнт softmax + крос-ентропія спрощується до , а правило ланцюга протікає назад через шари точно так, як ми вивели вручну
- Навчальний цикл: перетасування, розбиття на міні-пакети, перехід вперед → втрата → підтримка → оновлення — повторюється для кожної партії в кожній епосі
Алгоритм ідентичний тому, що ми побудували в попередній статті. Keras автоматизує це, але під капотом це те саме обчислення, яке крок за кроком виконує наш код NumPy.
Ми залишили налаштування незмінними — один прихований шар із 128 нейронів, швидкість навчання 0,1, розмір партії 32. Що станеться, якщо ми їх змінимо? У наступній статті ми систематично змінюватимемо кожну частину — швидкість навчання, розмір партії, глибину мережі, функції активації — і досліджуватимемо переобладнання, ранню зупинку та діагностику, коли навчання йде не так.