Trenowanie prawdziwej sieci na MNIST
W poprzednim artykule omówiliśmy główne etapy i pojęcia związane z trenowaniem sieci neuronowej: przejście w przód, funkcje straty, propagację wsteczną, spadek gradientu, współczynnik uczenia, mini-batche i zanikające gradienty. Posłużyliśmy się prostym przykładem dopasowania prostej o 2 parametrach: dla wejścia przewidzieć . To była regresja: sieć zwraca jedną liczbę z zakresu ciągłego, taką jak cena lub temperatura. Błąd predykcji mierzyliśmy błędem średniokwadratowym — funkcją straty wybraną do tego zadania.
Tutaj zajmiemy się klasyfikacją. Na podstawie obrazu odręcznej cyfry sieć przypisze prawdopodobieństwo każdej kategorii i wybierze cyfrę z najwyższym wynikiem. Użyjemy klasycznego zbioru MNIST — 70 000 obrazów odręcznych cyfr od 0 do 9.
Najpierw zbudujemy wszystko od zera w NumPy — samodzielnie napiszemy przejście w przód, funkcję straty, propagację wsteczną i spadek gradientu, żeby prześledzić każdy krok treningu. Potem pokażemy to samo w Kerasie, wysokopoziomowym frameworku, który wykonuje te operacje automatycznie na podstawie kilku wywołań. Keras może korzystać z PyTorcha, TensorFlow albo JAX. Te backendy obsługują akcelerację na GPU i automatyczne obliczanie gradientów, a Keras udostępnia wygodny interfejs. Nasza implementacja w NumPy przetwarza po jednym obrazie, aby łatwo było śledzić obliczenia. Keras potrafi wydajnie przetwarzać całe batche i korzystać z GPU przy większych zadaniach.
Zbiór danych
MNIST to kolekcja 70 000 odręcznych cyfr (0–9) — 60 000 do treningu i 10 000 do testów. Każdy obraz ma 28×28 pikseli, w odcieniach szarości.
Oto kilka przykładów:
Obrazy i etykiety są przechowywane jako tablice NumPy. Spójrzmy na surowe dane.
# 60,000 images, each a matrix of 28×28 pixels
>>> train_images.shape
(60000, 28, 28)

# A single image: 28 rows × 28 columns of pixel values (0–255)
>>> train_images[0].shape
(28, 28)

>>> train_images[0].dtype
dtype('uint8')

# 60,000 labels: first image is "5", second is "0", ...
>>> train_labels
array([5, 0, 4, ..., 5, 6, 8], dtype=uint8)

# 10,000 test images, same 28×28 matrices
>>> test_images.shape
(10000, 28, 28)

# 10,000 labels for test images
>>> test_labels
array([7, 2, 1, ..., 4, 5, 6], dtype=uint8)
Każda wartość w siatce 28×28 to intensywność piksela. Każdy piksel zajmuje jeden bajt (8 bitów), więc może przyjmować wartości — od 0 do 255. W surowych danych 0 oznacza czerń, a 255 biel, dlatego cyfry MNIST mają białe kreski na czarnym tle. To popularny format zapisu obrazów w odcieniach szarości. Obraz RGB z 8 bitami na kanał używa trzech wartości na piksel (czerwonej, zielonej i niebieskiej); MNIST potrzebuje tylko jednej.
Ta siatka liczb 28×28 jest obrazem — każda liczba odwzorowuje się wprost na odcień szarości. Kliknij dowolny piksel poniżej i wpisz nową wartość, żeby zobaczyć to w praktyce. Przełącznikiem możesz przechodzić między oryginalną reprezentacją (biel na czerni) a widokiem odwróconym (czerń na bieli, który czyta się łatwiej):
Wartości pikseli w powiększonej siatce nie zmieniają się przy przełączaniu widoku — zawsze pokazują dane zapisane w tablicy. Przełącznik zmienia tylko sposób wyświetlania tych wartości. Piksel o wartości 255 jest biały w trybie oryginalnym i czarny w odwróconym. Te 784 liczby to dane obrazu, które otrzymuje sieć.
Każdy obraz ma etykietę — cyfrę, którą przedstawia (0–9). Razem te dwie tablice — obrazy i etykiety — to wszystko, z czego sieć będzie się uczyć. Zadanie jest proste: mając obraz 28×28, przewidzieć, która to cyfra. To problem klasyfikacji z 10 klasami — sieć, którą zbudujemy, nazywa się klasyfikatorem wieloklasowym. W klasyfikacji klasa to jedna z możliwych etykiet — jedna kategoria, którą model może wybrać. Mamy 10 klas (cyfry 0–9) z mniej więcej 6 000 przykładów treningowych na cyfrę (nie idealnie po równo — cyfra 1 ma 6 742 przykłady, a cyfra 5 tylko 5 421).
Od regresji do klasyfikacji
Przechodząc od zadania regresji z poprzedniego artykułu () do klasyfikacji cyfr, będziemy potrzebować:
- Warstwy wyjściowej — zamiast jednego neuronu zwracającego jedną liczbę potrzebujemy 10 neuronów (po jednym na cyfrę) oraz funkcji aktywacji softmax, która przekształci ich wyniki w rozkład prawdopodobieństwa.
- Funkcji straty — zamiast błędu średniokwadratowego, który mierzy odległość predykcji od wartości docelowej, użyjemy entropii krzyżowej, która zależy od prawdopodobieństwa przypisanego poprawnej klasie.
- Gradientu — wzór na gradient musi odpowiadać nowej funkcji straty. Połączenie entropii krzyżowej z softmaxem daje prosty wzór.
- Aktywacji warstwy ukrytej — potrzebujemy nieliniowej funkcji aktywacji między warstwami, żeby sieć mogła uczyć się złożonych wzorców. Użyjemy ReLU, tej samej funkcji co w przykładach neuronu i warstwy z poprzedniego artykułu.
Rdzeń algorytmu — przejście w przód, propagacja wsteczna, spadek gradientu, mini-batche — pozostaje ten sam. Przejdźmy przez każdy element.
Warstwa wyjściowa i softmax
W regresji sieć wypuszcza jedną liczbę. W klasyfikacji musi wybrać ze zbioru kategorii — w naszym przypadku jedną z 10 cyfr. Sieć musi powiedzieć „myślę, że to 2” z jakimś poziomem pewności.
Załatwiamy to, dając warstwie wyjściowej 10 neuronów — po jednym na cyfrę. Każdy neuron produkuje wynik zwany logitem (nazwa pochodzi od „log-odds” z regresji logistycznej, ale w praktyce znaczy po prostu „surowy wynik przed softmaxem”), wskazujący, jak silnie sieć wierzy, że wejściem jest ta cyfra. Wyższy wynik to większa pewność.
Przy 10 cyfrach nasza warstwa wyjściowa produkuje 10 logitów — po jednym na klasę. Żeby przykłady i wizualizacje były prostsze, w kodzie poniżej użyjemy tylko 3 klas (cyfry 0, 1, 2) — matematyka działa dokładnie tak samo, tylko liczb do oglądania jest mniej.
Dla danego obrazu wejściowego wyjście może wyglądać tak:
Obraz wchodzi, sieć przetwarza go przez swoje warstwy i wychodzą 3 liczby — po jednej na cyfrę. Cyfra 2 dostała najwyższy wynik (4.2), więc to jest predykcja sieci. W kodzie:
logits = [1.5, -0.3, 4.2]
#          0     1    2

# The network's guess: digit 2 (highest logit = 4.2)
# argmax returns the index of the largest value, not the value itself
prediction = np.argmax(logits)  # 2
Surowe logity nie są prawdopodobieństwami — mogą być dodatnie lub ujemne i nie muszą sumować się do 1. Przekształcamy je w rozkład prawdopodobieństwa za pomocą funkcji softmax. Używa się jej w klasyfikatorach obrazów i modelach językowych, w których zamienia wyniki dla tokenów słownika w prawdopodobieństwa kolejnego tokena:
Dlaczego nazywa się „softmax”? Bo to łagodniejsza wersja maksimum. Twardy max po prostu wybrałby największą wartość i zignorował całą resztę — [0, 0, 1]. Softmax robi prawie to samo, gdy jeden logit dominuje, ale gdy logity są podobnie duże, pozostałe wartości też dostają sensowną wagę. Porównaj:
| logity | twardy max | softmax |
|---|---|---|
| [1.0, 8.5, 1.0] | [0, 1, 0] | [0.1%, 99.9%, 0.1%] |
| [3.0, 3.5, 3.0] | [0, 1, 0] | [27.4%, 45.2%, 27.4%] |
| [3.0, 3.0, 3.0] | nieokreślony (remis) | [33.3%, 33.3%, 33.3%] |
Twardy max daje odpowiedź binarną — zwycięzca bierze wszystko. Softmax daje gładki rozkład, który zmienia się w sposób ciągły wraz z wejściami. Gdy model jest niepewny (logity blisko siebie), softmax to odzwierciedla. Gdy model jest pewny (jeden logit znacznie większy), softmax zbliża się do twardego maksimum. To gładkie zachowanie jest też tym, co sprawia, że propagacja wsteczna działa — przez softmax da się liczyć gradienty, bo jest różniczkowalny wszędzie.
Twardy max nie daje użytecznego gradientu: między skokami jego wyjście jest stałe. Softmax jest różniczkowalny, więc można przez niego propagować gradient. Matematycznie skończone logity dają prawdopodobieństwa ściśle między 0 a 1, choć arytmetyka zmiennoprzecinkowa może zaokrąglić bardzo małe wartości do 0. W interaktywnym przykładzie poniżej ustaw dwa pierwsze logity na 0, a trzeci na dużą liczbę.
Softmax działa w trzech krokach (na naszych przykładowych logitach [1.5, -0.3, 4.2]):
- Podnieś do potęgi każdego logitu — skoro dla dowolnego , zamienia to każdą wartość, nawet ujemną, w liczbę dodatnią: , ,
- Zsumuj wszystkie dodatnie wartości —
- Podziel każdą wartość przez tę sumę — , itd.
To normalizuje listę tak, że sumuje się dokładnie do 1 — porządny rozkład prawdopodobieństwa.
Softmax wykorzystuje efekt wzmocnienia funkcji wykładniczej. Różnice między logitami przekładają się na stosunki ich wartości po potęgowaniu: , podczas gdy i . Różnica 2.7 między logitami 4.2 i 1.5 daje około 15-krotną różnicę między wartościami funkcji wykładniczej. Po podzieleniu przez sumę cyfra 2 otrzymuje 92.7% prawdopodobieństwa. Prawdopodobieństwo skupia się więc na klasie z najwyższym wynikiem, choć wysoka wartość nie gwarantuje poprawnej predykcji.
Tym efektem wzmocnienia możesz sterować parametrem temperatury . Wzór staje się taki:
Dzielenie przez przed eksponencjacją skaluje różnice między logitami. Spróbuj przeciągnąć suwak T:
- T → 0 (niska temperatura) — różnice zostają wzmocnione, rozkład robi się ostry. Najwyższy logit dostaje prawie 100%. To zbliża się do twardego maksimum.
- T = 1 — standardowy softmax. Dzielenie przez 1 nic nie zmienia, więc jest to równoważne brakowi .
- T → ∞ (wysoka temperatura) — różnice zostają spłaszczone, wszystkie logity stają się podobne, a rozkład zbliża się do jednostajnego (po 33.3%).
Modele językowe również używają temperatury przy losowaniu kolejnego tokena. Niska temperatura skupia prawdopodobieństwo na najbardziej prawdopodobnych tokenach, dzięki czemu wynik jest bardziej przewidywalny. Wysoka rozkłada prawdopodobieństwo równomierniej, pozwalając na bardziej zróżnicowane wybory, czasem kosztem spójności tekstu.
Tak zaimplementowalibyśmy softmax w Pythonie:
def softmax(logits):
    # Subtract max for numerical stability (doesn't change the result,
    # but prevents overflow when computing e^z for large values)
    exp = np.exp(logits - np.max(logits))
    return exp / np.sum(exp)

probs = softmax(logits)
# [0.063, 0.010, 0.927]
#   0      1      2
# The highest probability is 92.7% for digit 2
Zwróć uwagę, że odejmujemy największy logit. Robimy to, ponieważ softmax oblicza , a funkcja wykładnicza rośnie bardzo szybko. Jeśli logit wynosi 1000, to przekracza zakres liczb zmiennoprzecinkowych i daje nieskończoność:
>>> import numpy as np
>>> np.exp(1000)
inf                    # overflow — can't compute

>>> np.exp(1000) / (np.exp(1) + np.exp(2) + np.exp(1000))
nan                    # infinity / infinity = undefined
Odjęcie maksymalnego logitu od wszystkich wartości przed eksponencjacją przesuwa największą wartość do 0, a wszystkie pozostałe czyni ujemnymi. Względna kolejność jest zachowana — nadal jest największe, bo jest zawsze mniejsze od 1 — więc prawdopodobieństwa wychodzą takie same:
>>> logits = [1, 2, 1000]
>>> max(logits)
1000

>>> [z - max(logits) for z in logits]
[-999, -998, 0]        # largest becomes 0, others become negative

>>> np.exp([-999, -998, 0])
array([0., 0., 1.])    # e⁰ = 1 is the largest (e^negative is always < 1), no overflow
Tu widać, jak matematycznie wychodzą te same prawdopodobieństwa z odejmowaniem i bez:
Czynnik się skraca, ale uniknęliśmy liczenia niebezpiecznie dużych potęg. To standardowa sztuczka na stabilność numeryczną, którą zobaczysz w każdej implementacji softmaxu.
ReLU: funkcja aktywacji dla warstw ukrytych
Omówiliśmy już jedną funkcję aktywacji — softmax na warstwie wyjściowej, zamieniający logity w prawdopodobieństwa. Ale potrzebujemy też funkcji aktywacji na warstwach ukrytych. Wytrenowany model z poprzedniego artykułu () był pojedynczą operacją liniową — bez funkcji aktywacji, bez warstw ukrytych.
Wyjaśniono tam też, dlaczego układanie warstw bez funkcji aktywacji jest bez sensu: łańcuch operacji liniowych zapada się do jednej operacji liniowej. Żeby uczyć się złożonych wzorców, a nie samych prostych, potrzebujemy nieliniowości między warstwami. Poprzedni artykuł przedstawił funkcje aktywacji jako rozwiązanie, pokazując kilka opcji w widgecie neuronu (sigmoid, perceptron, ReLU).
Użyjemy ReLU (Rectified Linear Unit), popularnej funkcji aktywacji warstw ukrytych:
Przepuszcza wartości dodatnie bez zmian, a ujemne obcina do zera. Przeciągnij suwaki poniżej — gdy suma ważona jest dodatnia (zielone), wartość przechodzi. Gdy jest ujemna (czerwone), wyjście zostaje obcięte do 0:
Zachowanie widać przy poruszaniu oboma suwakami — liczy się suma ważona w × x, a nie poszczególne wartości. Spróbuj ustawić i wejście, i wagę na liczby ujemne: iloczyn jest dodatni, więc ReLU go przepuszcza. Obcina do zera tylko wtedy, gdy sam iloczyn jest ujemny.
ReLU ma prostą pochodną, co przydaje się podczas propagacji wstecznej. Pochodna funkcji aktywacji jest jednym z czynników w iloczynie wynikającym z reguły łańcuchowej. W poprzednim artykule gradient dla wagi warstwy ukrytej wyglądał tak:
dw11 = x1 * relu_deriv(z1) * v1 * 2 * error
#            ↑ activation derivative — one factor in the chain
Gradient straty jest iloczynem lokalnych pochodnych wzdłuż ścieżki obliczeń. relu_deriv to jeden z tych czynników: gdy wynosi 1, gradient przechodzi bez zmian; gdy wynosi 0, neuron nie otrzymuje gradientu z tego wejścia. Neuron nieaktywny dla wszystkich wejść treningowych może całkowicie przestać się uczyć — to problem umierającego ReLU. Sigmoida ma inne ograniczenie: jej pochodna wynosi najwyżej 0.25 i zbliża się do zera, gdy aktywacja nasyca się w pobliżu 0 lub 1. Te małe czynniki mogą się kumulować w kolejnych warstwach.
Dlaczego sigmoid jest gorszy od ReLU dla gradientów?
Pochodna sigmoidy to . Skoro sigmoid daje wartość między 0 a 1, jest to — co jest maksymalne przy (przy ): . Gdy oddala się od 0 w którąkolwiek stronę, sigmoid saturuje ku 0 albo 1, a pochodna maleje ku 0.
Dla pięciu warstw z sigmoidą iloczyn samych pochodnych aktywacji wynosi najwyżej . Na pełny gradient wpływają także macierze wag, ale małe wartości tych pochodnych mogą utrudniać uczenie wcześniejszych warstw. Pochodna ReLU wynosi 1 dla aktywnych neuronów, więc na etapie aktywacji nie zmniejszają one gradientu.
Nasza sieć ma zatem dwie różne funkcje aktywacji pełniące dwie różne role: ReLU w warstwach ukrytych (wprowadza nieliniowość, żeby sieć mogła uczyć się złożonych wzorców) i softmax na warstwie wyjściowej (zamienia surowe wyniki w prawdopodobieństwa).
Funkcja straty
Teraz potrzebujemy funkcji straty. W poprzednim artykule użyliśmy błędu średniokwadratowego — kwadratu różnicy między predykcją a celem, uśrednionego po wszystkich punktach danych. Miało to sens dla regresji: predykcja była jedną liczbą, cel był jedną liczbą i chcieliśmy, żeby były blisko.
Dla klasyfikacji używamy straty entropii krzyżowej. Idea jest prosta: weź ujemny logarytm prawdopodobieństwa, które model przypisał poprawnej klasie.
Im niższe prawdopodobieństwo, tym wyższa strata:
- Model mówi, że jest 95% szans na trafienie: — niska strata, dobra predykcja
- Model mówi 60%: — umiarkowana strata, za mała pewność
- Model mówi 1%: — bardzo wysoka strata, prawie kompletna pomyłka
Dlaczego używamy ujemnego logarytmu?
- Przy strata wynosi zero: .
- Gdy zbliża się do 0, strata rośnie bez ograniczeń, karząc predykcje, które przypisują poprawnej klasie bardzo małe prawdopodobieństwo.
- Pochodna wynosi , więc mała zmiana prawdopodobieństwa znacznie silniej wpływa na stratę w pobliżu 0 niż w pobliżu 1.
Wykresy poniżej pokazują i obok siebie. Obie krzywe są strome w pobliżu 0. Znak minus odbija wykres względem osi poziomej: otrzymujemy nieujemną stratę, która maleje, gdy rośnie prawdopodobieństwo poprawnej klasy.
Na przykład pochodna względem wynosi przy i około przy . To tylko jeden czynnik w propagacji wstecznej. Aby obliczyć gradienty względem logitów i wag, potrzebujemy też pochodnych softmaxu i wcześniejszych warstw. Wyprowadzimy je poniżej.
Przeciągnij suwaki poniżej i obserwuj żółty punkt na krzywej :
Poprawną klasą jest cyfra 2. Zwiększ jej prawdopodobieństwo, a strata zbliży się do zera; zmniejsz je, a strata gwałtownie wzrośnie.
W Pythonie funkcja straty wygląda tak. Bierze przewidziane przez model prawdopodobieństwa i prawdziwą etykietę (indeks poprawnej klasy — 0, 1 albo 2) i zwraca prawdopodobieństwa przypisanego tej klasie:
def cross_entropy_loss(probs, label):
    # label is the index of the correct class
    p_correct = probs[label]       # e.g. probs[2] = 0.94
    return -np.log(p_correct)      # -log(0.94) = 0.062

# Model is confident and correct → low loss
cross_entropy_loss([0.05, 0.01, 0.94], label=2)   # 0.062

# Model is uncertain → moderate loss
cross_entropy_loss([0.30, 0.30, 0.40], label=2)    # 0.916

# Model is confident but wrong → high loss
cross_entropy_loss([0.80, 0.15, 0.05], label=2)    # 2.996
Strata a trafność
Podczas treningu śledzimy zarówno stratę, jak i trafność — są skorelowane, ale to nie to samo.
Trafność to odsetek poprawnych predykcji. Każda predykcja jest albo poprawna, albo błędna — stopień pewności nie zmienia tego wyniku. Prawdopodobieństwo 0.51 dla poprawnej klasy daje jedno trafienie, tak samo jak 0.99. Strata jest jednak różna: 0.67 w pierwszym przypadku i 0.01 w drugim.
Strata (entropia krzyżowa) zależy od prawdopodobieństwa przypisanego poprawnej klasie — im jest ono mniejsze, tym większa kara. Dwa modele mogą mieć tę samą trafność, ale różną stratę, jeśli jeden przypisuje poprawnym klasom wyższe prawdopodobieństwa.
Oto jak wygląda to w prawdziwym logu treningowym:
Epoch 1/10  — accuracy: 0.5117 — loss: 1.7934 — val_accuracy: 0.7520 — val_loss: 1.3155
Epoch 2/10  — accuracy: 0.7806 — loss: 1.0726 — val_accuracy: 0.8377 — val_loss: 0.8382
Epoch 5/10  — accuracy: 0.8627 — loss: 0.5560 — val_accuracy: 0.8798 — val_loss: 0.4901
W epoce 1 accuracy: 0.5117 oznacza, że model przewidział poprawną cyfrę dla 51% obrazów treningowych — dla każdego obrazu klasa o najwyższym prawdopodobieństwie jest porównywana z prawdziwą etykietą i liczony jest ułamek trafień. To już sporo powyżej 10% odniesienia dla losowego zgadywania spośród 10 klas, ale wciąż błąd na połowie obrazów.
Strata 1.79 wskazuje, że model często przypisuje poprawnej klasie niskie prawdopodobieństwo. Może poprawnie wybierać klasę, ale z małą pewnością (np. 0.3 zamiast 0.9), lub przypisywać wysokie prawdopodobieństwo błędnej klasie. Kilka takich pewnych, lecz błędnych predykcji może nieproporcjonalnie zwiększyć średnią stratę.
Różnica między trafnością a stratą oznacza, że nie zawsze poruszają się razem:
- Strata spada, trafność stoi — model staje się pewniejszy w predykcjach, które i tak robił poprawnie. Na przykład jeśli model już przewiduje „7” dla obrazu siódemki, ale jego pewność rośnie z 0.4 do 0.9, trafność się nie zmienia (już była poprawna), za to strata wyraźnie spada.
- Trafność rośnie i strata też rośnie — model zdobywa więcej poprawnych predykcji, ale staje się nadmiernie pewny na tych błędnych. Wyobraź sobie, że model naprawia 5 obrazów, które wcześniej mylił (trafność się poprawia), ale jednocześnie staje się bardzo pewny (0.95) na 2 obrazach, które myli. Strata z tych 2 pewnych pomyłek może przeważyć poprawę z 5 nowych trafień.
- Obie stoją w miejscu — model utknął. Wagi się zmieniają, ale predykcje nie są istotnie inne. Zdarza się to często, gdy współczynnik uczenia jest za mały albo model osiągnął swoją pojemność.
W praktyce podczas prawidłowego treningu obie metryki zwykle poprawiają się razem, tak jak w logu powyżej. Gdy zaczynają się rozchodzić, sprawdź, czy model nie staje się bardziej pewny swoich błędnych predykcji.
Gradient
W poprzednim artykule widzieliśmy, że trening wymaga policzenia gradientu straty względem każdego parametru — pochodnej, która mówi, w którą stronę pchnąć każdą wagę, żeby zmniejszyć błąd. Dla naszego przykładu z dopasowaniem prostej pokazaliśmy, jak doszliśmy do wzoru na gradient MSE. Teraz potrzebujemy gradientu straty entropii krzyżowej względem logitów (surowych wyników przed softmaxem).
Oto jak wygląda pojedynczy neuron warstwy wyjściowej — logit to suma ważona przed zastosowaniem funkcji aktywacji:
Sam softmax nie ma uczonych parametrów — przekształca tylko logity w prawdopodobieństwa. Uczone wagi należą do neuronów, które obliczają sumy ważone i zwracają logity. Gradient względem logitów służy do obliczenia gradientów dla wag wyjściowych i warstw ukrytych. Dopiero optymalizator używa tych gradientów do aktualizacji parametrów.
Wzór na MSE, do którego doszliśmy w poprzednim artykule, miał czytelną strukturę: dw = 2 * mean(error * x) — błąd razy wejście, uśrednione po przykładach.
Każdy element wziął się z reguły łańcuchowej zastosowanej do funkcji straty. Teraz musimy zrobić to samo dla entropii krzyżowej w połączeniu z softmaxem. Przejdziemy przez to w trzech częściach:
- Gradient przez softmax (warstwa wyjściowa) — wyprowadzić gradient entropii krzyżowej + softmaxu względem logitów i dojść do czystego wzoru
- Gradient przez ReLU (warstwa ukryta) — pokazać, jak gradient przepływa przez funkcję aktywacji warstwy ukrytej
- Złożenie wszystkiego — spiąć obie części w pełne przejście wstecz
Pełny łańcuch w przód to: wejścia → warstwa ukryta (wagi + ReLU) → logity → softmax → prawdopodobieństwa → entropia krzyżowa → strata. Przejście wstecz idzie w odwrotną stronę — zaczynamy od straty i stosujemy regułę łańcuchową z powrotem przez entropię krzyżową, softmax, a potem warstwy ukryte.
Matematyka poniżej jest bardziej rozbudowana niż gradient MSE z poprzedniego artykułu — żeby użyć wyniku, nie trzeba śledzić każdego kroku. Jeśli wolisz, możesz przeskoczyć do końcowego wzoru i kodu. Ale jeśli chcesz zobaczyć, skąd się bierze, oto on krok po kroku.
Gradient przez softmax (warstwa wyjściowa)
Krok 1: pochodna straty. Strata to , gdzie jest poprawną klasą. Pochodną już znamy: to . Zatem:
Krok 2: pochodna softmaxu. Mamy już pochodną straty względem . Ale potrzebujemy pochodnej względem logitów — bo to je faktycznie produkują wagi warstwy (jak pokazuje diagram powyżej). Żeby zasypać tę lukę, musimy wiedzieć: jak softmax zamienia zmianę w zmianę ?
Softmax to . Korzystając z reguły ilorazu, mamy dwa przypadki:
Jeśli (pchamy logit własnej klasy):
Wygląda to jak pochodna sigmoidy — i tak jest. Każde wyjście softmaxu zachowuje się lokalnie jak sigmoid.
Jeśli (pchamy inny logit):
Pierwszy składnik licznika to 0, bo nie zależy od . Zwiększenie jednego logitu zawsze zmniejsza pozostałe prawdopodobieństwa — muszą sumować się do 1.
Krok 3: reguła łańcuchowa. Pomnóż obie pochodne:
- Dla poprawnej klasy ():
- Dla błędnej klasy ():
Wynik
Po połączeniu pochodnych otrzymujemy gradient entropii krzyżowej względem każdego logitu :
Jak liczymy to w praktyce? Za pomocą , wektora one-hot — samych zer z jedynką na poprawnej klasie. Ponieważ dla poprawnej klasy i dla całej reszty, odjęcie od daje dla poprawnej klasy i dla pozostałych — dokładnie ten sam wynik co w powyższym wzorze z podziałem na przypadki:
W Pythonie to po prostu:
grad_z = probs - one_hot_label # gradient w.r.t. logitsGradient względem logitów to różnica między wektorem przewidzianych prawdopodobieństw a wektorem docelowym one-hot.
Zobaczmy, co to znaczy, na konkretnym przykładzie dla 3 klas. Jeśli model daje prawdopodobieństwa [0.06, 0.01, 0.93], a poprawną klasą jest 2:
- Cel (one-hot) to
[0, 0, 1]— całe prawdopodobieństwo powinno być na klasie 2 - Gradient to
[0.06 − 0, 0.01 − 0, 0.93 − 1]=[0.06, 0.01, −0.07]
Znak mówi o kierunku: klasa 2 dostaje ujemny gradient (−0.07), co znaczy „pchnij ten logit w górę, żeby zwiększyć jego prawdopodobieństwo”. Klasy 0 i 1 dostają gradienty dodatnie, czyli „pchnij te logity w dół”. Wielkość mówi o ile — klasa 0 (0.06) potrzebuje większej korekty niż klasa 1 (0.01), bo więcej prawdopodobieństwa do niej wyciekło.
Zauważ, że jest gradientem względem logitów, nie wag. Pamiętaj, neuron wyjściowy liczy (logit), a potem softmax zamienia go w prawdopodobieństwo. Pełny łańcuch od straty do wag ma więc dwie części:
Pierwsza część () to to, co właśnie wyprowadziliśmy — jak strata zmienia się wraz z logitami. Druga część () to pochodna względem , czyli po prostu wejście. Ich przemnożenie daje gradient wag:
grad_z = probs - one_hot_label       # part 1: loss → logits (p - y)
grad_W = np.outer(grad_z, x)         # part 1 × part 2: logits → weights
grad_b = grad_z                       # bias gradient (same as grad_z)
grad_input = W.T @ grad_z            # gradient to pass to the previous layer
grad_input = W.T @ grad_z to sygnał gradientu przekazywany do poprzedniej warstwy. Ta warstwa robi potem to samo — tylko z ReLU zamiast softmaxu.
Gradient przez ReLU (warstwa ukryta)
Warstwa ukryta liczy , a potem stosuje ReLU: . Wyprowadziliśmy to w poprzednim artykule — gdy gradient przychodzi z następnej warstwy (grad_output), reguła łańcuchowa mnoży go przez pochodną ReLU:
Jeśli neuron był aktywny (), gradient przechodzi bez zmian. Jeśli był nieaktywny (), gradient zostaje wyzerowany. Potem, tak jak w warstwie wyjściowej, kontynuujemy łańcuch, żeby dostać gradienty wag:
grad_z = grad_output * (z > 0)       # multiply by ReLU derivative (0 or 1)
grad_W = np.outer(grad_z, x)         # chain rule: gradient for weights
grad_b = grad_z                       # gradient for biases
grad_input = W.T @ grad_z            # pass to the previous layer
Złożenie wszystkiego
Pełne przejście wstecz przechodzi łańcuchem przez każdą warstwę, zaczynając od straty:
- Warstwa wyjściowa: → policz
grad_W,grad_b, przekażgrad_inputwstecz - Warstwa ukryta: odbierz
grad_input, pomnóż przez pochodną ReLU → policzgrad_W,grad_b, przekażgrad_inputwstecz - Powtórz dla ewentualnych dodatkowych warstw ukrytych
Schemat jest ten sam na każdej warstwie — różni się tylko pochodna aktywacji (softmax vs ReLU). Oto pełne przejście wstecz dla naszej sieci (jedna warstwa ukryta + warstwa wyjściowa):
# Forward pass (for reference)
z1 = W1 @ x + b1              # hidden layer: weighted sum
h = relu(z1)                   # ReLU activation
z = W2 @ h + b2                 # output layer: hidden → logits
p = softmax(z)                  # softmax: logits → probabilities
loss = -np.log(p[label])        # cross-entropy loss

# Backward pass: chain rule from loss back to weights
# 1. Output layer gradient (softmax + cross-entropy)
grad_z2 = p.copy()
grad_z2[label] -= 1             # p - y

grad_W2 = np.outer(grad_z2, h)  # weight gradient
grad_b2 = grad_z2               # bias gradient
grad_h = W2.T @ grad_z2         # pass gradient to hidden layer

# 2. Hidden layer gradient (ReLU)
grad_z1 = grad_h * (z1 > 0)     # multiply by ReLU derivative

grad_W1 = np.outer(grad_z1, x)  # weight gradient
grad_b1 = grad_z1               # bias gradient

# 3. Update all weights
W2 -= lr * grad_W2
b2 -= lr * grad_b2
W1 -= lr * grad_W1
b1 -= lr * grad_b1
Dokładnie to zaimplementują nasze HiddenLayer.backward() i OutputLayer.backward() w kodzie NumPy poniżej — te same kroki, tylko opakowane w klasy.
Widget poniżej uruchamia dokładnie tę pętlę na maleńkiej sieci — namiastka obrazu 2×2 zasilająca 2-neuronową warstwę ukrytą i wyjście z 3 klasami. Wybierz wejście, podaj poprawną cyfrę i patrz, jak wypełnia się przejście wstecz: błąd wyjścia grad_z2 = p − y, błąd warstwy ukrytej grad_z1 oraz macierze gradientów wag grad_W2 i grad_W1. Naciśnij Apply update, a strata spadnie — ten sam krok W -= lr * grad_W, tylko uwidoczniony.
Mini-batche i epoki
W poprzednim artykule wprowadziliśmy stochastyczny spadek gradientu (SGD): zamiast przechodzić przez wszystkie punkty danych, zbierać gradienty dla każdego i uśredniać je w jedną aktualizację, dzielimy dane na małe mini-batche i aktualizujemy wagi po każdym batchu. Rozmiar batcha to po prostu liczba przykładów, po których uśredniasz przed wykonaniem aktualizacji wag — ten sam wzór na gradient, to samo uśrednianie, tylko inna liczba przykładów.
Jak widzieliśmy w poprzednim artykule, gdzie mieliśmy 2 punkty danych na batch z 5 łącznie, wprowadza to pewien szum — gradient policzony z 2 przykładów nie wskaże dokładnie tego samego kierunku co gradient ze wszystkich 5 — ale znacznie częstsze aktualizacje z nawiązką to rekompensują.
Zobaczmy, jak wypada to przy naszych 60 000 obrazów treningowych.
Bez mini-batchy (pełnobatchowy spadek gradientu) jedno przejście przez dane wygląda tak:
- Przejście w przód wszystkich 60 000 obrazów przez sieć
- Policzenie straty uśrednionej po wszystkich 60 000 predykcjach
- Propagacja wsteczna, żeby dostać gradient (uśredniony po wszystkich obrazach)
- Jedna aktualizacja wag
To 1 aktualizacja wag po obejrzeniu każdego obrazu. Gradient jest bardzo dokładny (uwzględnia cały zbiór), ale model nie uczy się niczego, dopóki nie przetworzy wszystkich 60 000 obrazów.
Z mini-batchami rozmiaru 32 to samo przejście wygląda zupełnie inaczej:
- Weź obrazy 1–32, przejście w przód, policz stratę, propagacja wsteczna, aktualizuj wagi
- Weź obrazy 33–64, przejście w przód, policz stratę, propagacja wsteczna, aktualizuj wagi
- Weź obrazy 65–96, przejście w przód, policz stratę, propagacja wsteczna, aktualizuj wagi
- … powtórz dla wszystkich mini-batchy
To 1 875 aktualizacji wag w tym samym przejściu przez dane.
Każdy gradient jest bardziej zaszumiony, bo opiera się na 32 obrazach zamiast 60 000, ale model aktualizuje wagi 1 875 razy zamiast raz. Uczy się więc już w trakcie przechodzenia przez dane. Skrajny przypadek to rozmiar batcha równy 1: aktualizacja po każdym obrazie, czyli 60 000 aktualizacji na epokę, ale z gradientem opartym tylko na jednym przykładzie.
Po przetworzeniu wszystkich 1 875 mini-batchy model widział każdy obraz treningowy dokładnie raz. Takie pełne przejście przez zbiór nazywa się epoką. Zwykle trenujemy przez wiele epok, a każda daje modelowi kolejną okazję do dostosowania wag.
Liczba batchy na epokę wynika z rozmiaru zbioru i rozmiaru batcha:
Na początku każdej epoki tasujemy dane, żeby mini-batche były za każdym razem inne — to powstrzymuje model przed uczeniem się wzorców w kolejności zamiast w samych obrazach.
Możesz się zastanawiać, jak dobrać właściwą liczbę epok. Zależy to od tego, kiedy model przestaje poprawiać się na niewidzianych danych. Za mało epok i model nie nauczył się dość; za dużo i zaczyna zapamiętywać dane treningowe zamiast generalizować. W praktyce ustawia się wysoką maksymalną liczbę epok i pozwala wczesnemu zatrzymaniu zdecydować, kiedy naprawdę przerwać — monitoruje ono trafność walidacyjną i zatrzymuje trening, gdy ta się wypłaszcza.
Jeśli puścimy trening na 5 epok, zobaczymy:
Oznacza to, że wykonujemy 9 375 kroków spadku gradientu — za każdym razem przetwarzając batch 32 obrazów, licząc uśredniony gradient i aktualizując wagi sieci.
Budowanie modelu
Zbudujmy model, który bierze 784 wejścia (piksele) i wypuszcza 10 prawdopodobieństw klas (po jednym na cyfrę). Użyjemy tej samej struktury HiddenLayer co w poprzednim artykule — macierzy wag , wektora biasów i funkcji aktywacji:
W poprzednim artykule nasz model był pojedynczym równaniem liniowym — zaledwie 2 parametry, żadnych warstw, żadnych funkcji aktywacji. Liczyliśmy gradient wprost, bez potrzeby przekazywania czegokolwiek wstecz, bo za nim nic nie było. Teraz, przy wielu warstwach, każda warstwa musi policzyć własne gradienty i przekazać sygnał gradientu warstwie przed sobą — to właśnie przejście wstecz.
Matematyka reguły łańcuchowej jest ta sama, którą wyprowadziliśmy wyżej, tylko opakowana w klasę:
class HiddenLayer:
    def __init__(self, n_inputs, n_neurons):
        # We use initialization proposed by Kaiming He et al. (2015):
        # random weights scaled by sqrt(2/n) — keeps activations balanced
        # for ReLU networks (too large → explode, too small → vanish)
        self.W = np.random.randn(n_neurons, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_neurons)

    def forward(self, x):
        self.x = x                          # save for backward pass
        self.z = self.W @ x + self.b        # weighted sum
        self.out = np.maximum(0, self.z)    # ReLU activation
        return self.out

    def backward(self, grad_output):
        # ReLU derivative: 1 if z > 0, else 0
        grad_z = grad_output * (self.z > 0)

        # Gradients for this layer's parameters (chain rule)
        self.grad_W = np.outer(grad_z, self.x)   # ∂loss/∂W = grad_z ⊗ x
        self.grad_b = grad_z                      # ∂loss/∂b = grad_z

        # Gradient to pass to the previous layer (chain rule continues)
        return self.W.T @ grad_z                  # ∂loss/∂x = Wᵀ · grad_z

    def update(self, lr):
        # Gradient descent: update parameters
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
Warstwa ma trzy metody:
forward: policz , zastosuj ReLUbackward: odbierz gradient z następnej warstwy, policz gradienty lokalne regułą łańcuchową i zwróć gradient do przekazania poprzedniej warstwieupdate: zastosuj spadek gradientu — odejmijlr × gradientod każdego parametru
Oddzielamy backward od update, żeby móc kumulować gradienty przez cały mini-batch przed aktualizacją — dokładnie jak robi to Keras.
grad_input na końcu to sygnał gradientu przekazywany wstecz do poprzedniej warstwy — tak reguła łańcuchowa „płynie” przez sieć, dokładnie jak na diagramie z poprzedniego artykułu:
Forward:   x ──▶ Layer 1 ──▶ Layer 2 ──▶ Output ──▶ Loss
Backward:  x ◀── Layer 1 ◀── Layer 2 ◀── Output ◀── ∂L
Każda warstwa odbiera gradient z prawej, liczy własne gradienty parametrów (żeby zaktualizować i ) i przekazuje pozostały gradient w lewo.
Teraz stwórzmy jeszcze warstwę wyjściową, która używa softmaxu zamiast ReLU (bo ostatnia warstwa musi produkować prawdopodobieństwa, a nie aktywacje ReLU):
class OutputLayer:
    def __init__(self, n_inputs, n_classes):
        self.W = np.random.randn(n_classes, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_classes)

    def forward(self, x):
        self.x = x
        self.z = self.W @ x + self.b
        # Softmax instead of ReLU
        exp = np.exp(self.z - np.max(self.z))
        self.probs = exp / np.sum(exp)
        return self.probs

    def backward(self, label):
        # Combined softmax + cross-entropy gradient: p - y
        grad_z = self.probs.copy()
        grad_z[label] -= 1

        # Same gradient formulas as Layer
        self.grad_W = np.outer(grad_z, self.x)
        self.grad_b = grad_z
        return self.W.T @ grad_z

    def update(self, lr):
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
Teraz możemy złożyć sieć. Zacznijmy od prostej architektury — jedna warstwa ukryta ze 128 neuronami:
# 784 inputs → 128 hidden neurons → 10 output classes
layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)
Ale dlaczego 128? Czemu nie 1 albo 10?
Każdy neuron ukryty jest detektorem cechy. Patrzy na wszystkie 784 piksele przez własny wektor wag i wypuszcza jedną liczbę — „jak mocno mój wzorzec ujawnia się w tym obrazie?”. Jeden neuron może wystroić się na poziomą kreskę u góry (przydatne do odróżnienia 5 od 7), inny na zamkniętą pętlę w dolnej połowie (6, 8, 9), jeszcze inny na przekątną w prawym górnym rogu. Warstwa wyjściowa waży potem wszystkie te 128 sygnałów, żeby zdecydować, która cyfra jest najbardziej prawdopodobna.
Każdy neuron wyjściowy oblicza iloczyn skalarny output.W[digit] @ hidden, a następnie dodaje bias. Jego wektor wag określa, które aktywacje warstwy ukrytej zwiększają lub zmniejszają wynik danej cyfry. Na iloczyn skalarny wpływają zarówno wzajemny kierunek wektorów, jak i ich długości. Wygrywa klasa z najwyższym wynikiem.
Przy jednym neuronie ukrytym każdy obraz zostałby sprowadzony do jednej liczby przed przekazaniem go do warstwy wyjściowej. To niewiele miejsca na reprezentację kresek i kształtów potrzebnych do rozróżniania odręcznych cyfr. Więcej neuronów ukrytych pozwala sieci nauczyć się szerszego zestawu cech.
Zaczniemy od 128 neuronów ukrytych. W tym przykładzie daje to około 97% trafności walidacyjnej po pięciu epokach. Mniejsza warstwa ma mniej parametrów; większa może reprezentować więcej zależności, ale wymaga więcej obliczeń. Różne szerokości warstwy porównamy w następnym artykule.
To parametrów w pierwszej warstwie i w warstwie wyjściowej — łącznie 101 770 parametrów. W porównaniu z 2 parametrami ( i ) w przykładzie dopasowania prostej z poprzedniego artykułu to 50 000 razy więcej. A jednak algorytm treningowy jest identyczny.
Ta sama sieć w Kerasie
Keras nazywa swoje warstwy Dense — skrót od „densely connected” („gęsto połączona”, czyli „w pełni połączona”), co znaczy, że każde wejście łączy się z każdym neuronem. Warstwa Dense wykonuje dokładnie to samo obliczenie co nasze klasy NumPy powyżej: — pomnóż wejścia przez wagi, dodaj bias, zastosuj funkcję aktywacji. Różnica polega na tym, że Keras sam załatwia inicjalizację wag, przejście w przód, liczenie gradientów i aktualizację parametrów.
Nasz HiddenLayer(784, 128) z ReLU staje się Dense(128, activation="relu"), a OutputLayer(128, 10) z softmaxem staje się Dense(10, activation="softmax"). Zauważ, że w Kerasie podajesz tylko liczbę wyjść — model potrzebuje keras.Input(shape=(784,)) na górze, żeby znać rozmiar wejścia, ale potem Keras sam wywnioskuje wejście każdej warstwy z wyjścia poprzedniej. Więc Dense(10) wie, że ma 128 wejść, bo warstwa przed nim wypuszcza 128.
Warstwa Dense, w pełni połączona, FFNN, MLP — jaka jest różnica?
Te terminy bywają używane zamiennie, ale opisują różne rzeczy:
- Warstwa Dense / w pełni połączona — okablowanie jednej warstwy: każde wejście łączy się z każdym neuronem, operacja , którą budujemy. To klocek.
- MLP (perceptron wielowarstwowy) — cała sieć złożona z ułożonych warstw gęstych z nieliniowościami między nimi. Model, który właśnie zbudowaliśmy, jest MLP: 784 → 128 (ReLU) → 10 (softmax).
- FFNN (sieć neuronowa jednokierunkowa) — opisuje topologię: dane płyną w jedną stronę, wejście → wyjście, bez pętli i bez pamięci poprzednich wejść. Nasza sieć też jest jednokierunkowa.
Dla sieci takiej jak nasza pasują więc wszystkie trzy etykiety — to w pełni połączony MLP i jest jednokierunkowa. Jedna subtelność: „jednokierunkowa” jest szersza niż „gęsta”. Konwolucyjna sieć neuronowa (CNN) też jest jednokierunkowa (bez pętli), ale jej warstwy są konwolucyjne, nie gęste — więc nie każda FFNN jest zbudowana z warstw gęstych. A rekurencyjna sieć neuronowa (RNN) nie jest jednokierunkowa, bo zawraca własne wyjście na wejście, by nieść pamięć przez sekwencję. Ten kontrast — jednokierunkowa vs rekurencyjna — tłumaczy, dlaczego te nazwy pojawiają się jako odrębne architektury, gdy porównuje się modele do zadań takich jak język, gdzie kolejność słów ma znaczenie.
Sequential układa je w model, w którym wyjście każdej warstwy zasila następną:
model = keras.Sequential([
    # 784 inputs (28×28 image pixels)
    keras.Input(shape=(784,)),
    # 128 neurons/outputs, ReLU activation
    keras.layers.Dense(128, activation="relu"),
    # 10 neurons/outputs (one per digit), softmax activation
    keras.layers.Dense(10, activation="softmax"),
])

model.summary()
# Total params: 101,770 — same number we counted by hand
Budowanie pętli treningowej
Pętla treningowa to ten sam 4-krokowy proces z poprzedniego artykułu — przejście w przód, strata, propagacja wsteczna, spadek gradientu. Dla każdego mini-batcha uruchamiamy przejście w przód i propagację wsteczną na każdym obrazie, żeby skumulować gradienty, potem je uśredniamy i raz aktualizujemy wagi. Odpowiada to temu, co Keras robi wewnętrznie:
def train(layers, output_layer, X_train, y_train, X_val, y_val,
          epochs=5, lr=0.1, batch_size=32):
    n = X_train.shape[0]
    history = {"train_loss": [], "train_acc": [], "val_acc": []}

    for epoch in range(epochs):
        # Shuffle training data at the start of each epoch
        indices = np.random.permutation(n)
        X_shuffled = X_train[indices]
        y_shuffled = y_train[indices]

        epoch_loss = 0.0
        correct = 0

        all_layers = layers + [output_layer]

        for i in range(0, n, batch_size):
            X_batch = X_shuffled[i:i+batch_size]
            y_batch = y_shuffled[i:i+batch_size]
            bs = len(X_batch)

            # Accumulate gradients over the mini-batch
            accumulated = {id(l): (np.zeros_like(l.W), np.zeros_like(l.b))
                           for l in all_layers}

            for x, label in zip(X_batch, y_batch):
                # 1. Forward pass
                h = x
                for layer in layers:
                    h = layer.forward(h)
                probs = output_layer.forward(h)

                # 2. Loss computation
                loss = -np.log(probs[label] + 1e-10)
                epoch_loss += loss
                correct += (np.argmax(probs) == label)

                # 3. Backpropagation (compute gradients, don't update yet)
                grad = output_layer.backward(label)
                for layer in reversed(layers):
                    grad = layer.backward(grad)

                # Accumulate gradients
                for l in all_layers:
                    accumulated[id(l)][0][:] += l.grad_W
                    accumulated[id(l)][1][:] += l.grad_b

            # 4. Gradient descent: average gradients and update
            for l in all_layers:
                l.grad_W = accumulated[id(l)][0] / bs
                l.grad_b = accumulated[id(l)][1] / bs
                l.update(lr)

        # Track metrics
        train_loss = epoch_loss / n
        train_acc = correct / n
        val_acc = evaluate(layers, output_layer, X_val, y_val)
        history["train_loss"].append(train_loss)
        history["train_acc"].append(train_acc)
        history["val_acc"].append(val_acc)

        print(f"Epoch {epoch+1}/{epochs} — loss: {train_loss:.4f}, "
              f"train acc: {train_acc:.2%}, val acc: {val_acc:.2%}")

    return history


def evaluate(layers, output_layer, X, y):
    correct = 0
    for x, label in zip(X, y):
        h = x
        for layer in layers:
            h = layer.forward(h)
        probs = output_layer.forward(h)
        correct += (np.argmax(probs) == label)
    return correct / len(y)
To ta sama pętla SGD co w poprzednim artykule: tasujemy dane, dzielimy je na mini-batche, obliczamy i uśredniamy gradienty w każdym batchu, a następnie raz aktualizujemy wagi. Zamiast 5 punktów danych i 2 parametrów mamy teraz 60 000 obrazów i 101 770 parametrów.
W Kerasie konfigurujemy trening przez compile, a uruchamiamy go przez fit:
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),  # gradient descent with lr=0.1
    loss="sparse_categorical_crossentropy",              # cross-entropy loss
    metrics=["accuracy"],
)

history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # hold out 20% of training data for validation
)
compile ustawia funkcję straty i optymalizator, a fit uruchamia pełną pętlę — przejście w przód, stratę, propagację wsteczną i spadek gradientu dla każdego mini-batcha w każdej epoce.
Rozłóżmy argumenty:
"sparse_categorical_crossentropy"— to ta entropia krzyżowa, którą wyprowadziliśmy wyżej. Nazwa ma trzy części: „sparse” znaczy, że podajemy etykiety jako liczby całkowite (np.3), a nie wektory one-hot ([0,0,0,1,0,0,0,0,0,0]); „categorical” znaczy, że klasyfikujemy do wielu kategorii; „crossentropy” to funkcja straty . Keras ma też"categorical_crossentropy"(bez „sparse”) na wypadek, gdy etykiety są już zakodowane one-hot — matematyka jest ta sama, tylko format wejścia inny.SGD(learning_rate=0.1)— stochastyczny spadek gradientu, ta sama reguła aktualizacjiw = w - lr * dwz poprzedniego artykułu. Keras oferuje bardziej zaawansowane optymalizatory (Adam, RMSprop itd.), które automatycznie dostosowują współczynnik uczenia, ale zwykły SGD to to, czego używaliśmy, i tutaj sprawdza się dobrze.validation_split=0.2— odkłada 20% danych treningowych (12 000 obrazów) jako zbiór walidacyjny. Po każdej epoce Keras ocenia model na tych odłożonych obrazach (tylko przejście w przód, bez aktualizacji wag), żebyśmy mogli śledzić, jak dobrze generalizuje. Pozostałe 48 000 obrazów służy do właściwego treningu.
Przygotowanie danych
Zanim zaczniemy trenować sieć, musimy przygotować surowe dane pikselowe — sieć nie umie pracować bezpośrednio z siatkami liczb całkowitych 28×28. Zrobimy dwie rzeczy:
- Spłaszczenie — przekształcenie siatki 28×28 w pojedynczy wektor 784 liczb
- Normalizacja — przeskalowanie wartości pikseli z do
Spłaszczenie przekształca obraz 28×28 w wektor 784 wejść oczekiwanych przez nasz model. Każdy neuron pierwszej warstwy gęstej łączy się ze wszystkimi 784 wejściami. Sieć konwolucyjna może korzystać z przestrzennego układu pikseli, ale nasza sieć traktuje je jako płaską listę.
flatImage = image.reshape(784) # [0, 0, 0, ..., 156, 252, 128, ..., 0, 0] — 784 valuesNormalizacja pomaga utrzymać wartości wejściowe w tej samej skali co wagi. Wagi są zwykle inicjalizowane małymi losowymi liczbami wokół 0, więc jeśli wejścia sięgają 255, sumy ważone robią się ogromne, co prowadzi do wielkich aktywacji, wielkich gradientów i niestabilnego treningu. Dzielenie przez 255 wrzuca wszystko do — zakresu, w którym małe losowe wagi od początku dają sensowne wyjścia. To standardowa praktyka w uczeniu maszynowym, nie specyfika MNIST.
Duże wartości wejściowe mogą doprowadzić sigmoidę do nasycenia, w którym jej pochodna zbliża się do zera i przyczynia do zanikania gradientu. ReLU nie nasyca się po stronie dodatniej, ale duże gradienty mogą wywołać aktualizacje wag, po których neurony pozostaną nieaktywne. Omówimy to w artykule o umierającym ReLU.
Normalizacja przeskalowuje wartości pikseli z do :
# Normalize pixel values from [0, 255] to [0, 1]
normalizedImage = flatImage / 255.0  # [0.0, 0.0, 0.0, ..., 0.61, 0.99, 0.50, ..., 0.0, 0.0]
Zbiór treningowy, walidacyjny i testowy
Zanim uruchomimy trening, jest ważne rozróżnienie do zrozumienia. Mamy 60 000 obrazów treningowych i 10 000 testowych — ale tak naprawdę potrzebujemy trzech zbiorów, nie dwóch:
- Zbiór treningowy — dane, z których model się uczy. W każdej epoce przetwarza wszystkie obrazy z tego zbioru, oblicza gradienty i aktualizuje wagi.
- Zbiór walidacyjny — po każdej epoce model oblicza na nim stratę i trafność, wykonując tylko przejście w przód, bez aktualizacji wag. Pomaga to ocenić, jak dobrze model generalizuje: wynik 98% na danych treningowych i 90% na walidacyjnych sugeruje przeuczenie. Kolejnym sygnałem jest zatrzymanie wzrostu trafności walidacyjnej przy dalszej poprawie trafności treningowej.
- Zbiór testowy — osobny zbiór, oceniany raz, na końcu, po podjęciu wszystkich decyzji dotyczących treningu. Pozwala oszacować, jak dobrze model radzi sobie z niewidzianymi obrazami pochodzącymi z tego samego rozkładu danych.
W kategoriach naszej 4-krokowej pętli treningowej:
| Zbiór treningowy | Zbiór walidacyjny | Zbiór testowy | |
|---|---|---|---|
| 1. Przejście w przód | tak | tak | tak |
| 2. Policzenie straty | tak | tak (tylko do raportowania) | tak (tylko do raportowania) |
| 3. Propagacja wsteczna | tak | nie | nie |
| 4. Aktualizacja wag | tak | nie | nie |
Dla obrazów treningowych wykonują się wszystkie 4 kroki — model się uczy. Dla walidacyjnych i testowych działają tylko kroki 1 i 2 — model mierzy, jak mu idzie, ale nie zmienia wag na podstawie tego, co widzi.
Czemu nie użyć zbioru testowego do jednego i drugiego? Bo za każdym razem, gdy sprawdzasz wynik na jakimś zbiorze i podejmujesz na tej podstawie decyzję (np. „czy trenować dalej?”), subtelnie dopasowujesz się do tych danych. Jeśli użyjesz zbioru testowego do decyzji, kiedy przerwać trening, trafność testowa stanie się optymistycznie obciążona. Zbiór walidacyjny przejmuje to obciążenie na siebie, dzięki czemu testowy pozostaje uczciwy.
Zbiór walidacyjny służy też do strojenia hiperparametrów — wyborów takich jak współczynnik uczenia, rozmiar batcha, liczba warstw i liczba epok. Próbujesz różnych ustawień, porównujesz trafność walidacyjną i wybierasz najlepsze. Zbiór testowy pozostaje przez cały ten proces zapieczętowany, żeby mógł dać nieobciążoną końcową ocenę.
W praktyce zbiór walidacyjny możesz utworzyć, odcinając kawałek danych treningowych. Keras ułatwia to przez validation_split:
history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # use 20% of training data as validation
)
Możesz też podzielić ręcznie i przekazać osobny zbiór przez validation_data=(X_val, y_val). Użyjemy validation_split=0.2 — Keras odłoży 20% danych treningowych (12 000 obrazów) na walidację, trenując na pozostałych 48 000. Te 10 000 obrazów testowych pozostaje całkowicie osobno do końcowej oceny.
Trenowanie modelu
Wczytajmy i przygotujmy dane za pomocą wbudowanej w Kerasa funkcji ładowania MNIST:
import keras
import numpy as np

(train_images, train_labels), (test_images, test_labels) = keras.datasets.mnist.load_data()

# Flatten 28×28 → 784 and normalize to [0, 1]
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0
X_test = test_images.reshape(-1, 784).astype("float32") / 255.0
y_train = train_labels
y_test = test_labels

print(f"Training: {X_train.shape[0]} images, {X_train.shape[1]} pixels each")
print(f"Test:     {X_test.shape[0]} images")
# Training: 60000 images, 784 pixels each
# Test:     10000 images
Mamy teraz 60 000 obrazów treningowych (każdy to wektor 784 wartości między 0 a 1) i ich etykiety (każda 0–9). Zbiór testowy jest osobno — użyjemy go tylko do sprawdzenia, jak dobrze model generalizuje na cyfry, których nigdy nie widział podczas treningu.
Wytrenujmy naszą sieć:
# Split: 80% train, 20% validation
n_val = int(0.2 * len(X_train))
X_val, y_val = X_train[:n_val], y_train[:n_val]
X_train_sub, y_train_sub = X_train[n_val:], y_train[n_val:]

layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)

history = train([layer1], output, X_train_sub, y_train_sub, X_val, y_val,
                epochs=5, lr=0.1, batch_size=32)

# Epoch 1/5 — loss: 0.3260, train acc: 90.70%, val acc: 94.58%
# Epoch 2/5 — loss: 0.1608, train acc: 95.30%, val acc: 95.97%
# Epoch 3/5 — loss: 0.1147, train acc: 96.64%, val acc: 96.49%
# Epoch 4/5 — loss: 0.0898, train acc: 97.45%, val acc: 96.94%
# Epoch 5/5 — loss: 0.0737, train acc: 97.87%, val acc: 97.27%
Oto jak wygląda trening przez 5 epok — lewy wykres pokazuje spadającą stratę w miarę uczenia się modelu, prawy pokazuje rosnącą trafność. Zielone kropki to trafność walidacyjna (val_accuracy), mierzona na koniec każdej epoki na odłożonych obrazach, na których model nigdy nie trenuje:
Po pięciu epokach sieć poprawnie klasyfikuje około 97% obrazów ze zbioru walidacyjnego.
Już pierwsza epoka daje około 90% trafności treningowej. To średnia z predykcji wykonywanych w trakcie uczenia przez całą epokę, obejmującą 1 500 batchy i aktualizacji wag. Trafność walidacyjną mierzymy osobno na końcu epoki, korzystając z już zaktualizowanego modelu.
Spójrz na odstęp między niebieską linią treningową a zieloną linią walidacyjną, zwłaszcza na wykresie straty. Strata treningowa nadal maleje, ale walidacyjna przestaje się poprawiać około epoki 4–5, a nawet zaczyna rosnąć. To oznaka przeuczenia: dalsze dopasowywanie do danych treningowych przestaje poprawiać wyniki na nowych obrazach. Przy dłuższym treningu różnica może się powiększać — trafność treningowa może nadal rosnąć, gdy walidacyjna stoi w miejscu lub spada. Zbiór walidacyjny pomaga więc zdecydować, kiedy zakończyć trening. Przeuczenie omówimy dokładniej w następnym artykule.
Wypróbuj sam
Mamy towarzyszący notatnik, w którym możesz uruchomić implementacje w Kerasie i NumPy obok siebie. Wszystkie komórki wykonują się automatycznie — zobaczysz najpierw wynik treningu w Kerasie, potem wynik treningu w NumPy z tymi samymi metrykami.
Wyjście Kerasa wygląda tak:
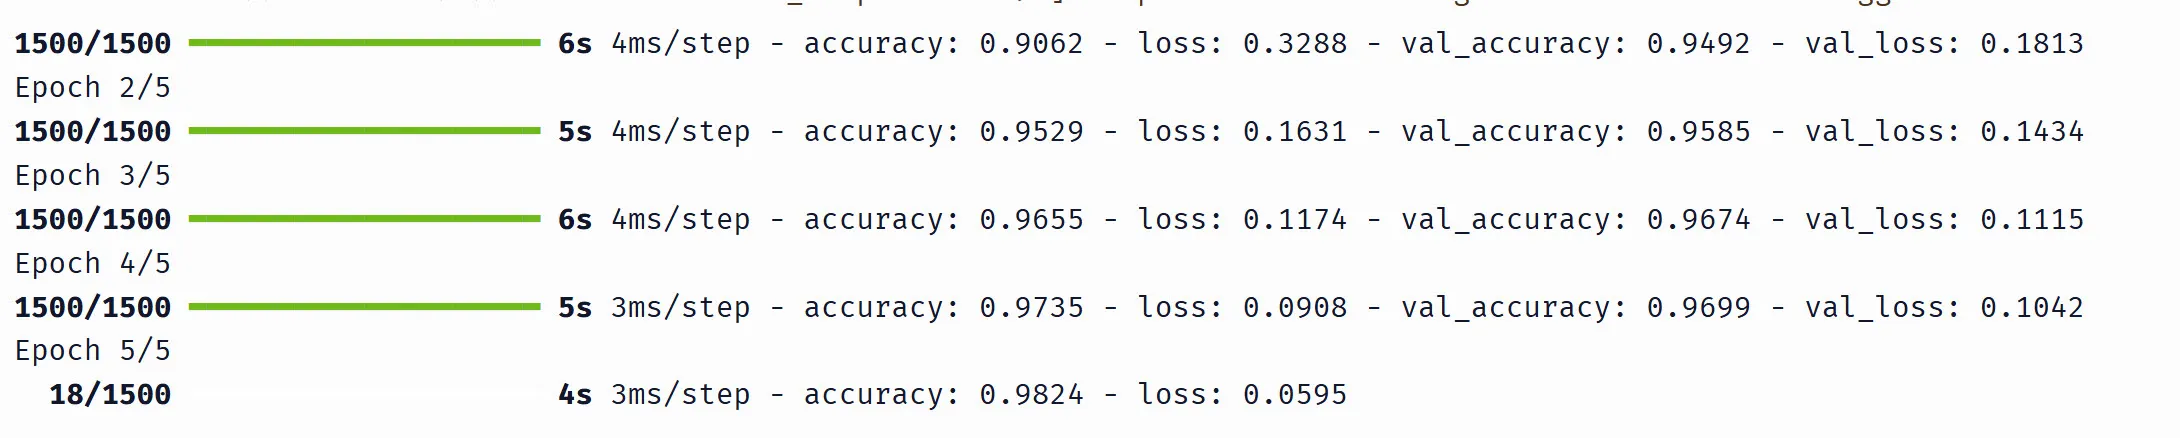
Oto co znaczy każdy element:
1500/1500— ukończono 1 500 mini-batchy z 1 500 łącznie (48 000 obrazów treningowych / 32 na batch). W trakcie treningu zobaczysz, jak ten licznik rośnie (np.18/1500znaczy, że zrobiono 18 batchy).5s 4ms/step— epoka zajęła 5 sekund, ~4 milisekundy na batchaccuracy: 0.9529iloss: 0.1631— metryki treningowe, uśrednione po wszystkich batchach w epoceval_accuracy: 0.9585ival_loss: 0.1434— metryki walidacyjne, policzone raz na koniec epoki na odłożonych 12 000 obrazów
Wyniki Kerasa i NumPy nie będą identyczne ze względu na różnice w losowej inicjalizacji wag, ale powinny być zbliżone: około 97% trafności walidacyjnej po pięciu epokach. Podobne wyniki są zgodne z tym, że obie implementacje używają tego samego algorytmu treningowego.
Co omówiliśmy
Wzięliśmy każde pojęcie z poprzedniego artykułu i zastosowaliśmy je do prawdziwego problemu — klasyfikacji odręcznych cyfr przy ponad 100 000 parametrów zamiast dopasowywania prostej przy dwóch:
- Klasyfikacja vs regresja: softmax zamienia surowe logity w prawdopodobieństwa, entropia krzyżowa mierzy, jak bardzo te prawdopodobieństwa są chybione
- Przejście w przód: wejście płynie przez warstwy, każda liczy — ten sam wzór, teraz w postaci macierzowej
- Propagacja wsteczna: gradient softmaxu + entropii krzyżowej upraszcza się do , a reguła łańcuchowa płynie wstecz przez warstwy dokładnie tak, jak wyprowadziliśmy ręcznie
- Pętla treningowa: przetasuj, podziel na mini-batche, przejście w przód → strata → propagacja wsteczna → aktualizacja — powtarzane dla każdego batcha w każdej epoce
Algorytm jest identyczny z tym, który zbudowaliśmy w poprzednim artykule. Keras go automatyzuje, ale pod maską to to samo obliczenie, które nasz kod NumPy wykonuje krok po kroku.
Przez cały czas używaliśmy stałych ustawień: jednej warstwy ukrytej ze 128 neuronami, współczynnika uczenia 0.1 i rozmiaru batcha 32. Co się stanie, jeśli je zmienimy? W następnym artykule porównamy różne współczynniki uczenia, rozmiary batcha, głębokości sieci i funkcje aktywacji. Omówimy też przeuczenie, wczesne zatrzymanie i diagnozowanie problemów z treningiem.