Обучаем настоящую сеть на MNIST
В предыдущей статье мы разобрали основные этапы и понятия, связанные с обучением нейросети: прямой проход, функции потерь, обратное распространение, градиентный спуск, скорость обучения, мини-батчи и затухающие градиенты. Для объяснения мы использовали простой пример подгонки прямой с 2 параметрами: по входу предсказать . Это была регрессия: сеть выдаёт одно число из непрерывного диапазона, например цену или температуру. Ошибку предсказания мы измеряли среднеквадратичной ошибкой — функцией потерь, выбранной для той задачи.
Здесь мы займёмся классификацией. Получив изображение рукописной цифры, сеть присвоит вероятность каждой категории и выберет цифру с наибольшей вероятностью. Мы возьмём классический датасет MNIST — 70 000 изображений рукописных цифр от 0 до 9.
Сначала мы построим всё с нуля на NumPy: самостоятельно напишем прямой проход, функцию потерь, обратное распространение и градиентный спуск, чтобы проследить каждый шаг обучения. Затем покажем то же самое на Keras — высокоуровневом фреймворке, который выполняет эти операции автоматически. Keras может работать поверх PyTorch, TensorFlow или JAX. Эти бэкенды отвечают за ускорение на GPU и автоматическое вычисление градиентов, а Keras предоставляет удобный интерфейс. Наша реализация на NumPy обрабатывает по одному изображению, чтобы было проще следить за вычислениями. Keras может эффективно обрабатывать целые батчи и использовать GPU для более крупных задач.
Датасет
MNIST — это набор из 70 000 рукописных цифр (0–9): 60 000 для обучения и 10 000 для тестирования. Каждое изображение имеет размер 28×28 пикселей в градациях серого.
Вот несколько примеров:
Изображения и метки хранятся как массивы NumPy. Посмотрим на сырые данные.
# 60,000 images, each a matrix of 28×28 pixels
>>> train_images.shape
(60000, 28, 28)

# A single image: 28 rows × 28 columns of pixel values (0–255)
>>> train_images[0].shape
(28, 28)

>>> train_images[0].dtype
dtype('uint8')

# 60,000 labels: first image is "5", second is "0", ...
>>> train_labels
array([5, 0, 4, ..., 5, 6, 8], dtype=uint8)

# 10,000 test images, same 28×28 matrices
>>> test_images.shape
(10000, 28, 28)

# 10,000 labels for test images
>>> test_labels
array([7, 2, 1, ..., 4, 5, 6], dtype=uint8)
Каждое значение в сетке 28×28 — интенсивность пикселя. Каждый пиксель занимает один байт (8 бит), поэтому может принимать значений: от 0 до 255. В исходных данных 0 означает чёрный, а 255 — белый, поэтому цифры MNIST состоят из белых штрихов на чёрном фоне. Это распространённый формат хранения изображений в градациях серого. RGB-изображение с 8 битами на канал использует три значения на пиксель (красное, зелёное и синее); MNIST достаточно одного.
Эта сетка чисел 28×28 и есть изображение: каждое число напрямую отображается в оттенок серого. Кликните по любому пикселю ниже и введите новое значение, чтобы увидеть это в действии. Переключателем можно переходить между исходным представлением (белое на чёрном) и инвертированным видом (чёрное на белом, который читается легче):
При переключении вида значения пикселей в увеличенной сетке не меняются: они всегда показывают данные из массива. Переключатель меняет только способ отображения. Пиксель со значением 255 показывается белым в исходном режиме и чёрным в инвертированном. Именно эти 784 числа сеть получает на вход.
Каждое изображение снабжено меткой — цифрой, которую оно изображает (0–9). Вместе эти два массива, изображения и метки, — это всё, на чём сеть будет учиться. Задача проста: по изображению 28×28 предсказать, что за цифра на нём. Это задача классификации с 10 классами, а сеть, которую мы построим, называется многоклассовым классификатором. В классификации класс — это одна из возможных меток, одна категория, которую модель может выбрать. У нас 10 классов (цифры 0–9) примерно по 6000 обучающих примеров на цифру (не строго поровну: у цифры 1 их 6742, а у цифры 5 всего 5421).
От регрессии к классификации
При переходе от регрессионной задачи предыдущей статьи () к классификации цифр нам понадобится:
- Выходной слой — вместо одного нейрона, выдающего одно число, нам нужно 10 нейронов (по одному на цифру) и функция активации softmax, которая превратит их оценки в распределение вероятностей.
- Функция потерь — вместо среднеквадратичной ошибки, измеряющей отклонение от целевого значения, мы используем кросс-энтропию, которая зависит от вероятности правильного класса.
- Градиент — формула градиента должна соответствовать новой функции потерь. Сочетание кросс-энтропии и softmax даёт простую формулу.
- Активация скрытого слоя — между слоями нужна нелинейная функция активации, чтобы сеть могла учиться сложным закономерностям. Мы возьмём ReLU, ту же функцию, что и в примерах с нейроном и слоем в предыдущей статье.
Основной алгоритм — прямой проход, обратное распространение, градиентный спуск, мини-батчи — остаётся прежним. Разберём каждый кусочек.
Выходной слой и softmax
В регрессии сеть выдаёт одно число. В классификации ей нужно выбрать из набора категорий — в нашем случае одну из 10 цифр. Сеть должна сказать «я думаю, это 2» с какой-то степенью уверенности.
Мы решаем это, дав выходному слою 10 нейронов — по одному на цифру. Каждый нейрон выдаёт оценку, называемую логитом (название идёт от «log-odds» в логистической регрессии, но на практике это просто «сырая оценка до softmax»), которая показывает, насколько сильно сеть верит, что на входе именно эта цифра. Больше оценка — больше уверенность.
При 10 цифрах наш выходной слой выдаёт 10 логитов — по одному на класс. Чтобы примеры и визуализации были проще, в коде ниже мы возьмём всего 3 класса (цифры 0, 1, 2) — математика работает ровно так же, просто чисел меньше.
Для данного входного изображения выход может выглядеть так:
Изображение заходит внутрь, сеть прогоняет его через свои слои, и наружу выходят 3 числа — по одному на цифру. Цифра 2 получила самую высокую оценку (4.2), так что это и есть предсказание сети. В коде:
logits = [1.5, -0.3, 4.2]
#          0     1    2

# The network's guess: digit 2 (highest logit = 4.2)
# argmax returns the index of the largest value, not the value itself
prediction = np.argmax(logits)  # 2
Сырые логиты — не вероятности: они могут быть положительными или отрицательными и не обязаны давать в сумме 1. Чтобы преобразовать их в распределение вероятностей, мы используем softmax. Эта функция применяется в классификаторах изображений и языковых моделях, где превращает оценки токенов словаря в вероятности следующего токена:
Почему «softmax»? Потому что это более мягкая версия max. Жёсткий max просто выбрал бы наибольшее значение и проигнорировал всё остальное — [0, 0, 1]. Softmax делает почти то же самое, когда один логит доминирует, но когда логиты сопоставимо велики, остальные значения тоже получают заметный вес. Сравните:
| логиты | жёсткий max | softmax |
|---|---|---|
| [1.0, 8.5, 1.0] | [0, 1, 0] | [0.1%, 99.9%, 0.1%] |
| [3.0, 3.5, 3.0] | [0, 1, 0] | [27.4%, 45.2%, 27.4%] |
| [3.0, 3.0, 3.0] | не определён (ничья) | [33.3%, 33.3%, 33.3%] |
Жёсткий max даёт бинарный ответ — победитель забирает всё. Softmax даёт плавное распределение, непрерывно меняющееся при изменении входов. Когда модель не уверена (логиты близки), softmax это отражает. Когда модель уверена (один логит гораздо больше), softmax приближается к жёсткому max. Именно это плавное поведение и делает возможным обратное распространение: через softmax можно вычислять градиенты, потому что он дифференцируем всюду.
У жёсткого max нет полезного градиента: между скачками его выход постоянен. Softmax дифференцируем, поэтому через него можно распространять градиент. Математически конечные логиты дают вероятности строго между 0 и 1, хотя арифметика с плавающей точкой может округлить очень малые значения до 0. В виджете ниже попробуйте задать первым двум логитам 0, а третьему — большое число.
Softmax работает в три шага (на наших примерных логитах [1.5, -0.3, 4.2]):
- Возвести в степень каждого логита — поскольку при любом , это превращает каждое значение, даже отрицательное, в положительное число: , ,
- Сложить все положительные значения —
- Разделить каждое значение на эту сумму — , и так далее
Это нормирует список так, что он в сумме даёт ровно 1 — настоящее распределение вероятностей.
Softmax использует усиливающий эффект экспоненты. Разности логитов превращаются в отношения экспонент: , тогда как , а . Разница в 2.7 между логитами 4.2 и 1.5 даёт примерно 15-кратную разницу между их экспонентами. После деления на сумму цифра 2 получает 92.7% вероятности. Вероятность сосредотачивается на классе с наибольшей оценкой, хотя высокое значение не гарантирует правильного предсказания.
Этим эффектом усиления можно управлять с помощью параметра температуры . Формула становится такой:
Деление на перед возведением в степень масштабирует различия между логитами. Попробуйте потянуть ползунок T:
- T → 0 (низкая температура) — различия усиливаются, распределение становится острым. Наибольший логит получает почти 100%. Это приближается к жёсткому max.
- T = 1 — стандартный softmax. Деление на 1 ничего не меняет, так что это равносильно отсутствию .
- T → ∞ (высокая температура) — различия сглаживаются, все логиты становятся похожи, а распределение стремится к равномерному (по 33.3%).
Языковые модели тоже используют температуру при выборе следующего токена. Низкая температура сосредотачивает вероятность на наиболее вероятных токенах, делая результат более предсказуемым. Высокая распределяет вероятность равномернее, позволяя выбирать более разнообразные варианты, иногда в ущерб связности текста.
Вот как мы реализовали бы softmax на Python:
def softmax(logits):
    # Subtract max for numerical stability (doesn't change the result,
    # but prevents overflow when computing e^z for large values)
    exp = np.exp(logits - np.max(logits))
    return exp / np.sum(exp)

probs = softmax(logits)
# [0.063, 0.010, 0.927]
#   0      1      2
# The highest probability is 92.7% for digit 2
Обратите внимание: мы вычитаем наибольший логит. Softmax вычисляет , а экспонента растёт очень быстро. Если логит равен 1000, то выходит за диапазон чисел с плавающей точкой и даёт бесконечность:
>>> import numpy as np
>>> np.exp(1000)
inf                    # overflow — can't compute

>>> np.exp(1000) / (np.exp(1) + np.exp(2) + np.exp(1000))
nan                    # infinity / infinity = undefined
Вычитание максимального логита из всех значений перед возведением в степень сдвигает наибольшее значение в 0, а всё остальное делает отрицательным. Относительный порядок сохраняется — по-прежнему наибольшее, потому что всегда меньше 1, — так что вероятности получаются те же:
>>> logits = [1, 2, 1000]
>>> max(logits)
1000

>>> [z - max(logits) for z in logits]
[-999, -998, 0]        # largest becomes 0, others become negative

>>> np.exp([-999, -998, 0])
array([0., 0., 1.])    # e⁰ = 1 is the largest (e^negative is always < 1), no overflow
Вот как математически получается, что вероятности одинаковы с вычитанием и без него:
Множитель сокращается, зато мы избежали вычисления опасно больших экспонент. Это стандартный приём численной устойчивости, который вы встретите в любой реализации softmax.
ReLU: функция активации для скрытых слоёв
Одну функцию активации мы уже разобрали — softmax на выходном слое, превращающий логиты в вероятности. Но нам нужна функция активации и на скрытых слоях. Обученная модель из предыдущей статьи () была одной линейной операцией — ни функции активации, ни скрытых слоёв.
Там же объяснялось, почему складывать слои без функции активации бессмысленно: цепочка линейных операций схлопывается в одну линейную операцию. Чтобы учить сложные паттерны, а не только прямые линии, между слоями нужна нелинейность. Предыдущая статья представила функции активации как решение, показав несколько вариантов в виджете нейрона (sigmoid, перцептрон, ReLU).
Мы возьмём ReLU (Rectified Linear Unit) — распространённую функцию активации скрытых слоёв:
Она пропускает положительные значения без изменений и обрезает отрицательные в ноль. Потяните ползунки ниже: когда взвешенная сумма положительна (зелёное), значение проходит. Когда отрицательна (красное), выход обрезается в 0:
Поведение видно, если двигать оба ползунка: важна именно взвешенная сумма w × x, а не отдельные значения. Попробуйте задать и вход, и вес отрицательными: произведение положительно, так что ReLU его пропускает. Она обрезает в ноль только тогда, когда отрицательно само произведение.
У ReLU простая производная, что удобно при обратном распространении. Производная функции активации входит в произведение по цепному правилу при вычислении градиента потерь. В предыдущей статье градиент веса скрытого слоя выглядел так:
dw11 = x1 * relu_deriv(z1) * v1 * 2 * error
#            ↑ activation derivative — one factor in the chain
Градиент потерь — произведение локальных производных вдоль пути вычислений. relu_deriv — один из множителей: при значении 1 градиент проходит без изменений, а при 0 нейрон не получает градиента от этого входа. Нейрон, неактивный на всех обучающих входах, может совсем перестать учиться — это проблема умирающего ReLU. У сигмоиды другое ограничение: её производная не больше 0.25 и приближается к нулю, когда активация насыщается около 0 или 1. Эти малые множители могут накапливаться по слоям.
Почему сигмоида хуже ReLU с точки зрения градиентов?
Производная сигмоиды равна . Поскольку сигмоида выдаёт значение между 0 и 1, это , что максимально при (при ): . По мере удаления от нуля в любую сторону сигмоида насыщается к 0 или 1, а производная стягивается к 0.
Для пяти слоёв с сигмоидой произведение одних лишь производных активации не превышает . На полный градиент влияют и матрицы весов, но малые производные могут затруднять обучение ранних слоёв. Производная ReLU равна 1 для активных нейронов, поэтому на этапе активации они не уменьшают градиент.
Итак, в нашей сети две разные функции активации, играющие две разные роли: ReLU в скрытых слоях (вносит нелинейность, чтобы сеть могла учить сложные паттерны) и softmax на выходном слое (превращает сырые оценки в вероятности).
Функция потерь
Теперь нам нужна функция потерь. В предыдущей статье мы использовали среднеквадратичную ошибку — квадрат разности между предсказанием и целью, усреднённый по всем точкам данных. Для регрессии это имело смысл: предсказание было одним числом, цель — одним числом, и мы хотели, чтобы они были близки.
Для классификации мы используем кросс-энтропийные потери. Идея проста: взять отрицательный логарифм вероятности, которую модель присвоила правильному классу.
Чем ниже вероятность, тем выше потери:
- Модель говорит, что шанс верного ответа 95%: — низкие потери, хорошее предсказание
- Модель говорит 60%: — умеренные потери, недостаточная уверенность
- Модель говорит 1%: — очень высокие потери, почти полная ошибка
Почему мы используем отрицательный логарифм?
- При потери равны нулю: .
- Когда приближается к 0, потери неограниченно растут, штрафуя предсказания, которые отдают правильному классу очень малую вероятность.
- Производная равна , поэтому небольшое изменение вероятности гораздо сильнее влияет на потери около 0, чем около 1.
Графики ниже показывают и рядом. Обе кривые круты около 0. Минус отражает график относительно горизонтальной оси: мы получаем неотрицательные потери, которые уменьшаются при росте вероятности правильного класса.
Например, производная по равна при и примерно при . Это лишь один множитель в обратном распространении. Чтобы получить градиенты по логитам и весам, нужны также производные softmax и предыдущих слоёв. Их мы выведем ниже.
Двигайте ползунки ниже и следите за жёлтой точкой на кривой :
Правильный класс — цифра 2. Увеличьте её вероятность, и потери приблизятся к нулю; уменьшите — и потери резко вырастут.
На Python функция потерь выглядит так. Она принимает предсказанные моделью вероятности и истинную метку (индекс правильного класса — 0, 1 или 2) и возвращает вероятности, присвоенной этому классу:
def cross_entropy_loss(probs, label):
    # label is the index of the correct class
    p_correct = probs[label]       # e.g. probs[2] = 0.94
    return -np.log(p_correct)      # -log(0.94) = 0.062

# Model is confident and correct → low loss
cross_entropy_loss([0.05, 0.01, 0.94], label=2)   # 0.062

# Model is uncertain → moderate loss
cross_entropy_loss([0.30, 0.30, 0.40], label=2)    # 0.916

# Model is confident but wrong → high loss
cross_entropy_loss([0.80, 0.15, 0.05], label=2)    # 2.996
Потери и точность
Во время обучения мы отслеживаем и потери, и точность — они связаны, но это не одно и то же.
Точность — доля правильных предсказаний. Каждое предсказание либо верное, либо нет; степень уверенности на этот результат не влияет. Вероятность 0.51 для правильного класса даёт одно верное предсказание, как и 0.99. Но потери различаются: 0.67 в первом случае и 0.01 во втором.
Потери (кросс-энтропия) зависят от вероятности правильного класса — чем она меньше, тем выше штраф. Две модели могут иметь одинаковую точность, но разные потери, если одна присваивает правильным классам более высокие вероятности.
Вот как это выглядит в реальном логе обучения:
Epoch 1/10  — accuracy: 0.5117 — loss: 1.7934 — val_accuracy: 0.7520 — val_loss: 1.3155
Epoch 2/10  — accuracy: 0.7806 — loss: 1.0726 — val_accuracy: 0.8377 — val_loss: 0.8382
Epoch 5/10  — accuracy: 0.8627 — loss: 0.5560 — val_accuracy: 0.8798 — val_loss: 0.4901
На первой эпохе accuracy: 0.5117 означает, что модель предсказала правильную цифру для 51% обучающих изображений: для каждого изображения класс с наибольшей вероятностью сравнивается с истинной меткой, и считается доля верных предсказаний. Это уже заметно выше базовых 10% случайного угадывания среди 10 классов, но всё ещё ошибка на половине изображений.
Потери 1.79 указывают на то, что модель часто присваивает правильному классу низкую вероятность. Она может выбирать правильный класс с низкой уверенностью (например, 0.3 вместо 0.9) или отдавать большую вероятность неверному классу. Несколько таких уверенных ошибок могут непропорционально сильно увеличить средние потери.
Из-за разницы между точностью и потерями они не всегда движутся вместе:
- Потери падают, точность стоит — модель становится увереннее в предсказаниях, которые и так делала правильно. Например, если модель уже предсказывает «7» для изображения семёрки, но её уверенность растёт с 0.4 до 0.9, точность не меняется (она и так была верной), а потери заметно падают.
- Точность растёт, и потери тоже растут — модель даёт больше верных предсказаний, но становится самоуверенной на неверных. Представьте, что модель исправила 5 изображений, которые раньше путала (точность улучшилась), но одновременно стала очень уверенной (0.95) в неверных предсказаниях для 2 изображений. Потери от этих 2 уверенных ошибок могут перевесить выигрыш от 5 новых верных ответов.
- Обе стоят на месте — модель застряла. Веса меняются, но предсказания по сути не отличаются. Так часто бывает, когда скорость обучения слишком мала или модель исчерпала свою ёмкость.
На практике при нормальном обучении обе метрики обычно улучшаются вместе, как в логе выше. Если они расходятся, проверьте, не становится ли модель увереннее в ошибочных предсказаниях.
Градиент
В предыдущей статье мы видели, что обучение требует вычисления градиента потерь по каждому параметру — производной, говорящей, в какую сторону подтолкнуть каждый вес, чтобы уменьшить ошибку. Для примера с подгонкой прямой мы показали, как пришли к формуле градиента MSE. Теперь нам нужен градиент кросс-энтропийных потерь по логитам (сырым оценкам до softmax).
Вот как выглядит один нейрон выходного слоя: логит — это взвешенная сумма до применения функции активации:
У самого softmax нет обучаемых параметров: он только преобразует логиты в вероятности. Обучаемые веса принадлежат нейронам, которые вычисляют взвешенные суммы и выдают логиты. Градиент по логитам позволяет вычислить градиенты для выходных весов и скрытых слоёв. Затем оптимизатор использует их для обновления параметров.
Формула для MSE, к которой мы пришли в предыдущей статье, имела ясную структуру: dw = 2 * mean(error * x) — ошибка, умноженная на вход, усреднённая по примерам.
Каждая часть возникла из цепного правила, применённого к функции потерь. Теперь нужно проделать то же самое для кросс-энтропии в связке с softmax. Разберём это в три части:
- Градиент через softmax (выходной слой) — вывести градиент кросс-энтропии + softmax по логитам и прийти к чистой формуле
- Градиент через ReLU (скрытый слой) — показать, как градиент течёт через функцию активации скрытого слоя
- Собираем всё вместе — сцепить обе части в полный обратный проход
Полная прямая цепочка такова: входы → скрытый слой (веса + ReLU) → логиты → softmax → вероятности → кросс-энтропия → потери. Обратный проход идёт в обратную сторону: мы начинаем с потерь и применяем цепное правило назад через кросс-энтропию, softmax, а затем скрытые слои.
Математика ниже сложнее, чем градиент MSE из предыдущей статьи — чтобы пользоваться результатом, не обязательно следить за каждым шагом. Если хотите, можете сразу перейти к итоговой формуле и коду. Но если хочется увидеть, откуда она берётся, вот вывод по шагам.
Градиент через softmax (выходной слой)
Шаг 1: производная потерь. Потери равны , где — правильный класс. Производную мы уже знаем: это . Значит:
Шаг 2: производная softmax. Теперь у нас есть производная потерь по . Но нужна производная по логитам , потому что именно их и производят веса слоя (как показано на диаграмме выше). Чтобы навести мост, надо знать: как softmax превращает изменение в изменение ?
Softmax это . По правилу дифференцирования частного возникают два случая:
Если (подталкиваем логит собственного класса):
Это похоже на производную сигмоиды — так и есть. Каждый выход softmax локально ведёт себя как сигмоида.
Если (подталкиваем другой логит):
Первый член числителя равен 0, потому что не зависит от . Увеличение одного логита всегда уменьшает остальные вероятности — они обязаны в сумме давать 1.
Шаг 3: цепное правило. Перемножаем две производные:
- Для правильного класса ():
- Для неверного класса ():
Результат
Объединив производные, получаем градиент кросс-энтропии по каждому логиту :
Как это считать на практике? С помощью — вектора one-hot, из одних нулей с единицей на позиции правильного класса. Поскольку для правильного класса и для всех остальных, вычитание из даёт для правильного класса и для остальных — ровно кусочную формулу выше:
На Python это просто:
grad_z = probs - one_hot_label # gradient w.r.t. logitsГрадиент по логитам — разность вектора предсказанных вероятностей и целевого вектора one-hot.
Посмотрим, что это значит, на конкретном примере с 3 классами. Если модель выдаёт вероятности [0.06, 0.01, 0.93], а правильный класс — 2:
- Цель (one-hot) это
[0, 0, 1]— вся вероятность должна быть на классе 2 - Градиент равен
[0.06 − 0, 0.01 − 0, 0.93 − 1]=[0.06, 0.01, −0.07]
Знак говорит о направлении: класс 2 получает отрицательный градиент (−0.07), то есть «подними этот логит, чтобы увеличить его вероятность». Классы 0 и 1 получают положительные градиенты, то есть «опусти эти логиты». Величина говорит, насколько: классу 0 (0.06) нужна большая поправка, чем классу 1 (0.01), потому что к нему утекло больше вероятности.
Заметьте, что — это градиент по логитам, а не по весам. Помните, выходной нейрон вычисляет (логит), а затем softmax превращает его в вероятность. Так что полная цепочка от потерь к весам состоит из двух частей:
Первая часть () — это то, что мы только что вывели: как потери меняются с логитами. Вторая часть () — производная по , то есть просто вход. Их перемножение даёт градиент по весам:
grad_z = probs - one_hot_label       # part 1: loss → logits (p - y)
grad_W = np.outer(grad_z, x)         # part 1 × part 2: logits → weights
grad_b = grad_z                       # bias gradient (same as grad_z)
grad_input = W.T @ grad_z            # gradient to pass to the previous layer
grad_input = W.T @ grad_z — это градиентный сигнал, передаваемый предыдущему слою. Тот слой делает то же самое, но с ReLU вместо softmax.
Градиент через ReLU (скрытый слой)
Скрытый слой вычисляет , затем применяет ReLU: . Мы вывели это в предыдущей статье: когда градиент приходит от следующего слоя (grad_output), цепное правило умножает его на производную ReLU:
Если нейрон был активен (), градиент проходит без изменений. Если он был неактивен (), градиент обнуляется. Затем, как и в выходном слое, мы продолжаем цепочку, чтобы получить градиенты по весам:
grad_z = grad_output * (z > 0)       # multiply by ReLU derivative (0 or 1)
grad_W = np.outer(grad_z, x)         # chain rule: gradient for weights
grad_b = grad_z                       # gradient for biases
grad_input = W.T @ grad_z            # pass to the previous layer
Собираем всё вместе
Полный обратный проход начинается с потерь и последовательно проходит через все слои:
- Выходной слой: → вычислить
grad_W,grad_b, передатьgrad_inputназад - Скрытый слой: получить
grad_input, умножить на производную ReLU → вычислитьgrad_W,grad_b, передатьgrad_inputназад - Повторить для любых дополнительных скрытых слоёв
Схема одинакова на каждом слое — отличается только производная активации (softmax или ReLU). Вот полный обратный проход для нашей сети (один скрытый слой + выходной):
# Forward pass (for reference)
z1 = W1 @ x + b1              # hidden layer: weighted sum
h = relu(z1)                   # ReLU activation
z = W2 @ h + b2                 # output layer: hidden → logits
p = softmax(z)                  # softmax: logits → probabilities
loss = -np.log(p[label])        # cross-entropy loss

# Backward pass: chain rule from loss back to weights
# 1. Output layer gradient (softmax + cross-entropy)
grad_z2 = p.copy()
grad_z2[label] -= 1             # p - y

grad_W2 = np.outer(grad_z2, h)  # weight gradient
grad_b2 = grad_z2               # bias gradient
grad_h = W2.T @ grad_z2         # pass gradient to hidden layer

# 2. Hidden layer gradient (ReLU)
grad_z1 = grad_h * (z1 > 0)     # multiply by ReLU derivative

grad_W1 = np.outer(grad_z1, x)  # weight gradient
grad_b1 = grad_z1               # bias gradient

# 3. Update all weights
W2 -= lr * grad_W2
b2 -= lr * grad_b2
W1 -= lr * grad_W1
b1 -= lr * grad_b1
Ровно это и будут реализовывать наши HiddenLayer.backward() и OutputLayer.backward() в коде на NumPy ниже — те же шаги, просто обёрнутые в классы.
Виджет ниже прогоняет именно этот цикл на крошечной сети: заменитель изображения 2×2 подаётся в скрытый слой из 2 нейронов и выход на 3 класса. Выберите вход, укажите правильную цифру и посмотрите, как заполняется обратный проход: ошибка выхода grad_z2 = p − y, ошибка скрытого слоя grad_z1 и матрицы градиентов весов grad_W2 и grad_W1. Нажмите Apply update — и потери упадут: тот же шаг W -= lr * grad_W, сделанный видимым.
Мини-батчи и эпохи
В предыдущей статье мы ввели стохастический градиентный спуск (SGD): вместо того чтобы пройтись по всем точкам данных, собрать градиенты для каждой и усреднить их в одно обновление, мы разбиваем данные на маленькие мини-батчи и обновляем веса после каждого батча. Размер батча — это просто то, по скольким примерам вы усредняете перед обновлением весов: та же формула градиента, то же усреднение, просто другое число примеров.
Как мы видели в предыдущей статье, где на батч приходилось 2 точки из 5, это вносит некоторый шум — градиент по 2 примерам не укажет ровно туда же, куда градиент по всем 5, — но гораздо более частые обновления с лихвой это окупают.
Посмотрим, как это разыгрывается на наших 60 000 обучающих изображений.
Без мини-батчей (полнобатчевый градиентный спуск) один проход по данным выглядит так:
- Прямой проход всех 60 000 изображений через сеть
- Вычисление потерь, усреднённых по всем 60 000 предсказаниям
- Обратное распространение для получения градиента (усреднённого по всем изображениям)
- Одно обновление весов
Это 1 обновление весов после просмотра каждого изображения. Градиент очень точен (он учитывает весь датасет), но модель ничему не учится, пока не обработает все 60 000 изображений.
С мини-батчами размера 32 тот же проход выглядит совсем иначе:
- Взять изображения 1–32, прямой проход, вычислить потери, обратное распространение, обновить веса
- Взять изображения 33–64, прямой проход, вычислить потери, обратное распространение, обновить веса
- Взять изображения 65–96, прямой проход, вычислить потери, обратное распространение, обновить веса
- … повторить для всех мини-батчей
Это 1875 обновлений весов за тот же проход по данным.
Каждый градиент шумнее, поскольку основан на 32 изображениях вместо 60 000, но модель обновляет веса 1875 раз вместо одного. Она учится уже во время прохода по данным. Крайний случай — размер батча 1: обновление после каждого изображения, то есть 60 000 обновлений за эпоху, но с градиентом по одному примеру.
Обработав все 1875 мини-батчей, модель увидела каждое обучающее изображение ровно один раз. Такой полный проход по датасету называется эпохой. Обычно обучение длится несколько эпох, и каждый проход даёт модели ещё одну возможность скорректировать веса.
Число батчей на эпоху определяется размером датасета и размером батча:
В начале каждой эпохи мы перемешиваем данные, чтобы мини-батчи каждый раз были другими — это мешает модели выучивать закономерности в порядке следования, а не в самих изображениях.
Вы можете спросить, как выбрать правильное число эпох. Оно зависит от того, когда модель перестаёт улучшаться на невиданных данных. Слишком мало эпох — модель недоучилась; слишком много — она начинает запоминать обучающие данные вместо обобщения. На практике задают большое максимальное число эпох и позволяют ранней остановке решить, когда действительно остановиться: она следит за валидационной точностью и прекращает обучение, когда та выходит на плато.
Если запустить обучение на 5 эпох, мы получим:
То есть градиентный спуск отрабатывает 9375 раз, каждый раз обрабатывая батч из 32 изображений, вычисляя усреднённый градиент и подталкивая каждый вес в сети.
Построение модели
Построим модель, которая принимает 784 входа (пикселей) и выдаёт 10 вероятностей классов (по одной на цифру). Мы используем ту же структуру HiddenLayer, что и в предыдущей статье: матрица весов , вектор смещений и функция активации:
В предыдущей статье наша модель была одним линейным уравнением — всего 2 параметра, ни слоёв, ни функций активации. Мы вычисляли градиент напрямую, и передавать ничего назад не требовалось, потому что позади ничего не было. Теперь, с несколькими слоями, каждый слой должен вычислять собственные градиенты и передавать градиентный сигнал предыдущему слою — это и есть обратный проход.
Математика цепного правила та же, что мы вывели выше, просто обёрнутая в класс:
class HiddenLayer:
    def __init__(self, n_inputs, n_neurons):
        # We use initialization proposed by Kaiming He et al. (2015):
        # random weights scaled by sqrt(2/n) — keeps activations balanced
        # for ReLU networks (too large → explode, too small → vanish)
        self.W = np.random.randn(n_neurons, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_neurons)

    def forward(self, x):
        self.x = x                          # save for backward pass
        self.z = self.W @ x + self.b        # weighted sum
        self.out = np.maximum(0, self.z)    # ReLU activation
        return self.out

    def backward(self, grad_output):
        # ReLU derivative: 1 if z > 0, else 0
        grad_z = grad_output * (self.z > 0)

        # Gradients for this layer's parameters (chain rule)
        self.grad_W = np.outer(grad_z, self.x)   # ∂loss/∂W = grad_z ⊗ x
        self.grad_b = grad_z                      # ∂loss/∂b = grad_z

        # Gradient to pass to the previous layer (chain rule continues)
        return self.W.T @ grad_z                  # ∂loss/∂x = Wᵀ · grad_z

    def update(self, lr):
        # Gradient descent: update parameters
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
У слоя три метода:
forward: вычислить , применить ReLUbackward: получить градиент от следующего слоя, вычислить локальные градиенты по цепному правилу и вернуть градиент для передачи предыдущему слоюupdate: применить градиентный спуск — вычестьlr × градиентиз каждого параметра
Мы отделяем backward от update, чтобы можно было накапливать градиенты по мини-батчу перед обновлением — ровно как делает Keras.
grad_input в конце — это градиентный сигнал, передаваемый назад предыдущему слою; так цепное правило «течёт» по сети, в точности как на диаграмме из предыдущей статьи:
Forward:   x ──▶ Layer 1 ──▶ Layer 2 ──▶ Output ──▶ Loss
Backward:  x ◀── Layer 1 ◀── Layer 2 ◀── Output ◀── ∂L
Каждый слой получает градиент справа, вычисляет собственные градиенты параметров (чтобы обновить и ) и передаёт остаток градиента влево.
Теперь создадим и выходной слой, который использует softmax вместо ReLU (поскольку последний слой должен выдавать вероятности, а не ReLU-активации):
class OutputLayer:
    def __init__(self, n_inputs, n_classes):
        self.W = np.random.randn(n_classes, n_inputs) * np.sqrt(2.0 / n_inputs)
        self.b = np.zeros(n_classes)

    def forward(self, x):
        self.x = x
        self.z = self.W @ x + self.b
        # Softmax instead of ReLU
        exp = np.exp(self.z - np.max(self.z))
        self.probs = exp / np.sum(exp)
        return self.probs

    def backward(self, label):
        # Combined softmax + cross-entropy gradient: p - y
        grad_z = self.probs.copy()
        grad_z[label] -= 1

        # Same gradient formulas as Layer
        self.grad_W = np.outer(grad_z, self.x)
        self.grad_b = grad_z
        return self.W.T @ grad_z

    def update(self, lr):
        self.W -= lr * self.grad_W
        self.b -= lr * self.grad_b
Теперь можно собрать сеть. Начнём с простой архитектуры — один скрытый слой из 128 нейронов:
# 784 inputs → 128 hidden neurons → 10 output classes
layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)
Но почему 128? Почему не 1 или не 10?
Каждый скрытый нейрон — это детектор признака. Он смотрит на все 784 пикселя через свой вектор весов и выдаёт одно число: «насколько сильно мой паттерн проявляется в этом изображении?». Один нейрон может настроиться на горизонтальный штрих сверху (полезно, чтобы отличать 5 от 7), другой — на замкнутую петлю в нижней половине (6, 8, 9), третий — на диагональ справа вверху. Затем выходной слой взвешивает все 128 этих сигналов, чтобы решить, какая цифра наиболее вероятна.
Каждый выходной нейрон вычисляет скалярное произведение output.W[digit] @ hidden, а затем добавляет смещение. Его вектор весов определяет, какие скрытые активации повышают или понижают оценку данной цифры. Скалярное произведение зависит и от взаимного направления векторов, и от их длин. Побеждает класс с наибольшей оценкой.
С одним скрытым нейроном каждое изображение сводилось бы к одному числу перед передачей выходному слою. Это сильно ограничивает представление штрихов и форм, нужных для различения рукописных цифр. Большее число скрытых нейронов позволяет сети освоить более широкий набор признаков.
Начнём со 128 скрытых нейронов. В этом примере они дают около 97% валидационной точности после пяти эпох. У меньшего слоя меньше параметров; больший может представить больше зависимостей, но требует больше вычислений. Разную ширину слоя сравним в следующей статье.
Это параметров в первом слое и в выходном — всего 101 770 параметров. По сравнению с 2 параметрами ( и ) в примере с подгонкой прямой из предыдущей статьи это в 50 000 раз больше. И всё же алгоритм обучения идентичен.
Та же сеть на Keras
Keras называет свои слои Dense — сокращение от «densely connected» («плотно соединённый», он же «полносвязный»), то есть каждый вход соединён с каждым нейроном. Слой Dense выполняет ровно то же вычисление, что и наши классы на NumPy выше: — умножить входы на веса, добавить смещение, применить функцию активации. Разница в том, что Keras сам занимается инициализацией весов, прямым проходом, вычислением градиентов и обновлением параметров.
Наш HiddenLayer(784, 128) с ReLU превращается в Dense(128, activation="relu"), а OutputLayer(128, 10) с softmax — в Dense(10, activation="softmax"). Заметьте, что в Keras вы указываете только число выходов: модели нужен keras.Input(shape=(784,)) наверху, чтобы знать размер входа, а дальше Keras сам выводит вход каждого слоя из выхода предыдущего. Так что Dense(10) знает, что у него 128 входов, потому что предыдущий слой выдаёт 128.
Dense-слой, полносвязный, FFNN, MLP — в чём разница?
Эти термины используют как взаимозаменяемые, но описывают они разные вещи:
- Dense / полносвязный слой — про разводку одного слоя: каждый вход соединён с каждым нейроном, та самая операция , которую мы строим. Это строительный блок.
- MLP (многослойный перцептрон) — целая сеть из уложенных друг на друга плотных слоёв с нелинейностями между ними. Модель, которую мы только что построили, и есть MLP: 784 → 128 (ReLU) → 10 (softmax).
- FFNN (нейросеть прямого распространения) — описывает топологию: данные текут в одну сторону, от входа к выходу, без петель и без памяти о предыдущих входах. Наша сеть тоже прямого распространения.
Так что для сети вроде нашей подходят все три ярлыка: это полносвязный MLP, и он прямого распространения. Одна тонкость: «прямое распространение» шире, чем «плотный». Свёрточная нейросеть (CNN) тоже прямого распространения (петель нет), но её слои свёрточные, а не плотные, так что не всякая FFNN построена из плотных слоёв. А рекуррентная нейросеть (RNN) не является сетью прямого распространения, потому что заворачивает собственный выход обратно на вход, чтобы нести память по последовательности. Именно этот контраст — прямое распространение против рекуррентности — и объясняет, почему эти названия фигурируют как отдельные архитектуры, когда модели сравнивают на задачах вроде языковых, где порядок слов важен.
Sequential складывает их в модель, где выход каждого слоя подаётся в следующий:
model = keras.Sequential([
    # 784 inputs (28×28 image pixels)
    keras.Input(shape=(784,)),
    # 128 neurons/outputs, ReLU activation
    keras.layers.Dense(128, activation="relu"),
    # 10 neurons/outputs (one per digit), softmax activation
    keras.layers.Dense(10, activation="softmax"),
])

model.summary()
# Total params: 101,770 — same number we counted by hand
Построение цикла обучения
Цикл обучения — тот же 4-шаговый процесс из предыдущей статьи: прямой проход, потери, обратное распространение, градиентный спуск. Для каждого мини-батча мы прогоняем прямой проход и обратное распространение по каждому изображению, накапливая градиенты, затем усредняем их и один раз обновляем веса. Это соответствует тому, что Keras делает внутри:
def train(layers, output_layer, X_train, y_train, X_val, y_val,
          epochs=5, lr=0.1, batch_size=32):
    n = X_train.shape[0]
    history = {"train_loss": [], "train_acc": [], "val_acc": []}

    for epoch in range(epochs):
        # Shuffle training data at the start of each epoch
        indices = np.random.permutation(n)
        X_shuffled = X_train[indices]
        y_shuffled = y_train[indices]

        epoch_loss = 0.0
        correct = 0

        all_layers = layers + [output_layer]

        for i in range(0, n, batch_size):
            X_batch = X_shuffled[i:i+batch_size]
            y_batch = y_shuffled[i:i+batch_size]
            bs = len(X_batch)

            # Accumulate gradients over the mini-batch
            accumulated = {id(l): (np.zeros_like(l.W), np.zeros_like(l.b))
                           for l in all_layers}

            for x, label in zip(X_batch, y_batch):
                # 1. Forward pass
                h = x
                for layer in layers:
                    h = layer.forward(h)
                probs = output_layer.forward(h)

                # 2. Loss computation
                loss = -np.log(probs[label] + 1e-10)
                epoch_loss += loss
                correct += (np.argmax(probs) == label)

                # 3. Backpropagation (compute gradients, don't update yet)
                grad = output_layer.backward(label)
                for layer in reversed(layers):
                    grad = layer.backward(grad)

                # Accumulate gradients
                for l in all_layers:
                    accumulated[id(l)][0][:] += l.grad_W
                    accumulated[id(l)][1][:] += l.grad_b

            # 4. Gradient descent: average gradients and update
            for l in all_layers:
                l.grad_W = accumulated[id(l)][0] / bs
                l.grad_b = accumulated[id(l)][1] / bs
                l.update(lr)

        # Track metrics
        train_loss = epoch_loss / n
        train_acc = correct / n
        val_acc = evaluate(layers, output_layer, X_val, y_val)
        history["train_loss"].append(train_loss)
        history["train_acc"].append(train_acc)
        history["val_acc"].append(val_acc)

        print(f"Epoch {epoch+1}/{epochs} — loss: {train_loss:.4f}, "
              f"train acc: {train_acc:.2%}, val acc: {val_acc:.2%}")

    return history


def evaluate(layers, output_layer, X, y):
    correct = 0
    for x, label in zip(X, y):
        h = x
        for layer in layers:
            h = layer.forward(h)
        probs = output_layer.forward(h)
        correct += (np.argmax(probs) == label)
    return correct / len(y)
Это тот же цикл SGD, что и в предыдущей статье: перемешиваем данные, разбиваем их на мини-батчи, вычисляем и усредняем градиенты внутри каждого батча, затем один раз обновляем веса. Вместо 5 точек данных и 2 параметров у нас теперь 60 000 изображений и 101 770 параметров.
В Keras мы настраиваем обучение через compile и запускаем его через fit:
model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.1),  # gradient descent with lr=0.1
    loss="sparse_categorical_crossentropy",              # cross-entropy loss
    metrics=["accuracy"],
)

history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # hold out 20% of training data for validation
)
compile настраивает функцию потерь и оптимизатор, а fit прогоняет полный цикл — прямой проход, потери, обратное распространение и градиентный спуск для каждого мини-батча в каждой эпохе.
Разберём аргументы:
"sparse_categorical_crossentropy"— это те самые кросс-энтропийные потери, которые мы вывели выше. В названии три части: «sparse» означает, что мы передаём метки целыми числами (например,3), а не one-hot векторами ([0,0,0,1,0,0,0,0,0,0]); «categorical» — что мы классифицируем по нескольким категориям; «crossentropy» — та самая функция потерь . В Keras есть и"categorical_crossentropy"(без «sparse») для случая, когда метки уже в one-hot: математика та же, просто другой формат входа.SGD(learning_rate=0.1)— стохастический градиентный спуск, то же правило обновленияw = w - lr * dwиз предыдущей статьи. В Keras есть и более продвинутые оптимизаторы (Adam, RMSprop и др.), автоматически адаптирующие скорость обучения, но обычный SGD — это то, чем мы пользовались, и здесь он работает хорошо.validation_split=0.2— откладывает 20% обучающих данных (12 000 изображений) в валидационную выборку. После каждой эпохи Keras оценивает модель на этих отложенных изображениях (только прямой проход, без обновления весов), чтобы мы могли следить за обобщающей способностью. Оставшиеся 48 000 изображений используются для собственно обучения.
Подготовка данных
Прежде чем начать обучение сети, нужно подготовить сырые пиксельные данные — сеть не может работать с сетками целых чисел 28×28 напрямую. Мы сделаем две вещи:
- Развернуть — переформатировать сетку 28×28 в один вектор из 784 чисел
- Нормализовать — перевести значения пикселей из в
Разворачивание превращает изображение 28×28 в вектор из 784 входов, который ожидает наша модель. Каждый нейрон первого полносвязного слоя соединён со всеми 784 входами. Свёрточная сеть может использовать пространственное расположение пикселей, а наша полносвязная сеть воспринимает их как плоский список.
flatImage = image.reshape(784) # [0, 0, 0, ..., 156, 252, 128, ..., 0, 0] — 784 valuesНормализация помогает держать входные значения в том же масштабе, что и веса. Веса обычно инициализируются маленькими случайными числами около 0, так что если входы доходят до 255, взвешенные суммы становятся огромными, что ведёт к большим активациям, большим градиентам и нестабильному обучению. Деление на 255 переводит всё в — диапазон, в котором маленькие случайные веса с самого начала дают разумные выходы. Это стандартная практика машинного обучения, а не специфика MNIST.
Большие входные значения могут вызвать насыщение сигмоиды, при котором её производная приближается к нулю и способствует затуханию градиента. ReLU не насыщается на положительной стороне, но большие градиенты могут привести к обновлениям весов, после которых нейроны останутся неактивными. Это поведение мы разберём в статье про умирающий ReLU.
Нормализация переводит значения пикселей из в :
# Normalize pixel values from [0, 255] to [0, 1]
normalizedImage = flatImage / 255.0  # [0.0, 0.0, 0.0, ..., 0.61, 0.99, 0.50, ..., 0.0, 0.0]
Обучающая, валидационная и тестовая выборки
Прежде чем запускать обучение, важно понять одно различие. У нас 60 000 обучающих изображений и 10 000 тестовых, но на самом деле нам нужно три выборки, а не две:
- Обучающая выборка — данные, на которых модель учится. Каждую эпоху она обрабатывает все изображения этой выборки, вычисляет градиенты и обновляет веса.
- Валидационная выборка — после каждой эпохи модель вычисляет на ней потери и точность, выполняя только прямой проход, без обновления весов. Это помогает оценить обобщающую способность: точность 98% на обучающих данных и 90% на валидационных может указывать на переобучение. Ещё один признак — прекращение роста валидационной точности при дальнейшем улучшении обучающей.
- Тестовая выборка — отдельный набор, оцениваемый один раз, в конце, когда все решения об обучении уже приняты. Он позволяет оценить качество модели на новых изображениях из того же распределения данных.
В терминах нашего 4-шагового цикла обучения:
| Обучающая | Валидационная | Тестовая | |
|---|---|---|---|
| 1. Прямой проход | да | да | да |
| 2. Вычисление потерь | да | да (только для отчётности) | да (только для отчётности) |
| 3. Обратное распространение | да | нет | нет |
| 4. Обновление весов | да | нет | нет |
Для обучающих изображений выполняются все 4 шага — модель учится. Для валидационных и тестовых выполняются только шаги 1 и 2: модель измеряет, как у неё дела, но не меняет веса на основе увиденного.
Почему бы не использовать тестовую выборку для обеих задач? Потому что каждый раз, когда вы проверяете качество на наборе данных и принимаете на этом основании решение (например, «продолжать ли обучение?»), вы исподволь подгоняетесь под эти данные. Если использовать тестовую выборку, чтобы решить, когда остановить обучение, тестовая точность станет оптимистически смещённой. Валидационная выборка принимает это смещение на себя, оставляя тестовую честной.
Валидационная выборка также используется для настройки гиперпараметров — таких решений, как скорость обучения, размер батча, число слоёв и число эпох. Вы пробуете разные настройки, сравниваете валидационную точность и выбираете лучшую. Тестовая выборка на всё это время остаётся запечатанной, чтобы дать несмещённую итоговую оценку.
На практике валидационную выборку можно получить, отделив часть обучающих данных. Keras упрощает это с помощью validation_split:
history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    validation_split=0.2,  # use 20% of training data as validation
)
Или можно разделить вручную и передать отдельный набор через validation_data=(X_val, y_val). Мы используем validation_split=0.2 — Keras отложит 20% обучающих данных (12 000 изображений) на валидацию и будет обучаться на оставшихся 48 000. Все 10 000 тестовых изображений остаются полностью в стороне для итоговой оценки.
Обучение модели
Загрузим и подготовим данные с помощью встроенной в Keras функции загрузки MNIST:
import keras
import numpy as np

(train_images, train_labels), (test_images, test_labels) = keras.datasets.mnist.load_data()

# Flatten 28×28 → 784 and normalize to [0, 1]
X_train = train_images.reshape(-1, 784).astype("float32") / 255.0
X_test = test_images.reshape(-1, 784).astype("float32") / 255.0
y_train = train_labels
y_test = test_labels

print(f"Training: {X_train.shape[0]} images, {X_train.shape[1]} pixels each")
print(f"Test:     {X_test.shape[0]} images")
# Training: 60000 images, 784 pixels each
# Test:     10000 images
Теперь у нас 60 000 обучающих изображений (каждое — вектор из 784 значений между 0 и 1) и их метки (каждая 0–9). Тестовая выборка отдельно — мы используем её только для проверки того, насколько хорошо модель обобщает на цифры, которых она не видела во время обучения.
Обучим нашу сеть:
# Split: 80% train, 20% validation
n_val = int(0.2 * len(X_train))
X_val, y_val = X_train[:n_val], y_train[:n_val]
X_train_sub, y_train_sub = X_train[n_val:], y_train[n_val:]

layer1 = HiddenLayer(784, 128)
output = OutputLayer(128, 10)

history = train([layer1], output, X_train_sub, y_train_sub, X_val, y_val,
                epochs=5, lr=0.1, batch_size=32)

# Epoch 1/5 — loss: 0.3260, train acc: 90.70%, val acc: 94.58%
# Epoch 2/5 — loss: 0.1608, train acc: 95.30%, val acc: 95.97%
# Epoch 3/5 — loss: 0.1147, train acc: 96.64%, val acc: 96.49%
# Epoch 4/5 — loss: 0.0898, train acc: 97.45%, val acc: 96.94%
# Epoch 5/5 — loss: 0.0737, train acc: 97.87%, val acc: 97.27%
Вот как выглядит обучение за 5 эпох: левый график показывает падение потерь по мере обучения модели, правый — рост точности. Зелёные точки — валидационная точность (val_accuracy), измеренная в конце каждой эпохи на отложенных изображениях, на которых модель никогда не обучается:
После пяти эпох сеть правильно классифицирует около 97% изображений валидационной выборки.
Уже первая эпоха даёт около 90% точности на обучающих данных. Это среднее по предсказаниям, сделанным в ходе обучения за всю эпоху, которая включает 1500 батчей и обновлений весов. Валидационную точность измеряем отдельно в конце эпохи, используя уже обновлённую модель.
Посмотрите на разрыв между синей линией обучения и зелёной линией валидации, особенно на графике потерь. Обучающие потери продолжают снижаться, а валидационные перестают улучшаться примерно на 4–5-й эпохе и даже начинают расти. Это признак переобучения: дальнейшая подгонка под обучающие данные перестаёт улучшать результаты на новых изображениях. При продолжении обучения разрыв может вырасти — обучающая точность растёт, а валидационная остаётся прежней или падает. Поэтому валидационная выборка помогает решить, когда остановиться. Переобучение подробнее разберём в следующей статье.
Попробуйте сами
У нас есть сопроводительный ноутбук, где можно запустить реализации на Keras и на NumPy бок о бок. Все ячейки выполняются автоматически — вы увидите сначала вывод обучения на Keras, затем вывод обучения на NumPy с теми же метриками.
Вывод Keras выглядит так:
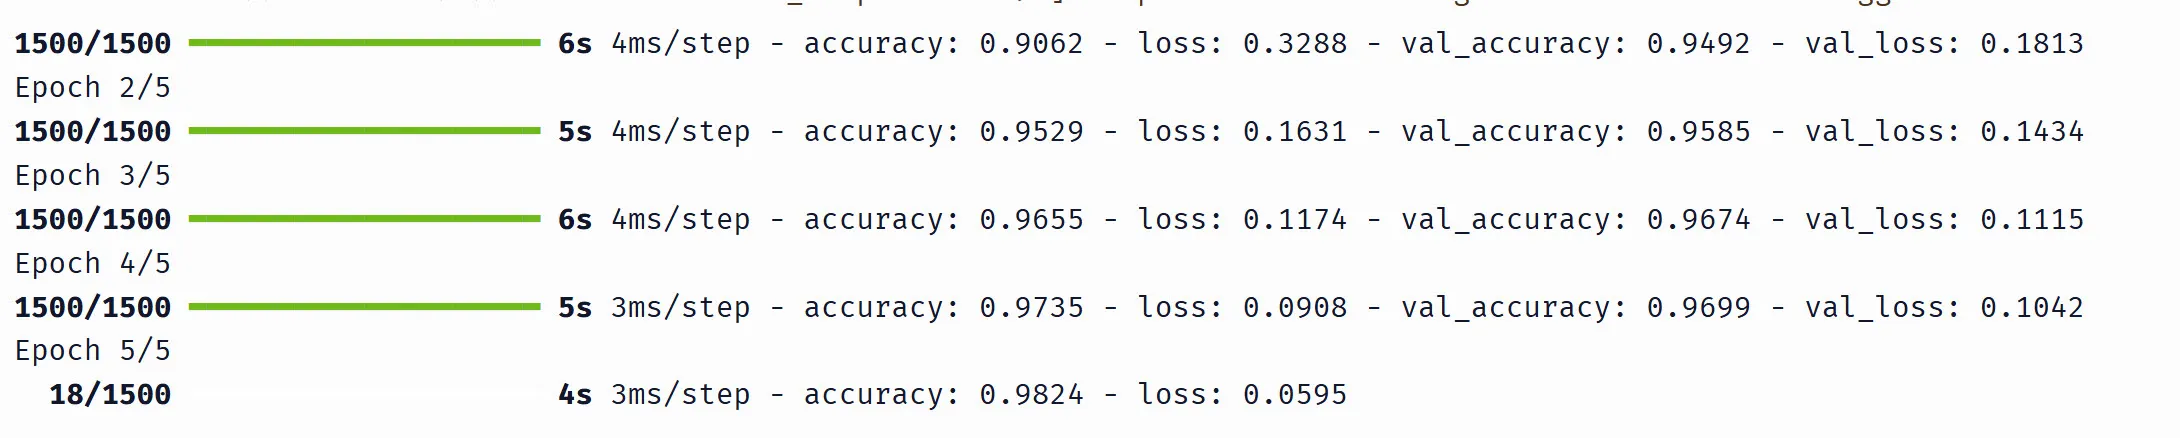
Вот что означает каждая часть:
1500/1500— завершено 1500 мини-батчей из 1500 (48 000 обучающих изображений / 32 на батч). Пока обучение идёт, вы видите, как счётчик растёт (например,18/1500означает, что сделано 18 батчей).5s 4ms/step— эпоха заняла 5 секунд, ~4 миллисекунды на батчaccuracy: 0.9529иloss: 0.1631— метрики обучения, усреднённые по всем батчам эпохиval_accuracy: 0.9585иval_loss: 0.1434— валидационные метрики, вычисленные один раз в конце эпохи на отложенных 12 000 изображениях
Результаты Keras и NumPy не будут идентичными из-за различий в случайной инициализации весов, но должны быть близкими: около 97% валидационной точности после пяти эпох. Сходство результатов согласуется с тем, что обе реализации используют один и тот же алгоритм обучения.
Что мы разобрали
Мы взяли каждое понятие из предыдущей статьи и применили его к реальной задаче — классификации рукописных цифр с более чем 100 000 параметров вместо подгонки прямой с двумя:
- Классификация против регрессии: softmax превращает сырые логиты в вероятности, кросс-энтропия измеряет, насколько эти вероятности неверны
- Прямой проход: вход течёт через слои, каждый вычисляет — та же формула, теперь в матричном виде
- Обратное распространение: градиент softmax + кросс-энтропии упрощается до , а цепное правило течёт назад по слоям ровно так, как мы вывели вручную
- Цикл обучения: перемешать, разбить на мини-батчи, прямой проход → потери → обратное распространение → обновление, повторяемое для каждого батча каждой эпохи
Алгоритм идентичен тому, что мы построили в предыдущей статье. Keras его автоматизирует, но под капотом это то же вычисление, которое наш код на NumPy выполняет шаг за шагом.
Мы всё время использовали фиксированные настройки: один скрытый слой из 128 нейронов, скорость обучения 0.1 и размер батча 32. Что будет, если их изменить? В следующей статье мы сравним разные скорости обучения, размеры батча, глубину сети и функции активации. Также разберём переобучение, раннюю остановку и диагностику проблем с обучением.