Rozkład wektorów i podprzestrzenie: co matryca czyta i kasuje
Jednym z najbardziej użytecznych sposobów oglądania wektora jest kombinacja wektorów składowych. Ta perspektywa pomaga nam zrozumieć transformacje macierzy. Zamiast pytać tylko, co macierz robi z całym wektorem wejściowym, możemy zapytać, co robi z każdym składnikiem. Ponieważ transformacja jest liniowa, przekształcone składowe dają taki sam wynik, jak transformacja całego wektora. Niektóre komponenty mogą silnie wpływać na wynik, niektóre mogą zostać osłabione lub przekierowane, a niektóre mogą zostać całkowicie zignorowane.
W przypadku sieci neuronowych ta perspektywa jest szczególnie przydatna, ponieważ wektory aktywacji często zawierają wiele rodzajów informacji jednocześnie. Konkretna macierz wag niekoniecznie wykorzystuje wszystkie te informacje. Zrozumienie transformacji staje się zatem częściowo kwestią określenia, które kierunki w przestrzeni aktywacji mają znaczenie dla matrycy, a które nie.
Jednym z dokładnych sposobów dokonania tego rozróżnienia jest wykorzystanie przestrzeni wierszy i przestrzeni zerowej macierzy. Dzielą przestrzeń wejściową na kierunki, które mogą mieć wpływ na wynik i kierunki, które matryca całkowicie wymazuje. To wyjaśnia, w jaki sposób dwa różne wektory aktywacji mogą dać dokładnie taki sam wynik w ramach tej samej macierzy wag.
W poprzednim artykule zbadaliśmy, w jaki sposób macierze wag przekształcają wektory i dlaczego sieci neuronowe wymagają nieliniowych aktywacji. W tym artykule rozwijamy algebrę liniową potrzebną do bliższego przyjrzenia się tym przekształceniom.
Najpierw przyjrzymy się, jak można budować wektory z innych wektorów, dlaczego ten sam wektor można rozłożyć w różnych kierunkach oraz w jaki sposób kombinacje liniowe i iloczyny skalarne pomagają nam zrozumieć transformację. Następnie przestudiujemy cztery podstawowe podprzestrzenie macierzy — jej przestrzeń wierszową, przestrzeń zerową, przestrzeń kolumnową i lewą przestrzeń zerową — i wykorzystamy je do zrozumienia, które składowe wejściowe determinują wynik, a które macierz kasuje. Eksperyment towarzyszący wprowadza te podstawy w życie poprzez konstruowanie i testowanie projekcji.
Stanowi to podstawę dla przyszłych artykułów, w tym naszego eksperymentu MNIST: co czyta przeszkolony klasyfikator. Tam ukryta warstwa tworzy wektor 128 wartości aktywacji dla każdego odręcznego obrazu cyfrowego. Identyfikujemy 118 niezależnych kierunków, które wyszkolona warstwa wyjściowa ignoruje, usuwamy odpowiedni składnik wektora aktywacji i zachowujemy wyniki cyfr klasyfikatora aż do zaokrąglenia liczbowego.
Budowanie wektora z komponentów
Macierz definiuje liniową transformację z przestrzeni wejściowej do przestrzeni wyjściowej. Jego kształt określa liczbę współrzędnych w tych przestrzeniach; jego wpisy określają, dokąd trafia każde wejście. W sieci neuronowej przestrzeń wejściowa to przestrzeń, w której żyją wektory aktywacji z warstwy poprzedniej. Przestrzeń wyjściowa to miejsce, w którym żyją wektory przekształcone liniowo, zanim zostanie zastosowana jakakolwiek aktywacja nieliniowa.
Aby zrozumieć wpływ macierzy na wektor, musimy przyjrzeć się składowym wektora, na które można ją rozłożyć. Każdy składnik sam w sobie jest wektorem w przestrzeni wejściowej, a wektor pierwotny jest ich sumą. Dzięki liniowości macierz przekształca każdy składnik osobno, a wynikowe wektory dają taki sam wynik, jak bezpośrednie przekształcenie pierwotnego wektora. Niektóre komponenty mogą zostać rozciągnięte, skrócone lub wysłane w innym kierunku, podczas gdy inne mogą zostać odwzorowane na zero i całkowicie zniknąć.
Wektor ma wiele możliwych rozkładów przy użyciu osi współrzędnych lub kierunków przecinających kilka osi. W mechanistycznej interpretacji i analizie reprezentacji techniki takie jak PCA/SVD, sondy liniowe i rzadkie autoenkodery pomagają zidentyfikować przydatne kierunki na podstawie danych, ujawniając strukturę rozłożoną na wiele wpisów wektora aktywacji.
Przyjrzyjmy się teraz, jak zbudować wektor ze składników. Każda opcja w poniższym widżecie tworzy ten sam niebieski wektor przy użyciu liniowej kombinacji różnych wektorów składowych: każda kolorowa strzałka jest wybranym wektorem przeskalowanym przez współczynnik, a te wektory składowe sumują się do . Pierwsza opcja wykorzystuje trzy wektory bazowe współrzędnych , i . Każdy wskazuje wzdłuż odpowiedniej osi współrzędnych i jest skalowany przez odpowiednią współrzędną .
(5, 3, 2) = 5(1, 0, 0) + 3(0, 1, 0) + 2(0, 0, 1)
Przyjrzyjmy się bliżej opcji widżetu, aby rozróżnić wektor bazowy, jego współczynnik i wynikową składową wektora. Wektor bazowy jest wektorem jednostkowym reprezentującym kierunek: ma długość jeden. Skalar mówi nam, jak bardzo należy go skalować, a jest rzeczywistym składnikiem wektorowym. Na nasze dane wejściowe składają się trzy składowe wektorów:
Współrzędne takie jak są często nazywane składnikami skalarnymi. W tym artykule składnik wektora oznacza cały przeskalowany wektor, taki jak .
W warstwie sieci neuronowej każdy neuron generuje jedną z tych współrzędnych skalarnych. Współczynniki widżetu , i mogą zatem stanowić wyjścia trzech neuronów dla jednego wejścia. Każda aktywacja skaluje odpowiedni wektor bazowy współrzędnych, dając wektor składowy wzdłuż tej osi. Razem te wektory składowe tworzą wektor aktywacji warstwy , jak pokazano poniżej:

Na przykład neuron 2 wyprowadza wartość skalarną . Reprezentujemy jego wkład w wektor warstwy jako . Mnożenie przez i dodawanie wektorów składowych to nasz matematyczny opis składania współrzędnych; nie wymaga dodatkowej warstwy. To samo jest wyjściem tej warstwy i wejściem następnej warstwy.
Macierz wag następnej warstwy przekształca te wektory składowe, a wyniki sumują się do nowego wektora: . Jest to liniowa część obliczeń następnej warstwy, przed dodaniem odchylenia i zastosowaniem funkcji aktywacji.
Wyjścia neuronów zapewniają jeden ze sposobów rozkładu wektora aktywacji warstwy. Duża część analizy reprezentacji i interpretacji mechanistycznej ma na celu bardziej informatywną dekompozycję – kierunki lub podprzestrzenie, które pomagają wyjaśnić, co reprezentuje sieć i jak wykorzystuje te informacje. Matematycznie możliwych jest nieskończenie wiele rozkładów, dlatego potrzebujemy kryteriów i eksperymentów, aby zidentyfikować te przydatne.
Oddzielenie kierunku od wielkości
Oddzielenie kierunku od wielkości pomaga nam zrozumieć podprzestrzenie i transformacje. Wektory takie jak i obejmują tę samą linię pomimo różnych długości. Reprezentowanie ich kierunku za pomocą wektora jednostkowego pozwala iloczynom skalarnym bezpośrednio mierzyć długości projekcji ze znakiem i pozwala nam sprawdzić, w jaki sposób macierz przekształca ten kierunek niezależnie od tego, jaka część jest obecna na wejściu.
Aby wyraźnie podkreślić tę separację, zapisujemy składową wektora jako : jest wektorem jednostkowym reprezentującym wybrany kierunek, a jest skalarem ze znakiem określającym, ile z niego należy uwzględnić. W naszym przykładzie i . Ponieważ długość nigdy nie jest ujemna, do wyrażenia długości komponentu używamy wartości bezwzględnej . Znak ujemny w oznacza, że komponent jest skierowany w kierunku przeciwnym do .
Jak wyrazić składnik jako skalar pomnożony przez wektor jednostkowy, jeśli znamy tylko jego współrzędne? Dla dowolnego niezerowego wektora oblicz jego długość i podziel każdą współrzędną przez tę długość. To jest normalizacja:
Wybór tak, aby wskazywał ten sam kierunek co , powoduje, że jest dodatni. Jeśli zamiast tego najpierw ustalimy kierunek jednostkowy, składowa skierowana przeciwko niemu będzie miała współczynnik ujemny.
Możemy zademonstrować normalizację przy użyciu wektora znajdującego się już w widżecie. Jednym z wektorów w zbiorze jest , który wskazuje na wszystkie trzy osie współrzędnych. Początkowo jego współczynnik wynosi , więc zielony składnik to . Wektory te mają różną długość, ale ten sam kierunek.
Aby przedstawić ich wspólny kierunek za pomocą wektora jednostkowego, moglibyśmy użyć normalizacji L2. Normalizacja skaluje wektor do całkowitej długości , zachowując jego kierunek. Najpierw obliczamy długość , podnosząc jego współrzędne do kwadratu, dodając je i biorąc pierwiastek kwadratowy. Następnie dzielimy każdą współrzędną przez tę długość. Skalowanie wszystkich współrzędnych o tę samą wartość dodatnią zachowuje kierunek:
Powstały wektor ma długość . W ten sposób możemy znormalizować dowolny niezerowy wektor; wektor zerowy nie ma kierunku i nie można go podzielić przez jego długość.
Mnożenie przez pierwotną długość rekonstruuje wektor bazowy: . Zielony komponent widżetu można zatem zapisać jako:
Współczynnik wynosi , gdy skalujemy , ale , gdy skalujemy wektor jednostkowy . Sam komponent pozostaje niezmieniony. Przesunięcie pierwszego suwaka powoduje skalowanie komponentu w tym samym kierunku; wartość ujemna odwraca to.
Od wektorów składowych do podprzestrzeni
Jak dotąd wybraliśmy współczynniki do zbudowania pojedynczego wektora. Zachowując stałe wektory, które łączymy, możemy różnicować te współczynniki względem wszystkich liczb rzeczywistych, aby zbudować cały zbiór wektorów. Ten zbiór jest ich rozpiętością i tworzy podprzestrzeń.
W poniższym widżecie stałe wektory i rozciągają się na płaszczyznę. Zielone i różowe strzałki pokazują ich przeskalowane składniki, a niebieski wektor to ich suma. Gdy zmieniasz współczynniki, niebieski wektor porusza się w płaszczyźnie, pokazując różnych członków tej samej podprzestrzeni. Nie dodaje żadnego niezależnego kierunku, ponieważ jest zbudowany w całości z dwóch ustalonych wektorów.
Spróbuj zmienić dwa współczynniki, oznaczone i , w powyższym widżecie. Niebieski wektor porusza się w zacienionej płaszczyźnie. Wektorów spoza tej płaszczyzny nie można osiągnąć poprzez połączenie naszych dwóch ustalonych wektorów, niezależnie od tego, jakie współczynniki wybierzemy. Wybierz , aby wyświetlić jeden z takich przykładów: pomarańczowy znacznik .
Zacieniowana plama pokazuje część rozpiętości naszych dwóch ustalonych wektorów: nieskończonej płaszczyzny zawierającej wszystkie możliwe kombinacje liniowe. Suwaki liczb całkowitych widżetu pokazują tylko niektóre z tych kombinacji; zezwolenie i na przyjmowanie dowolnych wartości rzeczywistych dociera do każdego wektora na płaszczyźnie. Każdy wynik ma postać:
Mówiąc bardziej ogólnie, dla wektorów stałych i piszemy:
Cały ten rozpiętość jest podprzestrzenią , otaczającej trójwymiarowej przestrzeni wektorowej. Jedna dekompozycja wybiera określone współczynniki i tworzy jeden wektor; podprzestrzeń zawiera każdy wektor, jaki mogą zbudować nasze stałe wektory rozpinające. Zawiera wektor zerowy, a skalowanie lub dodawanie w nim wektorów zawsze daje inny wektor w tym samym zestawie. W naszym przykładzie cała płaszczyzna jest podprzestrzenią, a każdy niebieski wektor jest jej elementem.
Nasze dwa niezależne wektory obejmują płaszczyznę przechodzącą przez początek układu współrzędnych. Wektor leży w tej płaszczyźnie, ponieważ możemy go zbudować za pomocą . Ale jest nieosiągalny: zerowanie pierwszych dwóch współrzędnych wymusza , co również daje trzecie zero. Aby dotrzeć do każdego wektora w 3D, potrzebowalibyśmy trzeciego wektora poza płaszczyzną. Każdy z elementów i wcześniejszych widżetów udostępnia trzy niezależne wektory, więc ich rozpiętości wypełniają cały .
Ten sam wektor może należeć do różnych podprzestrzeni. Na przykład można zbudować jako , którego komponenty rozciągają się na płaszczyznę , lub jako , których komponenty rozciągają się na płaszczyznę . Nieskończenie wiele płaszczyzn przechodzących przez początek układu współrzędnych zawiera ten sam wektor.
Zatem wektor nie wyznacza unikalnej większej podprzestrzeni. Kiedy jednak ustalimy wektory rozpinające, ich rozpiętość jest jednoznacznie określona. W powyższym widżecie obie płaszczyzny zawierają oś . Niebieski wektor i jego punkt końcowy leżą w obu płaszczyznach. Każda zacieniona plama jest częścią nieskończonej płaszczyzny.
Podprzestrzenie umożliwiają nam badanie struktury w reprezentacjach sieci neuronowych. Podprzestrzeń może być powiązana z cechą lub grupą powiązanych cech: jej wektory rozpinające wyznaczają kierunki, wzdłuż których reprezentacja może się zmieniać, a zmiana ich współczynników tworzy komponenty, które mogą kodować różne wartości cech. Jednakże wektory rozciągające się na podprzestrzeń niekoniecznie reprezentują oddzielne cechy, takie jak kolor lub kształt. Potrzebujemy eksperymentów, aby dowiedzieć się, jakie informacje, jeśli w ogóle, reprezentują.
Naukowcy przetestowali takie interpretacje eksperymentalnie. Badanie Othello zidentyfikowało kierunki kodujące stan płytki i zmieniło zachowanie modelu poprzez modyfikację aktywacji wzdłuż nich. W innym badanie stwierdzono, że dni i miesiące są ułożone w przybliżeniu w okręgi w dwuwymiarowych podprzestrzeniach aktywacji; interwencje zmieniły prognozy dotyczące dziennych i miesięcznych zadań arytmetycznych. Płaszczyzna jest podprzestrzenią, natomiast pozycje wokół okręgu reprezentują wartości cech. Eksperymenty te dostarczają dowodów na to, że modele wykorzystują zidentyfikowane reprezentacje, nie sugerując jednak, że każdy punkt w podprzestrzeni ma znaczącą interpretację.
W powyższych przykładach widzieliśmy, jak dwa wektory rozciągają się na płaszczyznę i jak wektor znajdujący się poza tą płaszczyzną pozostaje nieosiągalny, niezależnie od wybranych przez nas współczynników. Teraz interesującym pytaniem jest to, co determinuje geometrię tego rozpiętości: dlaczego płaszczyzna, a nie linia lub cała przestrzeń 3D, i co decyduje o tym, którą płaszczyznę otrzymamy? Aby odpowiedzieć na to pytanie, musimy rozróżnić liczbę współrzędnych od liczby niezależnych kierunków.
Trzy współrzędne nie wymagają trzech niezależnych kierunków
Jeśli zbudujemy wektor w poprzez dodanie wektorów składowych, każdy komponent ma również trzy współrzędne. Posiadanie trzech współrzędnych mówi nam, że wektory żyją w przestrzeni trójwymiarowej; nie mówi nam wymiaru podprzestrzeni, którą obejmują. Wymiar rozpiętości zależy od tego, ile wybranych wektorów jest liniowo niezależnych.
Rozważmy dwa niezależne wektory, i . Ich kombinacje mają postać . Ponieważ trzecia współrzędna ma zawsze wartość zero, wektory te wypełniają płaszczyznę . Mogą zbudować , ale nie . Teraz zamień drugi wektor na :
Rozpiętość jest nadal płaska, teraz pochylona tak, że . Leży w nim na przykład . Dwuwymiarowa podprzestrzeń w przestrzeni trójwymiarowej nie wymaga, aby jedna współrzędna była równa zero. Wektor może mieć trzy niezerowe współrzędne i nadal leżeć w tej płaszczyźnie: trzecia współrzędna jest powiązana z drugą, pozostawiając tylko dwie niezależne możliwości wyboru.
Porównaj poniższe płaszczyzny płaskie i nachylone. Zmiana współczynników przesuwa niebieskie wektory w ich płaszczyznach; żadna konstrukcja nie może dotrzeć do zaznaczonego na czerwono celu.
Dodanie trzeciego wektora spoza tej płaszczyzny, takiego jak , pozwala nam zbudować dowolny wektor w , wybierając odpowiednie współczynniki:
Możemy teraz zbudować dowolny wektor docelowy . Nasza kombinacja daje , więc wybieramy i , aby dopasować pierwsze dwie współrzędne, a następnie , aby dopasować trzecią. Na przykład, aby zbudować , wybierz , i . Trzeci wektor znajdujący się już na płaszczyźnie nie dodałby niezależnego kierunku.
Następny widżet pokazuje to rozwinięcie, zaczynając od płaskiej płaszczyzny: dodanie nadaje konstrukcji prawej trzeci niezależny kierunek. Dzięki trzem dowolnie wybranym współczynnikom konstrukcja ta może osiągnąć dowolny wektor w . Wartości początkowe , i osiągają wartość docelową . Przesuń , aby zmienić trzecią współrzędną bez zmiany dwóch pierwszych.
Z punktu widzenia analizy reprezentacji wspólna podprzestrzeń, w tym przypadku płaszczyzna, może nam coś powiedzieć o zbiorze reprezentacji. Aby połączyć tę geometrię z siecią neuronową, zastanów się, co się stanie, gdy przetworzy ona kilka różnych danych wejściowych. Możemy zebrać wektory aktywacji z tej samej warstwy do macierzy aktywacji, z jednym wejściem w wierszu i jednym neuronem w kolumnie. Analiza tej macierzy może ujawnić, czy zebrane aktywacje leżą we wspólnej podprzestrzeni niższego wymiaru.
Załóżmy, że trzy obrazy dają wektory aktywacji , i . Wszystkie trzy można zbudować z tych samych dwóch stałych wektorów, i :
Zatem wszystkie trzy aktywacje leżą w tej samej płaszczyźnie, mimo że każda ma trzy współrzędne. Wektory rozpinające pozostają stałe; tylko ich współczynniki zmieniają się z obrazu na obraz.
Kiedy przepuszczamy różne obrazy przez tę samą warstwę, każdy obraz tworzy swój własny wektor aktywacji. Aby sprawdzić, czy te wektory mają wspólną płaszczyznę, zadajemy pytanie, czy te same dwa wektory rozpinające mogą zbudować każdy z nich. Znalezienie płaszczyzny zawierającej wektor aktywacji jednego obrazu nie mówi nam, czy wektory aktywacji innych obrazów również się w niej znajdują.
Następnie zobaczmy, co się stanie, gdy zorganizujemy nasze wektory konstrukcyjne jako kolumny macierzy.
Kombinacje liniowe: budowanie wyników z kolumn
Wyobraź sobie dwa zestawy możliwych wektorów. Nazywamy je przestrzenią wejściową i przestrzenią wyjściową. Macierz definiuje funkcję odwzorowującą pomiędzy nimi: pobiera wektor wejściowy i tworzy wektor wyjściowy . To odwzorowanie jest transformacją liniową.
Jeśli przyjrzymy się, jak buduje dane wyjściowe, możemy zobaczyć, w jaki sposób każda kolumna wnosi wektor składowy. Każda kolumna leży w przestrzeni wyjściowej i jest skalowana według odpowiedniej współrzędnej — wyjścia jednego neuronu w poprzedniej warstwie. Widzieliśmy wcześniej, jak aktywacje neuronów skalują wektory bazowe współrzędnych, tworząc wektor aktywacji warstwy. Po przejściu do następnej warstwy te same aktywacje skalują kolumny , które służą jako wektory, które łączymy w celu zbudowania wyniku. Te skalowane kolumny sumują się do , co daje wynik liniową kombinację kolumn macierzy.
Zapisując kolumny jako i współrzędne wejściowe jako , możemy wyrazić tę konstrukcję jako:
W sieci neuronowej jest macierzą wag warstwy, a jest wektorem aktywacji dostarczonym przez poprzednią warstwę. Każda współrzędna skaluje odpowiednią kolumnę , tworząc wektor składowy wyniku.
Poniższy widget śledzi tę konstrukcję kolumna po kolumnie. Każda współrzędna wejścia skaluje odpowiadającą jej kolumnę, tworząc wektor składowy. Wybierz , aby śledzić, jak każda współrzędna wejściowa skaluje swoją kolumnę. Pasująca strzałka podkreśla ten krok, podczas gdy wszystkie trzy składowe sumują się do przekształconego wyniku .
Komponenty te pozwalają nam śledzić, jak poszczególne współrzędne wejściowe wpływają na wynik. Aby zbadać cechę rozłożoną na kilku współrzędnych, możemy zamiast tego rozłożyć dane wejściowe wzdłuż kierunków powiązanych z tą cechą i sprawdzić, w jaki sposób przekształca te składowe.
Przestrzeń kolumn: jakie wyniki może osiągnąć macierz?
Macierz niekoniecznie dociera do każdego wektora w przestrzeni wyjściowej; może odwzorowywać wszystkie wektory wejściowe na mniejszą podprzestrzeń, taką jak płaszczyzna w przestrzeni trójwymiarowej. Wcześniej widzieliśmy, jak ustalony zbiór wektorów składowych może budować tylko wektory leżące w ich rozpiętości, co tworzy podprzestrzeń. W przypadku macierzy ta podprzestrzeń osiągalnych wyników nazywana jest jej przestrzenią kolumnową.
Nazwa wzięła się stąd, że kolumny macierzy są stałymi wektorami rozpinającymi podprzestrzeń możliwych wyników.
W wcześniejszym widżecie zbudowaliśmy ten sam wektor , używając trzech różnych zestawów wektorów składowych. Popatrzmy teraz na każdą konstrukcję jako na transformację macierzy: wybrane przez nas wektory stają się kolumnami , ich współczynniki stają się wektorem wejściowym , a jest wyjściem .
Wszystkie trzy konstrukcje wytwarzają z wybranymi współczynnikami, ale nie wszystkie mogą generować ten sam zakres innych wyników. Utrzymując stałą macierz i zmieniając jej dane wejściowe, możemy zobaczyć, które wektory należą do jej przestrzeni kolumnowej.
Najpierw zacznijmy od wektora w opcji . Zbudowaliśmy jako . Trzy wektory współrzędnych stają się kolumnami , a współczynniki skalujące stają się wpisami :
Ponieważ jest macierzą tożsamości, pozostawia dane wejściowe bez zmian: .
Wektor wejściowy ma trzy współrzędne, więc przestrzeń wejściowa to . Każda współrzędna skaluje jedną kolumnę . Te trzy kolumny obejmują cały , więc ta macierz może dotrzeć do każdego wektora w przestrzeni wyjściowej.
Przyjrzyjmy się teraz opcji . Budujemy ten sam wektor co . Kolumny to teraz , i , ze współczynnikami wejściowymi :
Przestrzeń wejściowa i wyjściowa to nadal . Te trzy kolumny są również niezależne, więc ich kombinacje liniowe mogą dać każdy wektor wyjściowy. Zmieniliśmy wektory konstrukcyjne i współczynniki wejściowe, ale nadal możemy osiągnąć wszystkie .
Gdy wypróbujemy opcję , pojawia się coś interesującego. Ten sam wektor jest teraz zbudowany przy użyciu tylko dwóch wektorów konstrukcyjnych: . Oznacza to, że nasza macierz transformacji ma tylko dwie kolumny. Na jego wejściu znajdują się dwa współczynniki :
Przestrzeń wejściowa wynosi teraz , ponieważ podajemy tylko dwa współczynniki. Przestrzeń wyjściowa pozostaje , ponieważ każde wyjście ma nadal trzy współrzędne: . Istnieją jednak tylko dwie niezależne możliwości wyboru, i , mimo że wynik ma trzy współrzędne. Kształt macierzy ogranicza osiągalną podprzestrzeń w przestrzeni wyjściowej do co najwyżej dwóch wymiarów.
Dwa wybrane przez nas wektory konstrukcyjne, a co za tym idzie odpowiadające im kolumny macierzy, są niezależne, więc obejmują płaszczyznę przechodzącą przez początek układu współrzędnych, a ich wartości określają, która to jest płaszczyzna. W poprzednich przykładach kolumny obejmowały całą trójwymiarową przestrzeń wyjściową. W tym przypadku, mając tylko dwa wektory, nadal możemy osiągnąć ten sam wektor , ale tylko dlatego, że leży on w płaszczyźnie, którą obejmują – przestrzeni kolumnowej macierzy. Wektory poza tą płaszczyzną pozostają nieosiągalne.
Poniższa tabela porównuje trzy konstrukcje: jakie wektory wejściowe akceptuje każda macierz i jakie wektory wyjściowe może wytworzyć. Wszystkie trzy mają tę samą trójwymiarową przestrzeń wyjściową, ale tylko niektóre macierze mogą wytworzyć każdy wektor w tej przestrzeni.
| Opcja widgetu | Przestrzeń wejściowa: współczynniki | Przestrzeń kolumn: osiągalne wyjścia |
|---|---|---|
| Podstawa współrzędnych | Wszystko z | |
| Inna podstawa | Wszystko z | |
| Dwa wektory | Samolot w środku |
Widzieliśmy, jak posiadanie tylko dwóch kolumn ogranicza osiągalne wyniki do co najwyżej płaszczyzny. Co ciekawe, posiadanie trzech kolumn nie gwarantuje, że macierz może objąć całą trójwymiarową przestrzeń wyjściową. Kolumny muszą być również liniowo niezależne.
W poniższej macierzy pierwsze dwie kolumny są identyczne, więc druga kolumna nie dodaje nowego kierunku. Kolumny i są niezależne i stanowią podstawę płaszczyzny osiągalnych wyjść:
Możemy zobaczyć matematycznie, dlaczego te trzy kolumny dają wyniki tylko w dwóch niezależnych kierunkach. Zapiszmy wejście jako i wyjście jako . Od pierwsze dwie współrzędne wejściowe skalują ten sam wektor kolumnowy:
Jeśli pozwolimy i , każde możliwe wyjście ma postać:
Widzimy, że każde wyjście jest określone przez dwie wartości, i , przy czym trzecia współrzędna jest zawsze równa sumie dwóch pierwszych. Wszystkie wektory z tą zależnością tworzą płaszczyznę, która jest przestrzenią kolumnową macierzy. Wymiar zależy od liczby niezależnych kierunków, a nie od liczby kolumn.
Produkty kropkowe: tworzenie wyników po jednym wierszu na raz
W poprzedniej sekcji widzieliśmy, jak kolumny macierzy tworzą dane wyjściowe ze skalowanych wektorów. Przyjrzyjmy się teraz tej samej transformacji poprzez wiersze macierzy i sprawdźmy, w jaki sposób wektory składowych danych wejściowych wpływają na każdą współrzędną wyjściową. Jak wyjaśniono w jak neurony współpracują przy przekształcaniu wektora, każdy wiersz macierzy wag pobiera iloczyn skalarny z całym wektorem wejściowym, tworząc jedną współrzędną wyjściową.
Poniższy widget śledzi obliczenia po wierszu na raz. Wybierz każdy wiersz, aby zobaczyć, jak jego wagi stanowią iloczyn skalarny z całym wejściem , tworząc jedną współrzędną wyjścia .
Skupmy się na pierwszym rzędzie. Jego iloczyn skalarny z całym wejściem daje skalar :
Liniowość pozwala nam wyrazić ten iloczyn skalarny jako sumę udziałów wektorów składowych sygnału wejściowego. Aby zobaczyć, skąd pochodzą , i , podziel dane wejściowe na składowe współrzędnych:
Dla pierwszego rzędu liniowość daje:
Każdy komponent dostarcza jeden wkład skalarny do tej współrzędnej wyjściowej:
Dodanie ich daje dokładnie taki sam wynik, jak bezpośrednie obliczenie .
Powtarzanie tych obliczeń dla każdego wiersza daje jeden wynik skalarny na wiersz. Zbieranie tych wyników tworzy wektor wyjściowy . W przypadku każdego wiersza wzięcie iloczynu skalarnego z całą wartością wejściową daje taki sam wynik, jak dodanie iloczynu skalarnego z jego składnikami.
Działa to dla dowolnej dekompozycji wejścia: jeśli , to , nawet jeśli komponenty są skierowane w inne strony.
Geometrycznie możemy rzutować każdy komponent na tę samą linię — w kierunku wektora wiersza — i dodawać te rzuty ze znakiem. Ich suma równa się rzutowi całego wejścia. Składowa skierowana częściowo wzdłuż ma wpływ dodatni, część skierowana częściowo w stronę niej ma wkład ujemny, a składowa prostopadła ma wkład zerowy.
Aby wyraźnie zobaczyć te rzuty, następny widżet wykorzystuje dwuwymiarowy przykład z rzędem jednostek skierowanym wzdłuż osi poziomej. Zielony wektor i różowy wektor to dwa wektory składowe. Niebieski wektor to połączony wektor, który zbudowali.
Linie przerywane łączą punkt końcowy każdego wektora z jego rzutem na oś poziomą. Pasujące kolorowe strzałki wzdłuż tej osi pokazują rzutowane wektory: zielony dla , różowy dla i niebieski dla ich sumy . Te strzałki projekcji mogą się nakładać. Rzut skierowany w prawo ma pozytywny wpływ, jeden skierowany w lewo ma negatywny wpływ, a projekcja zerowa nie wnosi nic. Ponieważ ma długość jeden, każda długość projekcji ze znakiem jest równa odpowiadającemu iloczynowi skalarnemu z .
Przeciągnij punkt końcowy dowolnego komponentu lub zmień jego współrzędne, aby zobaczyć aktualizację połączonego wektora i jego rzutów. Wypróbuj , i , aby zobaczyć wkłady ujemne, zerowe i anulujące.
Widżet wykorzystywał wiersz jednostkowy, zatem długość projekcji ze znakiem każdego komponentu stanowiła jego udział w wynikach. Wiersz macierzy wag nie musi mieć długości jeden: jego długość skaluje każdy wkład. Aby zrozumieć, ile wnosi każdy element, musimy wziąć pod uwagę zarówno jego długość, jak i wyrównanie z rzędem.
Dla kierunku rzędu jednostek , iloczyn skalarny jest długością rzutowania ze znakiem komponentu . Użycie samego mnoży tę długość przez :
gdzie jest kątem pomiędzy komponentem a kierunkiem rzędu. Dla naszego rzędu , którego długość wynosi :
- ma długość i wyrównanie , co daje wkład .
- ma długość i wyrównanie , co daje wkład .
- ma długość i wyrównanie , co daje wkład .
Z tego widzimy, że trzeci składnik jest najbliżej wyrównany z : ma największy cosinus, a zatem najmniejszy kąt do kierunku rzędu. Ale pierwszy komponent wnosi więcej, ponieważ jest dłuższy. Każdy składnik wejściowy ma swój udział zgodnie ze swoją długością i wyrównaniem z kierunkiem wiersza, a liniowość pozwala nam dodać te składowe ze znakiem, aby uzyskać odpowiedź wiersza na cały wektor wejściowy.
Wiersze i kolumny umożliwiają obliczenie tej samej transformacji na dwa sposoby:
| Kolumny | Wiersze | |
|---|---|---|
| Gdzie żyją wektory | Przestrzeń wyjściowa | Miejsce wprowadzania |
| Rola w mnożeniu | Skaluj i dodawaj, aby zbudować wynik | Każdy bierze iloczyn skalarny, aby obliczyć jedną współrzędną wyjściową |
Przestrzeń wierszy i przestrzeń zerowa: co matryca czyta, a co ignoruje
Zacznijmy od dwóch wektorów i . Są one niezależne, a ich kombinacje liniowe mają postać
Ich rozpiętość to płaszczyzna , której wszystkie wektory mają postać , jak pokazano na poniższym widżecie.
Teraz wyobraźmy sobie, że mamy niebieski wektor i chcemy sprawdzić, czy leży on w tej podprzestrzeni. Jednym ze sposobów jego rozłożenia jest składnik zielony i składnik różowy .
Zwróć uwagę, że zielony komponent leży na płaszczyźnie, podczas gdy różowy komponent i niebieski wektor leżą poza nią. Zielony składnik leży na płaszczyźnie, ponieważ można go zbudować z dwóch wektorów i , które go rozciągają.
Załóżmy teraz, że używamy dwóch ustalonych wektorów i jako wierszy macierzy:
W tym przypadku każdy wiersz zawiera wektor, którego możemy użyć w kombinacji liniowej. Wspólnie wektory te obejmują podprzestrzeń przestrzeni wejściowej zwanej przestrzenią wierszy. Płaszczyzna w widżecie jest zatem przestrzenią wierszy tej macierzy.
Spróbujmy teraz innego rozkładu tego samego niebieskiego wektora, używając zielonego składnika i różowego składnika . Kolor zielony nadal leży w płaszczyźnie przestrzeni rzędów, ale kolor różowy jest teraz do niej prostopadły, jak pokazano na poniższym widżecie.
Potraktujmy niebieski wektor jako dane wejściowe i sprawdźmy, jak jego składowe wpływają na wynik każdej dekompozycji. Macierz daje ten sam wynik w obu przypadkach, ale składniki w każdym rozkładzie mają na to inny wpływ.
W pierwszym rozkładzie możemy obliczyć udział każdego składnika, biorąc jego iloczyn skalarny z każdym wierszem . Każdy wynik podaje jedną współrzędną udziału tego składnika w wyniku.
| Zielony komponent | Różowy komponent | |
|---|---|---|
| Iloczyn kropkowy z rzędem 1 | ||
| Iloczyn kropkowy z rzędem 2 | ||
| Wkład w wynik |
Trzecia współrzędna żadnego ze składników nie ma wpływu na wynik, ponieważ oba wiersze macierzy mają trzecią współrzędną zerową. Liniowo, składki zielone i różowe sumują się do wyniku:
W drugim rozkładzie zielony wnosi cały wynik, podczas gdy różowy nie wnosi nic:
| Zielony komponent | Różowy komponent | |
|---|---|---|
| Iloczyn kropkowy z rzędem 1 | ||
| Iloczyn kropkowy z rzędem 2 | ||
| Wkład w wynik |
Podobnie jak w przypadku pierwszego rozkładu, trzecia współrzędna żadnego ze składników nie ma wpływu na wynik, ponieważ oba wiersze macierzy mają trzecią współrzędną zerową. Liniowo, składki zielone i różowe sumują się do wyniku:
Zwróć uwagę na różnicę między tymi dwoma rozkładami: pierwszy różowy składnik nadal ma udział w wynikach, podczas gdy drugi nie wnosi żadnego wkładu. Dzieje się tak, ponieważ druga różowa składowa jest prostopadła do obu wierszy, a co za tym idzie do całej przestrzeni wierszy. Widzimy to w widżetach i obliczeniach iloczynu skalarnego w tabelach. W pierwszym przypadku składnik różowy ma iloczyny skalarne i z dwoma rzędami, podczas gdy w drugim przypadku oba iloczyny skalarne mają wartość zerową. To pokazuje, że położenie poza przestrzenią wierszy nie oznacza, że wektor jest całkowicie ignorowany; jest prostopadły do każdego rzędu.
Przestrzeń zerowa: dane wejściowe, które nic nie wnoszą
Widzieliśmy, że drugi różowy składnik, , nie wnosi nic, ponieważ jest prostopadły do każdego wiersza. To samo dotyczy każdego wektora wzdłuż osi : zmiana jego długości lub odwrócenie jego kierunku nadal pozostawia oba iloczyny skalarne na poziomie zerowym.
Zbiór wszystkich wektorów wejściowych, które macierz odwzorowuje na zero, nazywany jest jej przestrzenią zerową. W przypadku macierzy, której używaliśmy w poprzednich sekcjach, tym zbiorem jest cała oś . Pierwszy różowy składnik ma część w przestrzeni zerowej; drugie całkowicie w nim leży.
W obu przypadkach składową zerową przestrzeni wejściowej jest . Drugi rozkład wyraźnie go izoluje, umieszczając cały komponent przestrzeni wierszy na zielono. ** Dane wejściowe mają wiele możliwych dekompozycji, ale ich podział na komponent w przestrzeni wierszy i komponent w przestrzeni zerowej jest unikalny.**
Możemy więc wziąć dowolną macierz i akceptowane przez nią dane wejściowe i sprawdzić, którą część tych danych wejściowych macierz ignoruje, a która część wpływa na wynik. Istnieje tylko jeden sposób podziału danych wejściowych tak, aby jedna część znajdowała się całkowicie w przestrzeni wierszy, a druga całkowicie w przestrzeni zerowej.
W przypadku naszej macierzy i danych wejściowych jest to dokładnie drugi rozkład pokazany w naszych widżetach i tabelach:
Alternatywna dekompozycja tworzy te same dane wejściowe, ale ich drugi składnik nie znajduje się całkowicie w przestrzeni zerowej. W tym przykładzie obliczenia są proste; w przypadku macierzy ogólnej metody takie jak SVD pozwalają nam systematycznie obliczać podział.
Wektor jest odwzorowany na zero, gdy jest prostopadły do każdego wiersza, a zatem do każdego wektora w przestrzeni wierszy. Przestrzeń zerowa jest prostopadłym dopełnieniem przestrzeni wierszowej, którą zapisujemy jako:
Symbol oznacza wszystkie wektory prostopadłe do każdego wektora w tej przestrzeni. Podział danych wejściowych na te dwie części daje:
Zatem pokazuje, że tylko komponent przestrzeni wierszy wpływa na wynik. Macierz może nadal zmieniać swoją długość i kierunek lub mapować ją w przestrzeń wyjściową o innej liczbie współrzędnych.
Lewa przestrzeń zerowa: prostopadła do każdego możliwego wyniku
Załóżmy, że macierz wag warstwy ma trzeci wiersz równy sumie jej dwóch pierwszych wierszy. Prowadzi to do ograniczenia wyniku: trzecia współrzędna jest zawsze równa sumie dwóch pierwszych. Bez względu na to, jakie dane wejściowe mu podajemy, nie może wygenerować , ponieważ pierwsze dwie współrzędne wymagałyby, aby trzecia była . Lewa przestrzeń zerowa pomaga nam zidentyfikować takie ograniczenia na wyjściu warstwy.
Jak widzieliśmy wcześniej, przestrzeń kolumn zawiera wszystkie możliwe wyniki. Lewa przestrzeń zerowa opisuje kierunki prostopadłe do nich wszystkich. Tak jak przestrzeń zerowa jest prostopadła do przestrzeni wierszy w przestrzeni wejściowej, tak lewa przestrzeń zerowa jest prostopadła do przestrzeni kolumn w przestrzeni wyjściowej.
W naszym wcześniejszym przykładzie z przestrzenią kolumn każde wyjście ma postać . Trzecia współrzędna jest zawsze sumą dwóch pierwszych. Wektor uwzględnia to ograniczenie:
Leży w lewej przestrzeni zerowej, ponieważ jest prostopadła do każdego możliwego wyniku. Cel taki jak łamie to ograniczenie, więc żadne dane wejściowe nie mogą sprawić, że ta matryca go wytworzy. Sama zmiana wejścia nie może naprawić tego niedopasowania.
Nadaje to lewej przestrzeni zerowej praktyczną rolę: ujawnia ograniczenia dotyczące tego, co może wytworzyć macierz o stałej wadze. W przypadku warstwy predykcji liniowej może nam ona powiedzieć, że niektóre docelowe wyniki są nieosiągalne nawet zanim spróbujemy znaleźć dane wejściowe, które je wygenerują. Te ograniczenia dotyczą wyjścia liniowego ; dodanie odchylenia przesuwa je do dla , a następująca po nich nieliniowa aktywacja może je jeszcze bardziej zmienić.
Należy podkreślić, że lewa przestrzeń zerowa nie jest miejscem, w którym trafiają usunięte dane wejściowe; te dane wejściowe są mapowane na początek. Opisuje ograniczenia po stronie wyjściowej.
Łączenie czterech podprzestrzeni
Możemy teraz połączyć cztery przestrzenie na jednym obrazku. Przestrzeń wierszowa i przestrzeń zerowa dzielą dane wejściowe na składowe prostopadłe. Macierz wysyła składnik przestrzeni zerowej do zera i przekształca składnik przestrzeni wierszy na wynik w przestrzeni kolumn. Lewa przestrzeń zerowa jest prostopadła do każdego wektora w tej podprzestrzeni wyjściowej.
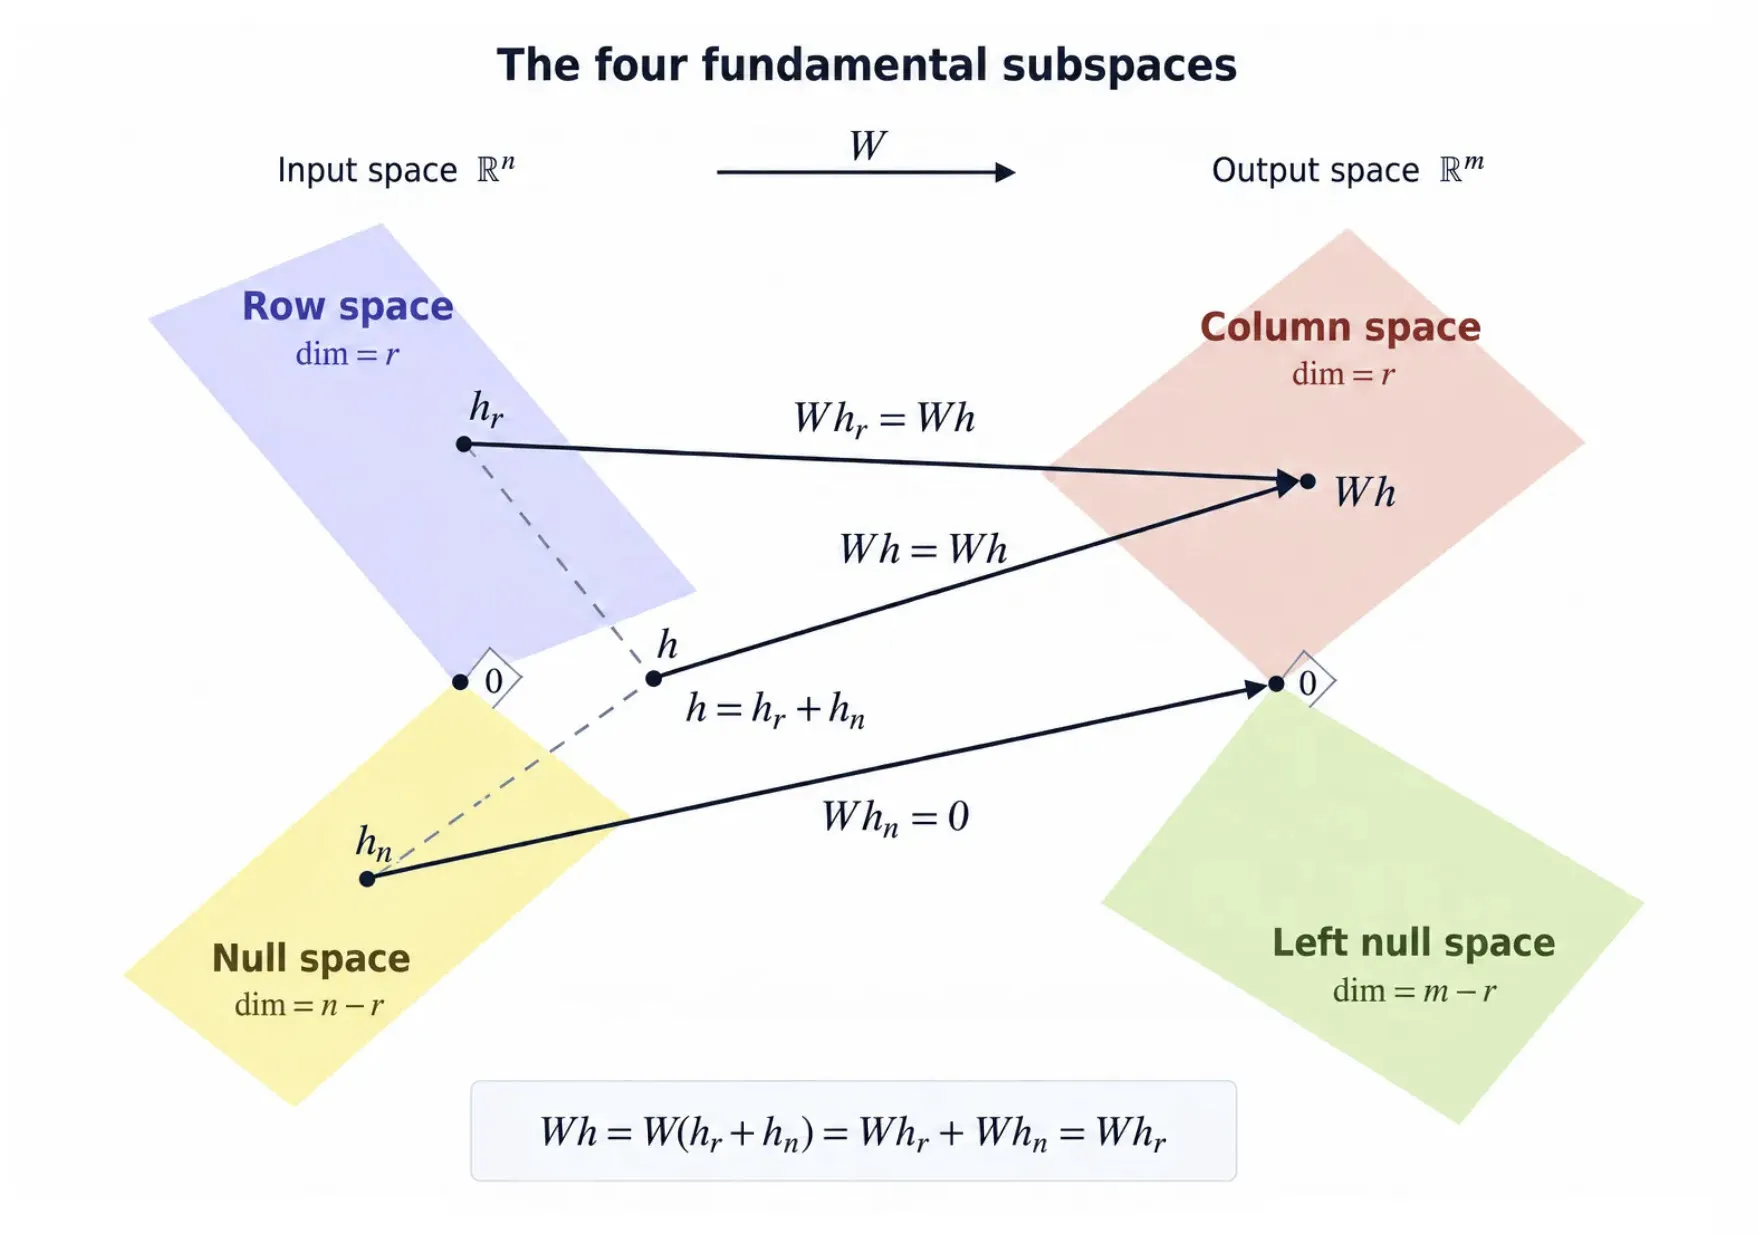
Obrazek pokazuje wzajemne powiązanie czterech podprzestrzeni, ale jej płaskie obszary są schematyczne: podprzestrzeń może być linią lub płaszczyzną, w zależności od macierzy. Poniższe dwa widżety ukonkretniają te relacje. Możesz zmienić dane wejściowe i zobaczyć, jak są one podzielone na komponenty z przestrzenią wierszy i zerową oraz w jaki sposób każdy komponent wpływa na wynik.
Przyjrzyjmy się teraz tym zależnościom w poniższym widżecie. Wykorzystuje wektor wejściowy i macierz:
Początkowe wejście leży zarówno poza płaszczyzną przestrzeni wierszy, jak i linią przestrzeni zerowej. W każdym jest jakiś element. Trzy suwaki kontrolują współrzędne wejściowe , i . Zmiana ich zmienia wektor, który przekształca macierz, podczas gdy sama macierz pozostaje stała.
Input space · ℝ³
Row space is a plane, Null space is a line
Output space · ℝ³
Column space is a plane, Left null space is a line
Drag either plot to rotate; scroll to zoom. With a plot focused, use the arrow keys to rotate, + and − to zoom, or 0 to reset zoom.
Oto, co definiuje każdą z czterech podprzestrzeni. Parametry , , , i mogą być dowolnymi liczbami rzeczywistymi.
| Podprzestrzeń | Kształt | Wektory, które zawiera | Co to oznacza |
|---|---|---|---|
| Przestrzeń wierszowa | Samolot | Pierwsze dwie współrzędne wejściowe są równe (); trzeci jest nieograniczony. | |
| Miejsce zerowe | Linia | Pierwsze dwie współrzędne wejściowe znoszą, a trzecia wynosi zero. Te wektory są odwzorowane na zero. | |
| Miejsce na kolumnę | Samolot | Trzecia współrzędna wyjściowa jest sumą dwóch pierwszych (). | |
| Lewa przestrzeń zerowa | Linia | Pierwsze dwie współrzędne są równe, a trzecia jest ich ujemną. Wektory te są prostopadłe do każdego wektora w przestrzeni kolumnowej. |
Trzy karty pokazują cały wkład i jego dwa składniki. Zastosowanie do komponentu przestrzeni wierszy daje taki sam wynik, jak zastosowanie go do całego wejścia. Składnik zerowy wnosi zero, więc dodanie lub usunięcie go pozostawia wynik niezmieniony.
i obrazu odpowiadają i widżetu. Początkowo niebieskie wejście jest rozdzielane na składową zieloną i różową:
Strzałki przecinające obraz przedstawiają zastosowanie . W widgecie zarówno całe wejście, jak i jego zielony komponent dają , więc ich strzałki wyjściowe nakładają się na pomarańczową płaszczyznę. Różowy składnik jest mapowany na zero. Fioletowa linia lewej przestrzeni zerowej jest prostopadła do płaszczyzny wyjściowej; nie jest to miejsce, do którego trafiają usunięte dane wejściowe.
Zmiana danych wejściowych pozostawia cztery podprzestrzenie stałe.
Użyjmy teraz tego samego wektora wejściowego z tą alternatywną macierzą:
Ma ten sam kształt , ale ma rangę 1: wszystkie jego wiersze są wielokrotnościami . Przestrzenie wierszy i kolumn są liniami, a obie przestrzenie zerowe są płaszczyznami. Początkowe wejście leży poza linią przestrzeni wierszy i płaszczyzną przestrzeni zerowej, z komponentem w każdym z nich. Suwaki zmieniają dane wejściowe, podczas gdy ta matryca pozostaje stała.
Input space · ℝ³
Row space is a line, Null space is a plane
Output space · ℝ³
Column space is a line, Left null space is a plane
Drag either plot to rotate; scroll to zoom. With a plot focused, use the arrow keys to rotate, + and − to zoom, or 0 to reset zoom.
W przypadku tej macierzy cztery podprzestrzenie zawierają następujące wektory. Ponownie, parametrami mogą być dowolne liczby rzeczywiste.
| Podprzestrzeń | Kształt | Wektory, które zawiera | Co to oznacza |
|---|---|---|---|
| Przestrzeń wierszowa | Linia | Pierwsze dwie współrzędne wejściowe są równe, a trzecia wynosi zero. | |
| Miejsce zerowe | Samolot | Pierwsze dwie współrzędne wejściowe anulowane (); trzeci jest nieograniczony. Te wektory są odwzorowane na zero. | |
| Miejsce na kolumnę | Linia | Drugie i trzecie współrzędne wyjściowe są dwa razy i trzy razy większe niż pierwsze. | |
| Lewa przestrzeń zerowa | Samolot | Współrzędne odpowiadają . Wektory te są prostopadłe do kierunku przestrzeni kolumn . |
Tutaj zmiana pozostawia wynik niezmieniony: trzeci kierunek współrzędnych leży w przestrzeni zerowej. Tylko komponent wzdłuż zielonej linii odstępów między rzędami ma wpływ na wynik; każde wyjście leży na pomarańczowej linii przestrzeni kolumn.
Ranga macierzy i wymiary czterech podprzestrzeni
Ostatnią koncepcją, której musimy się przyjrzeć, jest ranga macierzy. Widzieliśmy, że macierze o tym samym kształcie mogą mieć różne wymiary podprzestrzenne. Ranga mówi nam, ile niezależnych kierunków zachowuje macierz i wraz ze swoim kształtem określa wymiary wszystkich czterech podprzestrzeni.
W przypadku macierzy z wierszami i kolumnami kolumny definiują przestrzeń wejściową , a wiersze definiują przestrzeń wyjściową . Są to wymiary pełnej przestrzeni wejściowej i wyjściowej, określone przez kształt macierzy.
Każda macierz ma właściwość zwaną rank , która definiuje wspólny wymiar jej przestrzeni wierszy i kolumn: ile niezależnych kierunków rozciągają się wiersze i kolumny. Te dwie przestrzenie mają zawsze ten sam wymiar, nawet jeśli pełna przestrzeń wejściowa i wyjściowa mają różne wymiary.
Odpowiednio, maksymalna liczba liniowo niezależnych wierszy jest zawsze równa maksymalnej liczbie liniowo niezależnych kolumn. Ranga nie może przekraczać liczby wierszy ani liczby kolumn, formalnie .
Rozważmy naszą wcześniejszą macierz :
Jego kształt opisuje transformację z trzech współrzędnych wejściowych na dwie współrzędne wyjściowe: . Jego dwa wiersze są niezależne, więc jego rząd wynosi 2. Przestrzeń wierszy to płaszczyzna wewnątrz , składająca się z wektorów . Przestrzeń kolumn składa się w całości z i składa się z wektorów .
Dlatego przestrzenie wierszy i kolumn mają wymiar dwa, mimo że pełne przestrzenie wejściowe i wyjściowe mają różne wymiary. Przestrzeń wierszy nadal zawiera wektory o trzech współrzędnych; tylko dwie współrzędne mogą różnić się niezależnie. W przestrzeni kolumn te dwie niezależne współrzędne wypełniają całą przestrzeń wyjściową.
Zacienione płaszczyzny mają ten sam wymiar, ale żyją w różnych przestrzeniach otoczenia. Etykiety oznaczają wiersze w przestrzeni wejściowej ; oznacza kolumny w przestrzeni wyjściowej , z na początku. Cieniowanie pokazuje część każdej nieskończonej płaszczyzny.
W tabeli porównano pełne przestrzenie wejściowe i wyjściowe z przestrzeniami wierszowymi i kolumnowymi tej macierzy:
| Przestrzeń | Gdzie mieszka | Jego wymiar |
|---|---|---|
| Przestrzeń wejściowa | 3 | |
| Przestrzeń wierszowa | Płaszczyzna wewnątrz : wektory | 2 |
| Przestrzeń wyjściowa | 2 | |
| Miejsce na kolumnę | Wszystkie : wektory | 2 |
Ta macierz zachowuje pierwsze dwie współrzędne i pomija trzecią:
Możemy to zapisać jako , używając krotki jako skrótu wektora kolumnowego. Na przykład zarówno , jak i są mapowane na . Składnik przestrzeni wierszy jest odwzorowywany na , podczas gdy składnik przestrzeni zerowej jest odwzorowywany na zero.
To pozostawia na wejściu jeden kierunek zerowy: trzecią oś współrzędnych. Po stronie wyjściowej przestrzeń kolumnowa już wypełnia całą , zatem jej prostopadłe uzupełnienie — lewa przestrzeń zerowa — zawiera tylko wektor zerowy i ma wymiar zerowy.
To samo rozliczanie wymiarów działa dla dowolnej macierzy o randze : każda przestrzeń wierszowa i kolumnowa ma wymiar , przestrzeń zerowa ma wymiar , a lewa przestrzeń zerowa ma wymiar .
Kształt wyznacza granicę; wpisy określają rangę. Inna macierz może mieć rangę 1. Jej pełne przestrzenie wejściowe i wyjściowe nadal będą wynosić i , ale jej przestrzenie wierszy i kolumn będą liniami. Jej przestrzeń zerowa miałaby wówczas wymiar , a lewa przestrzeń zerowa miałaby wymiar .