Векторная декомпозиция и подпространства: что читает и стирает матрица
Один из наиболее полезных способов просмотра вектора — это комбинация векторов-компонентов. Эта перспектива помогает нам понять матричные преобразования. Вместо того, чтобы спрашивать только, что матрица делает со всем входным вектором, мы можем спросить, что она делает с каждым компонентом. Поскольку преобразование является линейным, преобразованные компоненты в сумме дают тот же результат, что и преобразование всего вектора. Некоторые компоненты могут сильно влиять на результат, некоторые могут быть ослаблены или перенаправлены, а некоторые могут быть полностью проигнорированы.
Для нейронных сетей эта перспектива особенно полезна, поскольку векторы активации часто содержат сразу много видов информации. Конкретная весовая матрица не обязательно использует всю эту информацию. Поэтому понимание трансформации отчасти становится вопросом определения того, какие направления в пространстве активации имеют значение для матрицы, а какие нет.
Один из точных способов провести это различие — использовать пространство строк и нулевое пространство матрицы. Они разделяют входное пространство на направления, которые могут влиять на результат, и направления, которые матрица полностью стирает. Это объясняет, как два разных вектора активации могут давать одинаковый результат при одной и той же весовой матрице.
В предыдущей статье мы исследовали, как весовые матрицы преобразуют векторы и почему нейронным сетям нужны нелинейные активации. В этой статье мы разрабатываем линейную алгебру, необходимую для более внимательного изучения этих преобразований.
Сначала мы рассмотрим, как векторы могут быть построены из других векторов, почему один и тот же вектор можно разложить по разным направлениям и как линейные комбинации и скалярные произведения помогают нам рассуждать о преобразовании. Затем мы изучим четыре фундаментальных подпространства матрицы — пространство строк, нулевое пространство, пространство столбцов и левое нулевое пространство — и будем использовать их, чтобы понять, какие входные компоненты определяют выходные данные, а какие матрица стирает. Сопутствующий эксперимент применяет эту основу на практике путем построения и тестирования проекции.
Это обеспечивает основу для будущих статей, в том числе наш эксперимент MNIST: что читает обученный классификатор. Там скрытый слой создает вектор из 128 значений активации для каждого изображения рукописных цифр. Мы идентифицируем 118 независимых направлений, которые игнорирует обученный выходной слой, удаляем соответствующий компонент вектора активации и сохраняем цифровые оценки классификатора до числового округления.
Построение вектора из компонентов
Матрица определяет линейное преобразование входного пространства в выходное. Его форма определяет количество координат в этих пространствах; его записи определяют, куда идет каждый ввод. В нейронной сети входное пространство — это пространство, в котором живут векторы активации из предыдущего слоя. Выходное пространство — это место, где находятся линейно преобразованные векторы до применения какой-либо нелинейной активации.
Чтобы понять влияние матрицы на вектор, нам нужно посмотреть на компоненты вектора, на которые ее можно разложить. Каждый компонент сам по себе является вектором во входном пространстве, а исходный вектор является их суммой. В соответствии с линейностью матрица преобразует каждый компонент отдельно, и полученные векторы в сумме дают тот же результат, что и непосредственное преобразование исходного вектора. Некоторые компоненты могут быть растянуты, укорочены или направлены в другом направлении, в то время как другие могут отображаться в ноль и полностью исчезнуть.
Вектор имеет множество возможных разложений с использованием координатных осей или направлений, пересекающих несколько осей. В механистическом анализе интерпретируемости и представления такие методы, как PCA/SVD, линейные зонды и разреженные автоэнкодеры, помогают определить полезные направления из данных, выявляя структуру, распределенную по множеству записей вектора активации.
Давайте теперь рассмотрим, как построить вектор из компонентов. Каждая опция в виджете ниже создает один и тот же синий вектор с использованием линейной комбинации различных векторов-компонентов: каждая цветная стрелка представляет собой выбранный вектор, масштабированный с помощью коэффициента, и эти векторы-компоненты в сумме дают . В первом варианте используются три координатных базисных вектора , и . Каждый из них направлен вдоль соответствующей оси координат и масштабируется по соответствующей координате .
(5, 3, 2) = 5(1, 0, 0) + 3(0, 1, 0) + 2(0, 0, 1)
Давайте более внимательно рассмотрим опцию виджета , позволяющую различать базисный вектор, его коэффициент и результирующий векторный компонент. Базисный вектор — это единичный вектор, представляющий направление: его длина равна единице. Скаляр сообщает нам, насколько его масштабировать, а — это фактический компонент вектора. Три векторных компонента складываются в наши входные данные:
Такие координаты, как , часто называют скалярными компонентами. В этой статье компонент вектора означает весь масштабированный вектор, например .
На уровне нейронной сети каждый нейрон выдает одну из этих скалярных координат. Таким образом, коэффициенты виджета , и могут быть выходами трех нейронов для одного входа. Каждая активация масштабирует соответствующий базисный вектор координат, давая вектор компонента вдоль этой оси. Вместе эти векторы компонентов образуют вектор активации слоя , как показано ниже:

Например, нейрон 2 выдает скаляр . Мы представляем его вклад в вектор слоя как . Умножение на и сложение векторов составляющих — это наше математическое описание сборки координат; он не требует дополнительного слоя. Один и тот же является выходом этого слоя и входом следующего слоя.
Матрица весов следующего слоя преобразует эти векторы компонентов, и результаты складываются в новый вектор: . Это линейная часть вычислений следующего слоя до добавления смещения и применения функции активации.
Выходы нейронов предоставляют один из способов разложения вектора активации слоя. Большая часть анализа представлений и механистической интерпретируемости направлена на «более информативную декомпозицию» — направления или подпространства, которые помогают объяснить, что представляет собой сеть и как она использует эту информацию. Математически возможно бесконечно много разложений, поэтому нам нужны критерии и эксперименты, чтобы выявить полезные.
Отделение направления от величины
Отделение направления от величины помогает нам рассуждать о подпространствах и преобразованиях. Векторы, такие как и , занимают одну и ту же строку, несмотря на разную длину. Представление их направления с помощью единичного вектора позволяет скалярным произведениям напрямую измерять длины проекций со знаком и позволяет нам исследовать, как матрица преобразует это направление отдельно от того, какая его часть присутствует во входных данных.
Чтобы сделать это разделение явным, мы запишем компонент вектора как : — единичный вектор, представляющий выбранное направление, а — скаляр со знаком, указывающий, какую его часть следует включить. В нашем примере и . Поскольку длина никогда не бывает отрицательной, мы используем абсолютное значение для выражения длины компонента. Отрицательный знак в означает, что компонент указывает в направлении, противоположном .
Как мы можем выразить компонент как скаляр, умноженный на единичный вектор, если мы знаем только его координаты? Для любого ненулевого вектора вычислите его длину и разделите каждую координату на эту длину. Это нормализация:
Если указывает в том же направлении, что и , становится положительным. Если вместо этого мы сначала зафиксируем единичное направление, компонент, направленный напротив него, будет иметь отрицательный коэффициент.
Мы можем продемонстрировать нормализацию, используя вектор, уже имеющийся в виджете. Одним из векторов в наборе является , который указывает на все три оси координат. Изначально его коэффициент , поэтому зеленая составляющая — . Эти векторы имеют разную длину, но одинаковое направление.
Чтобы представить их общее направление с помощью единичного вектора, мы могли бы использовать нормализацию L2. Нормализация масштабирует вектор до общей длины , сохраняя при этом его направление. Сначала мы вычисляем длину , возводя его координаты в квадрат, складывая их и извлекая квадратный корень. Затем мы делим каждую координату на эту длину. Масштабирование всех координат на одну и ту же положительную величину сохраняет направление:
Результирующий вектор имеет длину . Таким образом мы можем нормализовать любой ненулевой вектор; нулевой вектор не имеет направления и не может делиться на свою длину.
Умножение на исходную длину восстанавливает базисный вектор: . Таким образом, зеленый компонент виджета можно записать так:
Коэффициент равен , когда мы масштабируем , и , когда мы масштабируем единичный вектор . Сам компонент остается неизменным. Перемещение первого ползунка масштабирует этот компонент в том же направлении; отрицательное значение меняет его.
От компонентных векторов к подпространствам
До сих пор мы выбрали коэффициенты для построения одного вектора. Сохраняя векторы, которые мы объединяем, фиксированными, мы можем варьировать эти коэффициенты для всех действительных чисел, чтобы построить полный набор векторов. Этот набор является их промежутком и образует подпространство.
В виджете ниже фиксированные векторы и охватывают плоскость. Зеленые и розовые стрелки показывают их масштабированные компоненты, а синий вектор — их сумму. Когда вы меняете коэффициенты, синий вектор перемещается внутри плоскости, показывая разные элементы одного и того же подпространства. Он не добавляет независимого направления, поскольку полностью построен из двух фиксированных векторов.
Попробуйте изменить два коэффициента, помеченные как и , в виджете выше. Синий вектор перемещается внутри заштрихованной плоскости. Векторы вне этой плоскости не могут быть получены путем объединения двух наших фиксированных векторов, какие бы коэффициенты мы ни выбрали. Выберите , чтобы увидеть один такой пример: оранжевый маркер .
Затененный участок показывает часть промежутка наших двух фиксированных векторов: бесконечную плоскость, содержащую все их возможные линейные комбинации. Целочисленные ползунки виджета отображают только некоторые из этих комбинаций; позволяя и принимать любые действительные значения, достигается каждый вектор на плоскости. Каждый результат имеет вид:
В более общем смысле для фиксированных векторов и мы пишем:
Весь этот диапазон представляет собой подпространство , окружающего трехмерного векторного пространства. Одно разложение выбирает определенные коэффициенты и создает один вектор; подпространство содержит каждый вектор, который могут построить наши фиксированные остовные векторы. Он содержит нулевой вектор, и масштабирование или добавление векторов внутри него всегда дает другой вектор из того же набора. В нашем примере вся плоскость является подпространством, и каждый синий вектор является его членом.
Наши два независимых вектора охватывают плоскость, проходящую через начало координат. Вектор лежит в этой плоскости, потому что мы можем построить его с помощью . Но недостижима: обнуление первых двух координат приводит к тому, что делает нулевой и третью. Чтобы достичь каждого вектора в 3D, нам понадобится третий вектор вне плоскости. Каждый из более ранних виджетов и предоставляет по три независимых вектора, поэтому их диапазоны заполняют весь .
Один и тот же вектор может принадлежать разным подпространствам. Например, может быть построен как , компоненты которого охватывают плоскость , или как , компоненты которого охватывают плоскость . Бесконечно множество плоскостей, проходящих через начало координат, содержат один и тот же вектор.
Таким образом, вектор не определяет уникальное большее подпространство. Однако как только мы зафиксируем охватывающие векторы, их диапазон будет определен однозначно. В виджете выше обе плоскости содержат ось . Синий вектор и его конечная точка лежат в обеих плоскостях. Каждый заштрихованный участок является частью бесконечной плоскости.
Подпространства дают нам возможность изучать структуру представлений нейронных сетей. Подпространство может быть связано с объектом или группой связанных объектов: его охватывающие векторы определяют направления, в которых представление может изменяться, а изменение их коэффициентов создает компоненты, которые могут кодировать различные значения объекта. Однако векторы, охватывающие подпространство, не обязательно представляют собой отдельные объекты, такие как цвет или форма. Нам нужны эксперименты, чтобы выяснить, какую информацию они представляют, если таковая имеется.
Исследователи проверили подобные интерпретации экспериментально. Исследование Отелло определило направления, кодирующие состояние доски, и изменило поведение модели, изменив активации вдоль них. Другое исследование обнаружило, что дни и месяцы расположены примерно в кругах внутри двумерных подпространств активации; вмешательства изменили прогнозы по арифметическим задачам на день и месяц. Плоскость — это подпространство, а позиции вокруг круга представляют значения признаков. Эти эксперименты доказывают, что модели используют идентифицированные представления, не подразумевая, что каждая точка в подпространстве имеет значимую интерпретацию.
В приведенных выше примерах мы видели, как два вектора охватывают плоскость и как вектор вне этой плоскости остается недостижимым, независимо от выбранных нами коэффициентов. Теперь интересный вопрос: что определяет геометрию этого промежутка: почему именно плоскость, а не линия или все трехмерное пространство, и что определяет, какую плоскость мы получим? Чтобы ответить на этот вопрос, нам нужно отличить количество координат от количества независимых направлений.
Три координаты не требуют трех независимых направлений
Если мы построим вектор в путем сложения векторов компонентов, каждый компонент также будет иметь три координаты. Наличие трех координат говорит нам, что векторы живут в трехмерном пространстве; оно не сообщает нам размерность подпространства, которое они охватывают. Размерность промежутка зависит от того, сколько из выбранных векторов линейно независимы.
Рассмотрим два независимых вектора: и . Их комбинации имеют вид . Поскольку третья координата всегда равна нулю, эти векторы заполняют плоскость . Они могут построить , но не . Теперь замените второй вектор на :
Пролет по-прежнему представляет собой плоскость, теперь наклоненную так, что . Например, в нем лежит . Двумерное подпространство в трехмерном пространстве не требует, чтобы одна координата была равна нулю. Вектор может иметь три ненулевые координаты и при этом лежать в этой плоскости: третья координата привязана ко второй, оставляя только два независимых выбора.
Сравните плоскую и наклонную плоскости ниже. Изменение коэффициентов перемещает синие векторы в пределах их плоскостей; ни одна конструкция не может достичь отмеченной красной цели.
Добавление третьего вектора вне этой плоскости, например , позволяет нам построить любой вектор из , выбрав подходящие коэффициенты:
Теперь мы можем построить любой целевой вектор . Наша комбинация дает , поэтому мы выбираем и , чтобы они соответствовали первым двум координатам, затем , чтобы соответствовать третьей. Например, чтобы построить , выберите , и . Третий вектор, уже находящийся в плоскости, не добавит независимого направления.
Следующий виджет показывает это расширение, начиная с плоской плоскости: добавление придает правой конструкции третье независимое направление. С тремя свободно выбранными коэффициентами эта конструкция может достичь любого вектора из . Начальные значения , и достигают целевого значения . Переместите , чтобы изменить его третью координату, не меняя первых двух.
С точки зрения анализа представлений общее подпространство, в данном случае плоскость, может рассказать нам кое-что о наборе представлений. Чтобы связать эту геометрию с нейронной сетью, рассмотрим, что происходит, когда она обрабатывает несколько разных входных данных. Мы можем собрать векторы активации из одного и того же слоя в матрицу активации с одним входом на строку и одним нейроном на столбец. Анализ этой матрицы может выявить, лежат ли собранные активации в общем подпространстве более низкой размерности.
Предположим, что три изображения создают векторы активации , и . Все три могут быть построены из одних и тех же двух фиксированных векторов, и :
Таким образом, все три активации лежат в одной плоскости, несмотря на то, что каждая из них имеет три координаты. Охватывающие векторы остаются фиксированными; только их коэффициенты меняются от изображения к изображению.
Когда мы пропускаем разные изображения через один и тот же слой, каждое изображение создает свой собственный вектор активации. Чтобы проверить, находятся ли эти векторы в одной плоскости, мы спрашиваем, могут ли одни и те же два остовных вектора построить каждый из них. Нахождение плоскости, содержащей вектор активации одного изображения, не говорит нам, лежат ли в ней векторы активации других изображений.
Далее давайте посмотрим, что произойдет, если мы организуем наши векторы построения в виде столбцов матрицы.
Линейные комбинации: построение вывода из столбцов
Представьте себе два набора возможных векторов. Мы называем их входным пространством и выходным пространством. Матрица определяет функцию отображения между ними: она принимает входной вектор и создает выходной вектор . Это отображение является линейным преобразованием.
Если мы посмотрим, как формирует выходные данные, мы увидим, как каждый столбец вносит свой вклад в вектор компонентов. Каждый столбец находится в выходном пространстве и масштабируется по соответствующей координате — выходу одного нейрона предыдущего слоя. Ранее мы видели, как активации нейронов масштабируют базисные векторы координат, чтобы сформировать вектор активации слоя. При передаче на следующий уровень те же самые активации масштабируют столбцы , которые служат векторами, которые мы объединяем для построения выходных данных. Сумма этих масштабированных столбцов равна , что делает результат линейной комбинацией столбцов матрицы.
Записав столбцы как , а входные координаты как , мы можем выразить эту конструкцию как:
В нейронной сети — это весовая матрица слоя, а — вектор активации, предоставленный предыдущим слоем. Каждая координата масштабирует соответствующий столбец , создавая вектор компонента выходных данных.
Виджет ниже следует этой конструкции по одному столбцу за раз. Каждая координата входного сигнала масштабирует соответствующий столбец для создания вектора компонента. Выберите , чтобы проследить, как каждая входная координата масштабирует свой столбец. Соответствующая стрелка выделяет этот шаг, в то время как все три вклада складываются в преобразованный результат .
Эти компоненты позволяют нам отслеживать, как отдельные входные координаты влияют на результат. Чтобы изучить объект, распределенный по нескольким координатам, мы можем вместо этого разложить входные данные по направлениям, связанным с этим объектом, и изучить, как преобразует эти компоненты.
Столбец: каких выходов может достичь матрица?
Матрица не обязательно достигает каждого вектора в выходном пространстве; он может отображать все входные векторы в меньшее подпространство, например плоскость в трехмерном пространстве. Ранее мы видели, как фиксированный набор векторов-компонентов может создавать только векторы, лежащие в пределах их диапазона, образующего подпространство. Для матрицы это подпространство достижимых выходных данных называется ее пространством столбцов.
Название происходит от того факта, что столбцы матрицы представляют собой фиксированные векторы, охватывающие подпространство возможных выходных данных.
В более раннем виджете мы построили один и тот же вектор , используя три разных набора векторов компонентов. Теперь рассмотрим каждую конструкцию как матричное преобразование: выбранные нами векторы становятся столбцами , их коэффициенты становятся входным вектором , а — выходным .
Все три конструкции выдают с выбранными коэффициентами, но они не могут все выдавать одинаковый диапазон других выходных данных. Сохраняя каждую матрицу фиксированной и изменяя ее входные данные, мы можем увидеть, какие векторы принадлежат ее пространству столбцов.
Во-первых, давайте начнем с вектора под опцией . Мы построили как . Три координатных вектора становятся столбцами , а коэффициенты масштабирования становятся элементами :
Поскольку является единичной матрицей, входные данные остаются неизменными: .
Входной вектор имеет три координаты, поэтому входное пространство — . Каждая координата масштабирует один столбец . Эти три столбца охватывают весь , поэтому эта матрица может достигать каждого вектора в выходном пространстве.
Давайте теперь рассмотрим вариант . Строим тот же вектор, что и . Столбцами теперь являются , и с входными коэффициентами :
Входное и выходное пространство по-прежнему имеют вид . Эти три столбца также независимы, поэтому их линейные комбинации могут создавать каждый выходной вектор. Мы изменили векторы построения и входные коэффициенты, но по-прежнему можем достичь всех .
Что-то интересное получается, когда мы пробуем вариант . Тот же вектор теперь строится только с помощью двух векторов построения: . Это означает, что наша матрица преобразования имеет только два столбца. Его вход содержит два коэффициента :
Входное пространство теперь равно , поскольку мы предоставляем только два коэффициента. Выходное пространство остается , поскольку каждый выход по-прежнему имеет три координаты: . Однако независимых вариантов всего два: и , хотя результат имеет три координаты. Форма матрицы ограничивает доступное подпространство в выходном пространстве максимум двумя измерениями.
Два выбранных нами вектора построения и, следовательно, соответствующие столбцы матрицы независимы, поэтому они охватывают плоскость, проходящую через начало координат, а их значения определяют, какая это плоскость. В предыдущих примерах столбцы охватывали все трехмерное выходное пространство. В этом случае, имея всего два вектора, мы все равно можем достичь того же вектора , но только потому, что он лежит в плоскости, которую они охватывают, — пространстве столбцов матрицы. Векторы за пределами этой плоскости остаются недостижимыми.
В таблице ниже сравниваются три конструкции: какие входные векторы принимает каждая матрица и какие выходные векторы она может создавать. Все три имеют одно и то же трехмерное выходное пространство, но только некоторые матрицы могут создавать каждый вектор в этом пространстве.
| Вариант виджета | Входное пространство: коэффициенты | Столбец: доступные выходные данные |
|---|---|---|
| Координатная основа | Все | |
| Другая основа | Все | |
| Два вектора | Самолет внутри |
Мы видели, как наличие только двух столбцов ограничивает достижимые выходные данные максимум до плоскости. Интересно, что наличие трех столбцов не гарантирует, что матрица сможет охватить все трехмерное выходное пространство. Столбцы также должны быть линейно независимыми.
В следующей матрице первые два столбца идентичны, поэтому второй столбец не добавляет нового направления. Столбцы и независимы и составляют основу плоскости достижимых выходов:
Мы можем математически понять, почему эти три столбца дают результаты только в двух независимых направлениях. Давайте запишем вход как , а выход как . Начиная с , первые две входные координаты масштабируют один и тот же вектор-столбец:
Если мы допустим и , каждый возможный результат будет иметь вид:
Мы видим, что каждый выход определяется двумя значениями: и , причем третья координата всегда равна сумме первых двух. Все векторы с этим отношением образуют плоскость, которая является пространством столбцов матрицы. Размерность зависит от количества независимых направлений, а не от количества столбцов.
Скалярное произведение: построение вывода по одной строке за раз
В предыдущем разделе мы увидели, как столбцы матрицы формируют выходные данные из масштабированных векторов. Давайте теперь посмотрим на то же преобразование через строки матрицы и рассмотрим, как вектора компонентов входных данных вносят вклад в каждую выходную координату. Как объясняется в разделе как нейроны работают вместе при преобразовании вектора, каждая строка весовой матрицы принимает скалярное произведение со всем входным вектором, создавая одну выходную координату.
Виджет ниже следует за расчетом по одной строке за раз. Выберите каждую строку, чтобы увидеть, как ее веса получают скалярное произведение со всем входным значением , образуя одну координату выходного значения .
Давайте сосредоточимся на первом ряду. Его скалярное произведение на все входные данные дает скаляр :
Линейность позволяет нам выразить это скалярное произведение как сумму вкладов векторов компонентов входных данных. Чтобы увидеть, откуда берутся , и , разделите входные данные на компоненты координат:
Для первой строки линейность дает:
Каждый компонент вносит один скалярный вклад в эту выходную координату:
Их сложение дает , точно такой же результат, как и непосредственное вычисление .
Повторение этого расчета для каждой строки дает один скалярный результат для каждой строки. Сбор этих результатов дает выходной вектор . Для каждой строки скалярное произведение всех входных данных дает тот же результат, что и сложение скалярных произведений с его компонентами.
Это работает при любом разложении входных данных: если , то , даже если компоненты указывают в других направлениях.
Геометрически мы можем спроецировать каждый компонент на одну и ту же линию — направление вектора-строки — и добавить эти проекции со знаком. Их сумма равна проекции всего ввода. Компонент, частично направленный вдоль , вносит положительный вклад, частично направленный против него - отрицательный, а перпендикулярный компонент - нулевой.
Чтобы наглядно увидеть эти проекции, в следующем виджете используется двухмерный пример с единичной строкой , направленной вдоль горизонтальной оси. Зеленый вектор и розовый вектор являются двумя составляющими векторами. Синий вектор — это объединенный вектор, который они создают.
Пунктирные линии соединяют конечную точку каждого вектора с его проекцией на горизонтальную ось. Цветные стрелки вдоль этой оси показывают спроецированные векторы: зеленые для , розовые для и синие для их суммы . Эти стрелки проекций могут перекрываться. Проекция, направленная вправо, вносит положительный вклад, направленная влево – отрицательная, а нулевая проекция не дает ничего. Поскольку длина равна единице, каждая длина проекции со знаком равна соответствующему скалярному произведению с .
Перетащите конечную точку любого компонента или измените его координаты, чтобы увидеть обновление комбинированного вектора и его проекций. Попробуйте , и , чтобы увидеть отрицательные, нулевые и отменяющие вклады.
Виджет использовал единичную строку, поэтому длина проекции со знаком каждого компонента вносила его вклад в выходные данные. Строка весовой матрицы не обязательно должна иметь длину, равную единице: ее длина масштабирует каждый вклад. Поэтому, чтобы понять, какой вклад вносит каждый компонент, нам необходимо учитывать как его длину, так и выравнивание по строке.
Для направления единичной строки скалярное произведение представляет собой длину проекции со знаком компонента . Использование само по себе умножает эту длину на :
где — угол между компонентом и направлением строки. Для нашей строки , длина которой равна :
- имеет длину и выравнивание , что дает вклад .
- имеет длину и выравнивание , что дает вклад .
- имеет длину и выравнивание , что дает вклад .
Отсюда мы видим, что третий компонент наиболее тесно связан с : у него самый большой косинус и, следовательно, наименьший угол к направлению строки. Но первый компонент вносит больший вклад, потому что он длиннее. Каждый входной компонент вносит свой вклад в соответствии со своей длиной и выравниванием по направлению строки, а линейность позволяет нам добавлять эти вклады со знаком, чтобы получить реакцию строки на весь входной вектор.
Строки и столбцы дают два способа вычисления одного и того же преобразования:
| Столбцы | Строки | |
|---|---|---|
| Where the vectors live | Output space | Входное пространство |
| Role in multiplication | Масштабируйте и добавляйте, чтобы получить результат | Каждый из них требует скалярного произведения для вычисления одной выходной координаты |
Пространство строк и пустое пространство: что матрица читает и игнорирует
Начнем с двух векторов и . Они независимы, а их линейные комбинации имеют вид
Их пролет — это плоскость , все ее векторы имеют форму , как показано в виджете ниже.
Теперь представьте, что у нас есть синий вектор и мы хотим проверить, лежит ли он в этом подпространстве. Один из способов разложить его на зеленый компонент и розовый компонент .
Обратите внимание, что зеленая компонента лежит в плоскости, а розовая компонента и синий вектор — вне ее. Зеленый компонент лежит в плоскости, поскольку его можно построить из двух охватывающих его векторов и .
Теперь предположим, что мы используем два фиксированных вектора и в качестве строк матрицы:
В этом случае каждая строка представляет собой вектор, который мы можем использовать в линейной комбинации. Вместе эти векторы охватывают подпространство входного пространства, известное как пространство строк. Таким образом, плоскость виджета является пространством строк этой матрицы.
Давайте теперь попробуем другое разложение того же синего вектора, используя зеленый компонент и розовый компонент . Зеленый цвет по-прежнему лежит в плоскости пространства строк, но розовый теперь направлен перпендикулярно ему, как показано в виджете ниже.
Давайте рассматривать синий вектор как входные данные и исследуем, как его компоненты вносят вклад в выходные данные при каждом разложении. Матрица выдает один и тот же результат в обоих случаях, но компоненты в каждом разложении вносят в нее разный вклад.
При первом разложении мы можем вычислить вклад каждого компонента, взяв его скалярное произведение с каждой строкой . Каждый результат дает одну координату вклада этого компонента в выходные данные.
| Зеленый компонент | Pink component | |
|---|---|---|
| Скалярное произведение со строкой 1 | ||
| Скалярное произведение со строкой 2 | ||
| Вклад в результат |
Третья координата ни одного компонента не влияет на выходные данные, поскольку обе строки матрицы имеют нулевую третью координату. По линейности вклады зеленого и розового цвета складываются в результат:
Во втором разложении зеленый вносит весь вклад, а розовый ничего не дает:
| Зеленый компонент | Pink component | |
|---|---|---|
| Скалярное произведение со строкой 1 | ||
| Скалярное произведение со строкой 2 | ||
| Вклад в результат |
Как и в первом разложении, третья координата ни одного компонента не влияет на выходные данные, поскольку обе строки матрицы имеют нулевую третью координату. По линейности вклады зеленого и розового цвета складываются в результат:
Обратите внимание на разницу между двумя разложениями: первый розовый компонент по-прежнему вносит вклад в результат, а второй ничего не дает. Это происходит потому, что второй розовый компонент перпендикулярен обеим строкам и, следовательно, всему пространству строк. Мы можем видеть это в виджетах и в вычислениях скалярного произведения в таблицах. В первом случае розовый компонент имеет скалярное произведение и с двумя строками, тогда как во втором случае оба скалярных произведения равны нулю. Это показывает, что нахождение за пределами пространства строк не означает, что вектор полностью игнорируется; быть перпендикулярным каждой строке.
Нулевое пространство: входные данные, которые ничего не дают
Мы видели, что второй розовый компонент, , не вносит никакого вклада, поскольку он перпендикулярен каждой строке. То же самое относится и к каждому вектору вдоль оси : изменение его длины или изменение направления все равно оставляет оба скалярных произведения равными нулю.
Набор всех входных векторов, которые матрица отображает в ноль, называется ее нулевым пространством. Для матрицы, которую мы использовали в предыдущих разделах, этот набор представляет собой всю ось . Первый розовый компонент находится в пустом пространстве; второе целиком лежит в нем.
В обоих случаях нулевой компонент входных данных — . Вторая декомпозиция явно изолирует его, окрашивая весь компонент пространства строк зеленым цветом. Входные данные имеют множество возможных декомпозиций, но их разделение на компонент пространства строк и компонент нулевого пространства является уникальным.
Таким образом, мы можем взять любую матрицу и входные данные, которые она принимает, и определить, какую часть этих входных данных матрица игнорирует, а какая часть влияет на выходные данные. Существует только один способ разделить входные данные так, чтобы одна часть полностью находилась в пространстве строк, а другая — в пустом пространстве.
Для нашей матрицы и ввода это именно второе разложение, показанное в наших виджетах и таблицах:
Альтернативная декомпозиция создает тот же входной сигнал, но его второй компонент не полностью находится в пустом пространстве. Для этого примера расчет прост; для общей матрицы такие методы, как SVD, позволяют систематически вычислять разделение.
Вектор отображается в ноль, когда он перпендикулярен каждой строке и, следовательно, каждому вектору в пространстве строк. Нулевое пространство — это перпендикулярное дополнение пространства строк, которое мы пишем как:
Символом обозначаются все векторы, перпендикулярные каждому вектору в этом пространстве. Разделение ввода на эти две части дает:
Итак, показывает, что на результат влияет только компонент пространства строк. Матрица по-прежнему может менять свою длину и направление или отображать ее в выходное пространство с другим количеством координат.
Левое пустое пространство: перпендикулярно всем возможным выводам
Предположим, что весовая матрица слоя имеет третью строку, равную сумме первых двух строк. Это приводит к ограничению вывода: третья координата всегда равна сумме первых двух. Независимо от того, какие входные данные мы ему даем, он не может выдать , потому что первые две координаты потребуют, чтобы третья была . Левое пустое пространство помогает нам определить подобные ограничения на выходе слоя.
Как мы видели ранее, пространство столбцов содержит все возможные выходные данные. Левое пустое пространство описывает направления, перпендикулярные всем из них. Точно так же, как нулевое пространство перпендикулярно пространству строк во входном пространстве, левое нулевое пространство перпендикулярно пространству столбцов в выходном пространстве.
В нашем предыдущем примере с пространством столбцов каждый вывод имеет форму . Третья координата всегда равна сумме первых двух. Вектор фиксирует это ограничение:
Он лежит в левом пустом пространстве, поскольку перпендикулярен всем возможным выводам. Цель, такая как , нарушает это ограничение, поэтому никакие входные данные не могут заставить эту матрицу создать ее. Одно только изменение ввода не может исправить это несоответствие.
Это придает левому пустому пространству практическую роль: оно выявляет ограничения на то, что может создать матрица с фиксированным весом. Для слоя линейного прогнозирования оно может сказать нам, что некоторые целевые выходные данные недостижимы даже до того, как мы попытаемся найти входные данные, которые их создают. Эти ограничения применяются к линейному выходу ; добавление смещения сдвигает их на для , а последующая нелинейная активация может изменить их дальше.
Важно подчеркнуть, что левое пустое пространство — это не то место, куда отправляются стертые входные данные; эти входы сопоставляются с началом координат. Он описывает ограничения на стороне вывода.
Соединение четырех подпространств вместе
Теперь мы можем соединить четыре пространства в одну картинку. Пространство строк и пустое пространство разделяют входные данные на перпендикулярные компоненты. Матрица отправляет компонент нулевого пространства в ноль и преобразует компонент пространства строк в выходные данные в пространстве столбцов. Левое нулевое пространство перпендикулярно каждому вектору в этом выходном подпространстве.
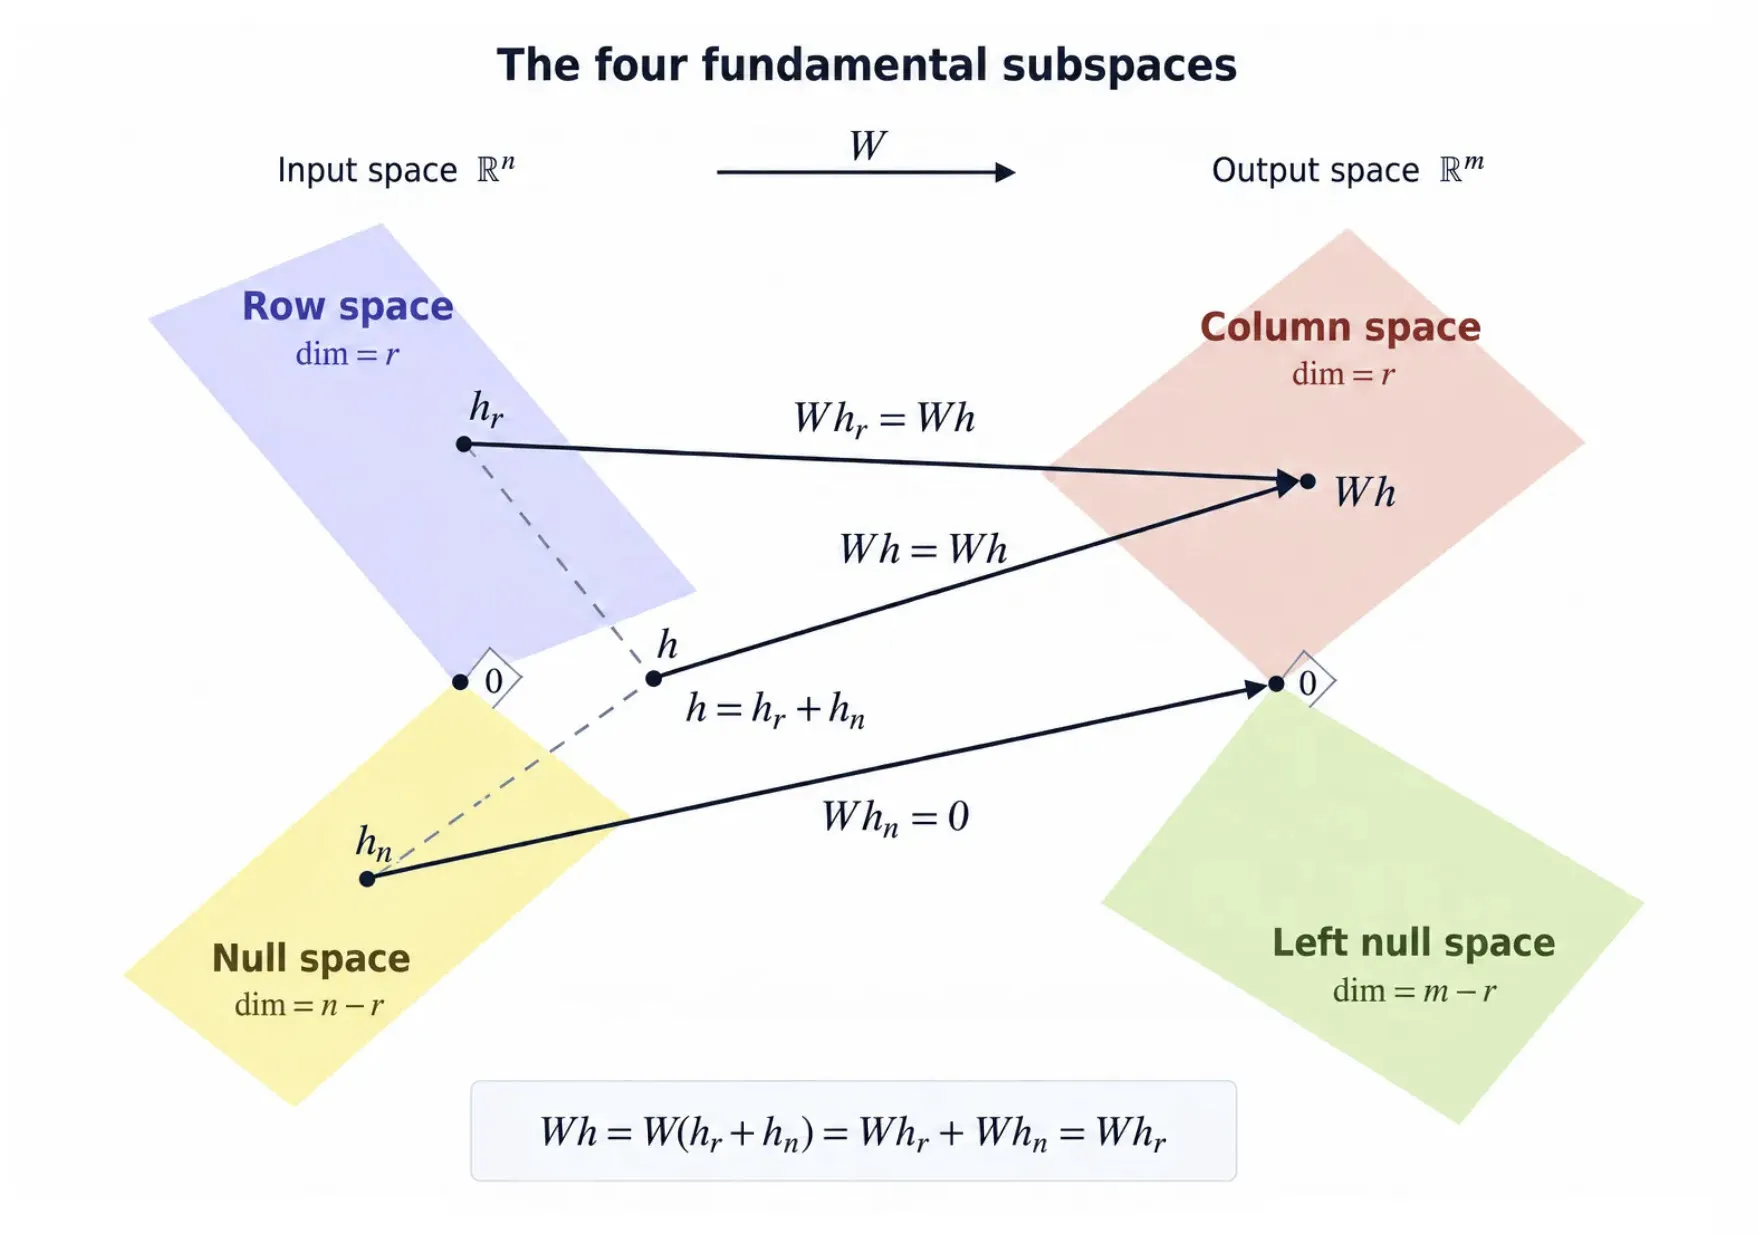
Изображение показывает, как связаны четыре подпространства, но его плоские участки схематичны: подпространство может быть линией или плоскостью, в зависимости от матрицы. Два виджета ниже конкретизируют эти отношения. Вы можете изменить входные данные и увидеть, как они разбиваются на компоненты пространства строк и нулевого пространства, а также как каждый компонент вносит свой вклад в выходные данные.
Давайте теперь исследуем эти отношения в виджете ниже. Он использует входной вектор и матрицу:
Начальный вход находится за пределами как плоскости строки, так и линии нулевого пространства. В каждом из них есть свой компонент. Три ползунка управляют входными координатами , и . Их изменение меняет вектор, который преобразует матрица, в то время как сама матрица остается неизменной.
Input space · ℝ³
Row space is a plane, Null space is a line
Output space · ℝ³
Column space is a plane, Left null space is a line
Drag either plot to rotate; scroll to zoom. With a plot focused, use the arrow keys to rotate, + and − to zoom, or 0 to reset zoom.
Вот что определяет каждое из четырех подпространств. Параметры , , , и могут быть любыми действительными числами.
| Подпространство | Форма | Vectors it contains | Что это значит |
|---|---|---|---|
| Row space | Самолет | Первые две входные координаты равны (); третий неограничен. | |
| Нулевое пространство | Линия | Первые две входные координаты сокращаются, а третья равна нулю. Эти векторы отображаются в ноль. | |
| Колонка пространства | Самолет | Третья выходная координата представляет собой сумму первых двух (). | |
| Left null space | Линия | Первые две координаты равны, а третья является их отрицательной. Эти векторы перпендикулярны каждому вектору в пространстве столбцов. |
Три карты показывают весь ввод и два его компонента. Применение к компоненту пространства строк дает тот же результат, что и применение его ко всему входу. Компонент с нулевым пространством вносит нулевой вклад, поэтому его добавление или удаление оставляет результат без изменений.
и изображения соответствуют и виджета. Первоначально синий вход разделяется на зеленый и розовый компоненты:
Стрелки, пересекающие изображение, обозначают применение . В виджете и весь ввод, и его зеленый компонент создают , поэтому их выходные стрелки перекрываются в оранжевой плоскости. Розовый компонент отображается в ноль. Фиолетовая линия с левым пустым пространством перпендикулярна выходной плоскости; это не то место, куда идут стертые данные.
Изменение ввода оставляет четыре подпространства фиксированными.
Давайте теперь используем тот же входной вектор с этой альтернативной матрицей:
Он имеет ту же форму , но имеет ранг 1: все его строки кратны . Его пространства строк и столбцов являются линиями, а оба пустых пространства — плоскостями. Начальный ввод находится за пределами как линии пространства строк, так и плоскости нулевого пространства, в каждой из которых есть компонент. Ползунки изменяют входные данные, пока эта матрица остается фиксированной.
Input space · ℝ³
Row space is a line, Null space is a plane
Output space · ℝ³
Column space is a line, Left null space is a plane
Drag either plot to rotate; scroll to zoom. With a plot focused, use the arrow keys to rotate, + and − to zoom, or 0 to reset zoom.
Для этой матрицы четыре подпространства содержат следующие векторы. Опять же, параметрами могут быть любые действительные числа.
| Подпространство | Форма | Vectors it contains | Что это значит |
|---|---|---|---|
| Row space | Линия | Первые две входные координаты равны, а третья равна нулю. | |
| Нулевое пространство | Самолет | Первые две входные координаты отменяются (); третий неограничен. Эти векторы отображаются в ноль. | |
| Колонка пространства | Линия | Вторая и третья выходные координаты в два и три раза больше первой. | |
| Left null space | Самолет | Координаты удовлетворяют . Эти векторы перпендикулярны направлению пространства столбцов . |
Здесь изменение оставляет результат неизменным: третье направление координат лежит в нулевом пространстве. В выходные данные влияет только компонент, расположенный вдоль зеленой линии пространства между строками; каждый вывод лежит на оранжевой линии столбца.
Ранг матрицы и размерности четырех подпространств
Последнее понятие, на которое нам нужно обратить внимание, — это ранг матрицы. Мы видели, что матрицы одинаковой формы могут иметь разные размеры подпространства. Ранг сообщает нам, сколько независимых направлений сохраняет матрица, и вместе с ее формой определяет размеры всех четырех подпространств.
Для матрицы со строками и столбцами столбцы определяют входное пространство , а строки определяют выходное пространство . Это размеры полных входных и выходных пространств, определяемые формой матрицы.
Каждая матрица имеет свойство rank , которое определяет общую размерность ее пространств строк и столбцов: сколько независимых направлений охватывают строки и столбцы. Эти два пространства всегда имеют одинаковую размерность, даже если полные входные и выходные пространства имеют разные размеры.
Аналогично, максимальное количество линейно независимых строк всегда равно максимальному количеству линейно независимых столбцов. Ранг не может превышать ни количества строк, ни количества столбцов, формально .
Рассмотрим нашу предыдущую матрицу :
Его форма описывает преобразование трех входных координат в две выходные: . Две его строки независимы, поэтому его ранг равен 2. Пространство строк — это плоскость внутри , состоящая из векторов . Пространство столбцов представляет собой все пространство , состоящее из векторов .
Следовательно, пространства строк и столбцов имеют общую размерность, равную двум, хотя полные входные и выходные пространства имеют разные измерения. Пространство строк по-прежнему содержит трехкоординатные векторы; только две координаты могут изменяться независимо. В пространстве столбцов эти две независимые координаты заполняют все выходное пространство.
Заштрихованные плоскости имеют одинаковое измерение, но живут в разных окружающих пространствах. Метки обозначают строки входного пространства ; обозначает столбцы в выходном пространстве с в начале координат. Затенение показывает часть каждой бесконечной плоскости.
В таблице сравниваются полные входные и выходные пространства с пространствами строк и столбцов для этой матрицы:
| Космос | Где он живет | Его размер |
|---|---|---|
| Входное пространство | 3 | |
| Row space | Плоскость внутри : векторы | 2 |
| Output space | 2 | |
| Колонка пространства | Все : векторы | 2 |
Эта матрица сохраняет первые две координаты и удаляет третью:
Мы можем записать это как , используя кортеж как сокращение вектора-столбца. Например, и , и соответствуют . Компонент пространства строк отображается в , а компонент нулевого пространства отображается в ноль.
Это оставляет на входе одно направление нулевого пространства: третью ось координат. На выходе пространство столбца уже заполняет все , поэтому его перпендикулярное дополнение — левое нулевое пространство — содержит только нулевой вектор и имеет нулевую размерность.
Тот же учет размерностей работает для любой матрицы ранга : каждое пространство строк и столбцов имеет размерность , нулевое пространство имеет размерность , а левое нулевое пространство имеет размерность .
Форма устанавливает предел; записи определяют ранг. Другая матрица может иметь ранг 1. Ее полные входные и выходные пространства по-прежнему будут и , но ее пространства строк и столбцов будут строками. Тогда его нулевое пространство будет иметь размерность , а его левое нулевое пространство будет иметь размерность .