Відновлення відомих ознак за допомогою двох проєкцій уваги
Чи може крихітна модель уваги навчитися зчитувати ідентифіковані ознаки зі змішаних вхідних координат? Ми можемо перевірити це без навчання мовної моделі: створити дані, характеристики яких ми знаємо, приховати ці функції за допомогою операції лінійного змішування та навчити лише проекцію запиту та проекцію значення.
Цей експеримент містить 54 числа, які можна навчити: дві матриці 9 × 3, Wq і Wv. Кожен запит і значення мають три координати. Після трьох ініціалізацій модель відновила заплановані відповіді функцій на точність з плаваючою комою на нових прикладах оцінки. Видалення відповідних функцій збільшило помилку передбачення, тоді як зміна нерелевантних вхідних даних майже не вплинула на результат.
Результат свідомо контролюється. Фіксовані ключі та цілі прямого виведення закріплюють значення функцій, щоб ми могли їх ідентифікувати. Він демонструє відновлення відомих синтетичних функцій через втрату уваги; це не встановлює, що мовна модель, яка вільно навчається, розвиватиме однаково читабельні координати.
Attention-head article знайомить із запитами, ключами та значеннями. Тут ми використовуємо це обчислення як невелику експериментальну систему.
Завдання: направити запит і повернути три значення
Кожен приклад містить один запит і чотири вихідні записи. Перш ніж приховати функції, кожен вхід має дев’ять незалежних скалярних координат:
| Приховані координати | Роль у завданні |
|---|---|
| Функції запиту 1–3 | Керуйте маршрутизацією, коли цей вхід є запитом |
| Особливості корисного навантаження 1–3 | Надайте значення, які повертаються, якщо цей вхід є вихідним записом |
| Шумові особливості 1–3 | Не має відношення до мети |
Ці мітки описують, як генератор даних використовує числа. Вони не є поняттями природної мови. У вхідному запиті координати корисного навантаження також не мають значення; у вихідних записах координати запиту не мають відношення до розрахунку значення.
Ми малюємо приховані координати з незалежних нормальних розподілів, масштабуючи перші три координати запиту на 1,8, щоб змінити концентрацію уваги. Фіксована випадкова ортогональна матриця R змішує кожен вхід:
Модель бачить дев’ять спостережуваних координат x. Він не отримує ні вихідний вектор ознак z, ні матрицю змішування R. Корисні функції розподіляються по спостережуваних координатах, а не займають призначені вхідні слоти.
Генератор даних також надає чотири фіксовані ключі:
fixed_keys = torch.tensor([
    [ 1.,  1.,  1.],
    [ 1., -1., -1.],
    [-1.,  1., -1.],
    [-1., -1.,  1.],
])
Щоб згенерувати правильну ціль, викладач використовує три оригінальні функції запиту як запит, порівнює його з цими ключами, використовуючи масштабовані скалярні добутки та softmax, і бере відповідне середньозважене значення трьох функцій корисного навантаження записів. Таким чином, мета є трикоординатним вектором.
Студент отримує лише кінцеву ціль, а не проміжні запити вчителя, значення чи ваги уваги. Конструкція вчителя дає нам відому базову істину для оцінки.
Модель: дві вивчені матриці
Модель слідує тому ж обчисленню уваги, але вона повинна навчитися витягувати корисні функції зі змішаних вхідних даних:
q = request @ Wq                          # (batch, 9) → (batch, 3)
V = records @ Wv                          # (batch, 4, 9) → (batch, 4, 3)
A = torch.softmax(q @ fixed_keys.T / 3**0.5, dim=-1)
prediction = (A.unsqueeze(-1) * V).sum(dim=1)
loss = ((prediction - target) ** 2).mean()
Тільки Wq і Wv можна навчати: скаляри 9×3 + 9×3 = 54. Немає навченої таблиці вбудовування, проекції ключа, проекції виходу, зміщення, класифікатора, прямої мережі чи залишкового блоку. Це обмежене завдання з фіксованим ключем, з одним запитом на отримання та чотирма вихідними записами.
Карта запиту повинна вивчати функції запиту, які визначають маршрутизацію. Карта значень має вивчати функції корисного навантаження, які визначають, що повертається. Обидва оптимізуються спільно з використанням остаточної помилки передбачення. Зворотне поширення має знаходити корисні представлення запитів і значень без прямих міток для цих представлень.
Який внесок цінності?
Повне обчислення складається з двох частин:
Запит і ключі визначають, скільки взяти з кожного запису. Значення визначають, яку інформацію надають ці записи. Тут A — рядок із чотирьох вагових коефіцієнтів, V містить чотири вектори значень із трьома координатами, а їхній добуток — це трикоординатний прогноз. Обчислення лише A дає розподіл за записами; множення на V збирає їх інформацію у вивід.
Для невеликої арифметичної ілюстрації припустимо, що ваги та значення:
| запис | Увага вага | Вектор значення | Зважений внесок |
|---|---|---|---|
| 1 | 0.1 | [1, 0, 0] | [0.1, 0, 0] |
| 2 | 0.2 | [0, 2, 0] | [0, 0.4, 0] |
| 3 | 0.3 | [0, 0, 3] | [0, 0, 0.9] |
| 4 | 0.4 | [1, 1, 1] | [0.4, 0.4, 0.4] |
Додавання внесків дає . Це ілюстративні цифри, а не записаний приклад оцінки.
Тепер утримуйте запит і ключі фіксованими та поміняйте перші два вихідних стовпці Wv. Кожен вектор значень міняє свої перші дві координати місцями, тому результат стає . Ваги уваги залишаються незмінними. Модель збирає дані з тих самих записів у тих самих пропорціях, але повертає іншу інформацію. Віджет обміну значеннями у статті, що привертає увагу інтерактивно демонструє цю відмінність.
У нашому експерименті Wv має навчитися витягувати три функції корисного навантаження з дев’яти змішаних координат кожного запису та ігнорувати функції запиту та шуму. Це одна спільна навчена матриця, застосована до всіх чотирьох записів, створюючи чотири обчислені вектори значень на кожному проході. Вектори корисного навантаження не є окремими записами, які можна навчати. Остаточна втрата передбачення вчить Wv, що передавати, а також навчає Wq, як зважувати записи. Оскільки в цьому експерименті немає проекції результату, суміш зважених значень уже є прогнозом; у повному трансформаторному блоці вихідна проекція та залишкове додавання включають головні суміші в поточне представлення.
Навіщо ремонтувати ключі?
У вільно навченій голові зміна базису запиту може бути компенсована зворотною зміною базису ключа. Оцінки уваги залишаються незмінними, тому лише координати запиту не визначаються однозначно. Наш математичний розділ, що привертає увагу пояснює цю неоднозначність.
Виправлення ключів закріплює координати відповідності запиту. Чотири ключі вище є вершинами тетраедра, відмінності яких охоплюють усі три відповідні напрямки. Ми використовуємо чотири ключі, тому що softmax нечутливий до додавання тієї самої константи до кожної оцінки: три ключі можуть обмежувати щонайбільше дві незалежні різниці оцінок, залишаючи напрямок запиту невизначеним у тривимірному просторі запиту.
Пряма ціль із трьома координатами подібним чином закріплює вихідні значення значення. Ми навмисно зробили представлення легшими для ідентифікації, ніж зображення загального трансформатора. Це корисно для цього експерименту: це дозволяє перевірити, чи оптимізація відновлює відомі функції, перш ніж братися за представлення з довільними внутрішніми базами.
Виміряйте значення вивчених карт
Нам відома матриця змішування латентного до спостережуваного, тому ми можемо перевірити вивчені карти в оригінальній основі ознак:
Кожен запис R @ Wq вимірює, як збільшення однієї латентної функції на одну змінює одну координату запиту. Так само R @ Wv вимірює відповідь значення координати. Це пряме вимірювання вивчених лінійних карт без підключення додаткового зонда, який міг би обертати або реміксувати їхні виходи.
Очікувана відповідь на запит читає перші три приховані функції та ігнорує інші шість. Відповідь очікуваного значення зчитує середні три характеристики та ігнорує решта шість. З точки зору підпросторів, карти повинні зчитувати різні тривимірні вхідні підпростори та ігнорувати їхні відповідні перпендикулярні доповнення.
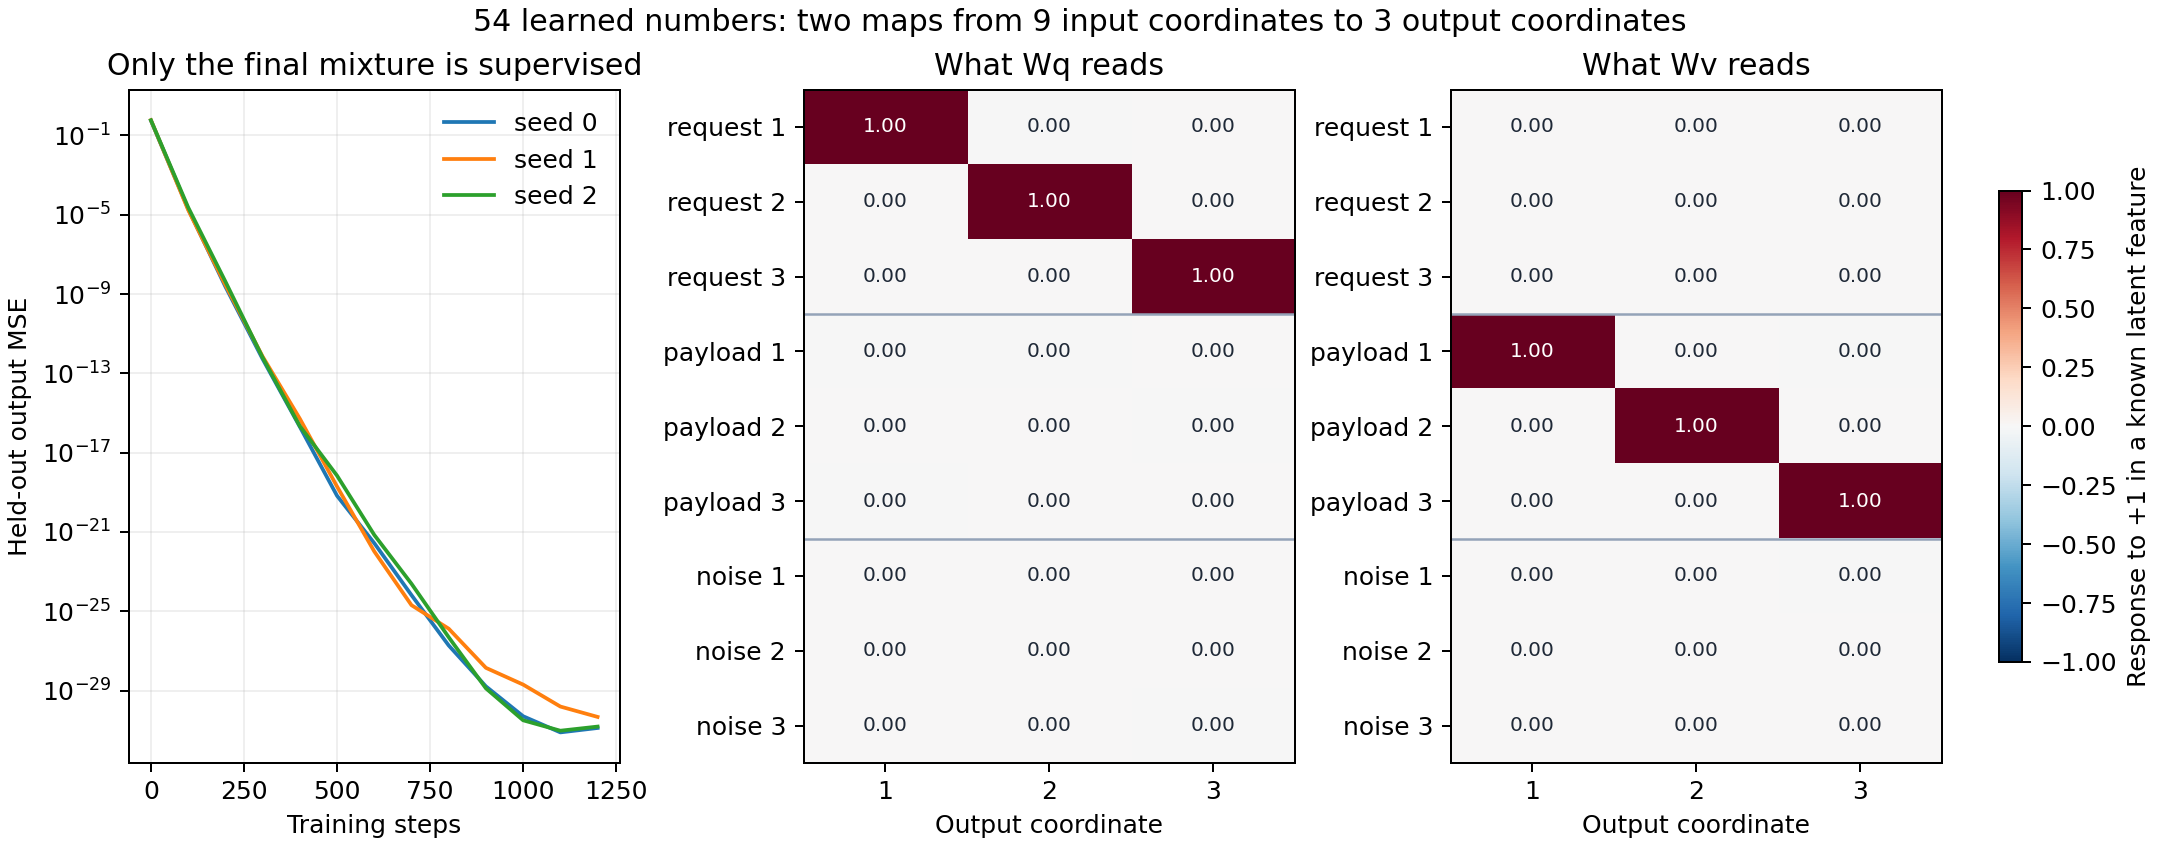
Результати на затриманих прикладах
У перевірених запусках використовувався PyTorch 2.7.1+cpu, арифметика float64, один потік CPU, Adam зі швидкістю навчання 0,03 і 1200 кроків. Для кожного кроку використовувався новий пакет із 128 навчальних прикладів. Кожен цикл також мав 4096 окремих прикладів оцінки; оцінка не контролювала оптимізацію або ранню зупинку.
| насіння | Затриманий прогноз MSE | Рівномірна увага з істинними значеннями: MSE | Найменша координата запиту/значення R² |
|---|---|---|---|
| 0 | 1.30e-31 | 0.332 | вище 0.999999 |
| 1 | 4.70e-31 | 0.332 | вище 0.999999 |
| 2 | 1.53e-31 | 0.334 | вище 0.999999 |
Модель відновила очікувані реакції функції на точність з плаваючою комою. Порівняння рівномірної уваги використовує справжні значення корисного навантаження, надаючи цій базовій лінії правильний вміст, але не залежну від запиту маршрутизацію. Його набагато більша похибка показує, чому просте середнє не вирішує це завдання.
Це безшумні цілі, згенеровані обчисленням, які студент може точно представити. Дуже мала помилка демонструє успішне відновлення в цій конструкції, а не реалістичне очікування точності природних даних.
Чи впливають відновлені функції на прогноз?
Теплова карта відповіді показує те, що читає лінійна карта. Ми також перевіряємо, як ці вхідні дані впливають на остаточний прогноз, втручаючись у відомі латентні координати, а потім застосовуючи ту саму фіксовану матрицю змішування.
| Втручання | Вимірювання по трьох насінинах |
|---|---|
| Стерти функцію одного запиту, зберігаючи початкову ціль фіксованою | Прогноз MSE зростає до 0.139–0.153 |
| Видалити одну функцію корисного навантаження з кожного вихідного запису, зберігаючи початкову ціль фіксованою | Прогноз MSE зростає до 0.188–0.207 |
| Додайте 5 до кожної координати, яка не стосується кожної карти | Прогноз змінюється приблизно від 1e-30 до 7e-30 у MSE |
Перші два втручання видаляють інформацію, яку використовує завдання; діапазони охоплюють усі три варіанти функцій і всі три насіння. Останній змінює нерелевантні вхідні дані: корисне навантаження та координати шуму запиту, а також координати запиту та шуму джерела. Прогноз фактично залишається незмінним.
Разом отримані відповіді на вивченій карті, затримані прогнози та втручання підтверджують точний висновок: ці дві навчені матриці відновлюються та використовують різні відомі набори функцій, ігноруючи нерелевантні вказівки для цього завдання.
Відтворіть експеримент
З кореня репозиторію з інстальованими PyTorch і Matplotlib:
python blog/src/content/drafts/recovering-known-features-with-two-attention-projections/experiment/train_feature_recovery.py
python -m unittest discover -s blog/src/content/drafts/recovering-known-features-with-two-attention-projections/experiment -p 'test_feature_recovery.py' -v
Сценарій записує feature-recovery/results.json, що містить фіксовані ключі, матрицю змішування вхідних даних, необроблені вивчені прогнози, виміряні відповіді функцій, сліди втрат, утримувані метрики та результати втручання. Він також створює фігури PNG і SVG. Тести перевіряють, що лише дві призначені матриці піддаються навчанню, що відоме рішення відтворює вчителя після змішування та що ключові відмінності охоплюють усі три напрямки запиту.
Експеримент робить значення перевіреними через його побудову. Для голови, отриманої з тексту, нам знадобляться незалежні докази, щоб визначити корисні напрямки функцій, врахувати зміни базису та перевірити їх вплив. Attention-head article повертає до більш загального обчислення: зіставлення за допомогою запитів і ключів, а потім змішування інформації, що передається значеннями.