Як голова уваги змішує інформацію
У статті word2vec ми вивчили таблицю векторів слів із контекстів, у яких слова з’являлися під час навчання. Слова зі спорідненим використанням можуть набувати споріднених представлень. Але таблиця має обмеження: пошук слова дає той самий вектор незалежно від пропозиції, у якому воно міститься. Контекст допоміг навчити вектор; пошук не звертається до поточного контексту.
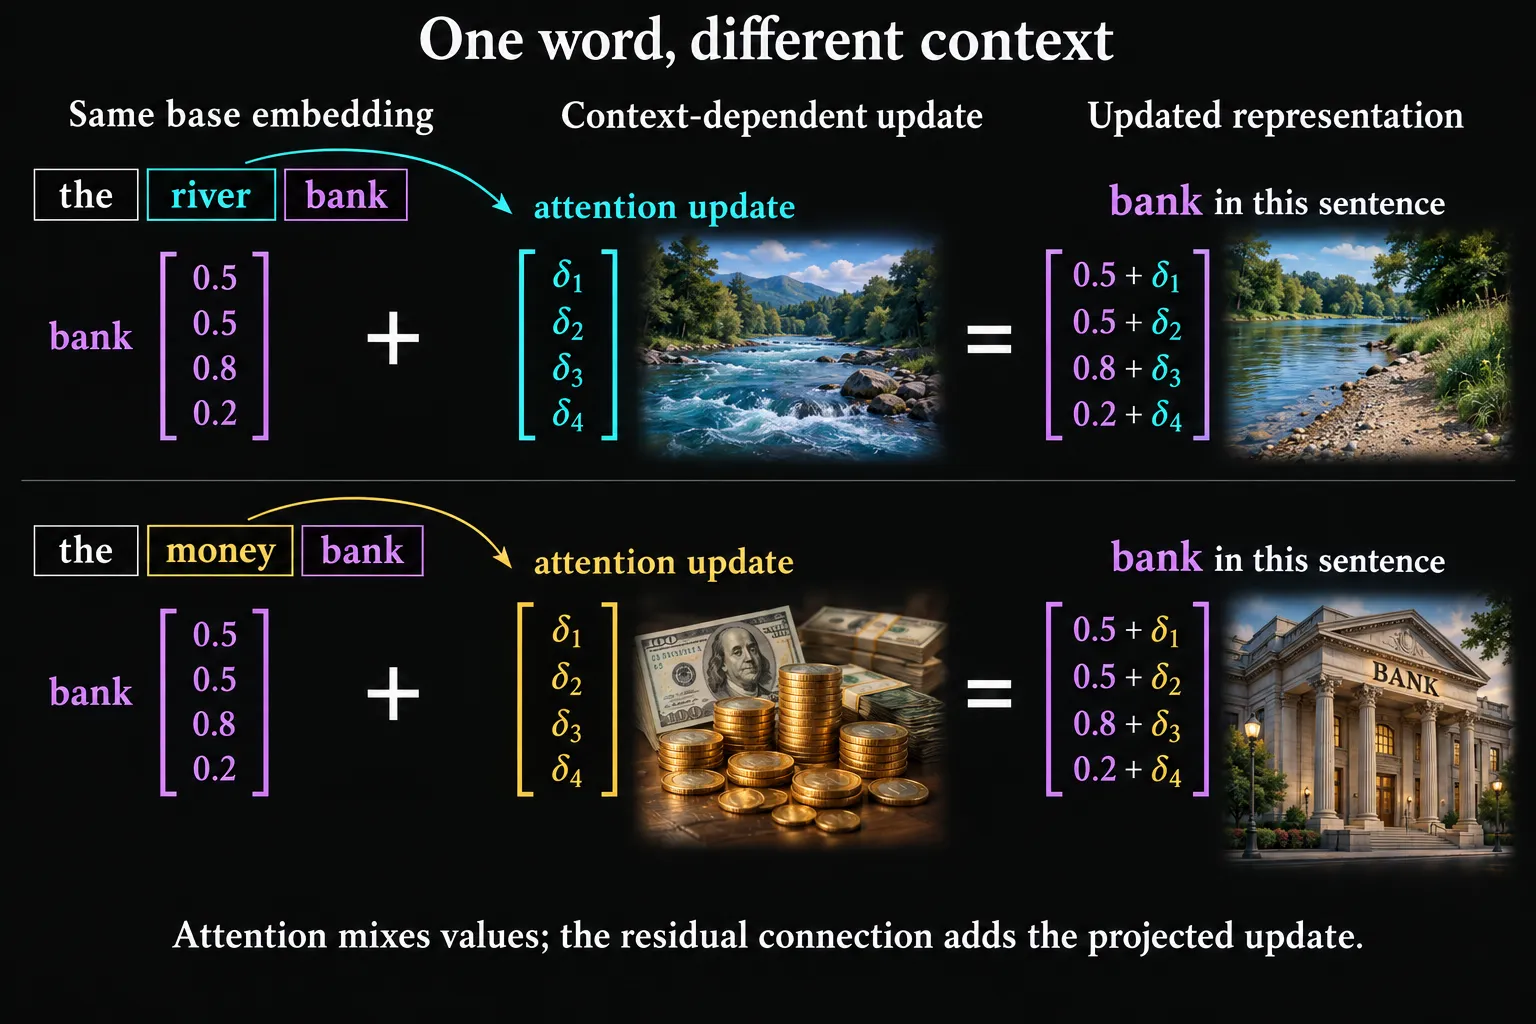
Це проблема полісемії, яку ми залишили. У «берег річки» та «грошовий банк» bank отримує той самий рядок. Його вектор може відображати докази з обох видів використання, але він не говорить нам, до якого використання належить ця подія. Навколишні слова надають цю відсутню інформацію.
Тому нам потрібен крок після пошуку: нехай кожна позиція збирає інформацію з інших позицій у цьому реченні. Голова уваги обчислює зважену суміш інформації, яку вони несуть. Ваги залежать від вхідних даних, тому різні позиції можуть збирати різні суміші. Ціль – це внесок, який допомагає зробити представлення корисним для цього конкретного контексту.
Усередині трансформаторного блоку цей внесок проектується та додається до представлення, яке вже є. Керівник розраховує суміш; залишкове з’єднання містить оновлення. Це дає нам шлях від спільного вектора слів до представлення, збагаченого його поточним оточенням. Наступна стаття будує блок навколо цих оновлень.
Стандартний трансформаторний блок містить кілька головок у своєму багатоголовковому підрівні уваги. Головки всередині блоку працюють паралельно; блоки трансформаторів працюють послідовно. Голови зчитують однакові вхідні представлення та обчислюють окремі суміші, які об’єднуються та проектуються в одне оновлення уваги. Кожен наступний блок отримує оновлені представлення попереднього блоку замість того, щоб знову шукати початкові вектори маркерів.
Тут ми побудуємо одну голову на маленьких векторах: спочатку спостерігаємо за змішуванням інформації, потім дивимося, як навчені проекції контролюють те, що вона збирає, і, нарешті, навчимо крихітну модель використовувати це.
Вам потрібні вектори, скалярний добуток і ідея про те, що множення на матрицю перетворює вектор. Стаття про вагову матрицю розвиває цей останній крок. Наші осі будуть вибрані вручну для читабельності; реальні вбудовування не мають позначених фінансових координат. Ми також сприймаємо кожне слово як один символ у цій іграшці.
Один пас вперед, без тренувань
Дайте чотирьом жетонам по чотири числа кожному. Розміри означають фінанси, воду, структуру та загальний вміст лише в цьому прикладі:
import numpy as np

emb = {
    #           finance water structure generic
    "the":   np.array([0.0, 0.0, 0.0, 1.0]),
    "river": np.array([0.0, 1.0, 0.0, 0.2]),
    "money": np.array([1.0, 0.0, 0.0, 0.2]),
    "bank":  np.array([0.5, 0.5, 0.8, 0.2]),
}
bank починається між фінансами та водою. Ми хочемо обчислити внесок у його позиції, змішуючи інформацію з речення. З трьома маркерами форма цього обчислення така:
Вектори несуть інформацію; сума невід’ємних ваг дорівнює одиниці. Наразі використовуйте самі вбудовування як ці вектори. Відкрите питання, звідки беруться ваги.
Наше перше правило просте: розставте крапкою вектор отриманого токена проти кожного вихідного вектора, розділіть бали на квадратний корінь із їхньої розмірності та застосуйте softmax. Softmax підносить бали до степеня та ділить кожен результат на їх суму. Це робить більші результати отримують більші частки, зберігаючи частки позитивними та підсумовуючи одиницю.
Ось багаторазова голова. X — це матриця речень, по одній лексемі на рядок. Зараз ми включаємо три матриці проекцій, але спочатку встановлюємо всі три на ідентичність, що залишає кожен вектор незмінним.
def softmax(z):
    e = np.exp(z - z.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

def attention(X, Wq, Wk, Wv, causal=False):
    Q, K, V = X @ Wq, X @ Wk, X @ Wv
    scores = Q @ K.T / np.sqrt(K.shape[-1])
    if causal:
        future = np.triu(np.ones(scores.shape, dtype=bool), k=1)
        scores = np.where(future, -np.inf, scores)
    A = softmax(scores)
    return A, A @ V

I = np.eye(4)
for tokens in [["the", "river", "bank"], ["the", "money", "bank"]]:
    X = np.stack([emb[t] for t in tokens])
    A, H = attention(X, I, I, I)
    print(tokens)
    print("  bank input:", X[-1])
    print("  weights:", A[-1].round(2))
    print("  mixture:", H[-1].round(2))
Результат:
['the', 'river', 'bank']
  bank input: [0.5 0.5 0.8 0.2]
  weights: [0.26 0.31 0.43]
  mixture: [0.21 0.52 0.34 0.41]
['the', 'money', 'bank']
  bank input: [0.5 0.5 0.8 0.2]
  weights: [0.26 0.31 0.43]
  mixture: [0.52 0.21 0.34 0.41]
Той самий вхідний вектор на bank тепер отримує різні суміші. river подає воду; money забезпечує фінансування. Суміш змінюється, навіть якщо ваги ідентичні: вектори, які змішуються, змінилися. Ваги уваги – це лише одна частина обчислень.
Це ще не результат повного трансформаторного блоку. Ми надрукували H, головний вихід, без вихідної проекції чи залишкового додавання. Якщо назвати це новим представленням bank, ці операції будуть пропущені.
Щоб переглянути додавання без введення ще однієї матриці, припустімо, що вихідна проекція є тотожністю, а потік має ті самі чотири координати. Додавання річкової суміші до вихідної дає [0.71, 1.02, 1.14, 0.61]; додавання грошової суміші дає [1.02, 0.71, 1.14, 0.61]. Обидва зберігають додатковий внесок від оригіналу та отримують інший внесок контексту. Це ізолює залишкову операцію; нормалізація та загальні вихідні прогнози належать до блокової статті.
Звичайне середнє значення також розділяє ці два речення: річкове речення містить воду 0.50 і фінанси 0.17. Отже, цей перший експеримент демонструє змішування інформації, а не завдання, яке потребує вибіркової уваги. Наші вектори, розроблені вручну, зробили корисною навіть просту суміш. Далі ми побачимо, що контролює цю суміш і де це перше правило відповідності не відповідає вимогам.
Чому це взагалі змішалося
Простежте лише рядок bank у «берегу річки». Його немасштабовані скалярні добутки з the, river і ним самим є [0.20, 0.54, 1.18]. Оскільки вектори мають чотири виміри, ділення на дає [0.10, 0.27, 0.59]. Softmax перетворює ці результати приблизно на [0.26, 0.31, 0.43].
Потім голова обчислює:
mixture = 0.26 × the + 0.31 × river + 0.43 × bank
        ≈ [0.21, 0.52, 0.34, 0.41]
Відображена арифметика округлюється; програма зберігає повну точність. Термін river вносить воду в суміш. Найбільша вага припадає на сам bank: його крапковий добуток є найбільшим у цьому створеному просторі. Це властивість цих чисел, а не вимога, щоб увага зберігала ідентичність, звертаючи увагу на себе. У блоці залишковий шлях окремо переносить наявне представлення вперед.
Усі рядки виконують ту саму операцію одночасно. З проекціями ідентичності:
scores = X @ X.T / np.sqrt(X.shape[-1])  # (n, n)
A = softmax(scores)                      # (n, n): one distribution per row
H = A @ X                               # (n, d): one mixture per row
A[i, j] – частка вихідної позиції j у суміші, отриманій у позиції i. Це розподіл за позиціями, а не за вибором наступного лексеми.
Помножте бали на 5 перед softmax: найбільший бал отримує більшу частку. Це на користь самого банку, а не river. Помножте на 0.1, і вагові коефіцієнти наблизиться до єдиного середнього. Стандартний дільник sqrt(d_k) керує шкалою балів у міру зміни ширини запиту/ключа; він не вибирає, який жетон має виграти. Аргумент дисперсії наведено в додаткових примітках нижче.
Коли груба схожість ставить неправильне запитання
Перше правило говорить «збирати з векторів, схожих на мій». Але корисна інформація не повинна нагадувати отриманий маркер. Для структури може знадобитися ідентичність, яка надається за допомогою імені.
Щоб чітко бачити це, перейдіть до окремого, двовимірного навчального простору. Його осями є структура та паризька ідентичність. Це не фрагмент чотиривимірного прикладу bank:
# rows: the, Eiffel, tower
X2 = np.array([[0., 0.], [0., 1.], [1., 0.]])
I2 = np.eye(2)
A, H = attention(X2, I2, I2, I2)
print(A[-1].round(4))  # [0.2483 0.2483 0.5035]
print(H[-1].round(4))  # [0.5035 0.2483]
tower · Eiffel = 0. За грубої подібності Ейфелева оцінка точно така ж, як заповнювач нульового вектора. Деякий вміст Paris все ще входить, оскільки softmax надає обом позиціям позитивну вагу, але правило відповідності не має способу віддати перевагу Eiffel над заповнювачем.
Для вибраного нами завдання ми хочемо, щоб tower збирав інформацію про особу. Це обмеження правила відповідності, а не помилка зваженого змішування. Нам потрібно змінити те, з чим зіставляється tower, зберігаючи вихідний вектор доступним.
Створення запиту
Кожен маркер створює один запит, один ключ і один вектор значення на головку уваги, на блок трансформатора. В одній головці та сама вивчена матриця Wq перетворює кожну позицію: q_i = x_i @ Wq або Q = X @ Wq для всього речення. Окремі проекції Wk і Wv створюють ключ і значення цього токена. Це обчислені вектори, а не додаткові пошуки вбудовування словника. Таким чином, маркер у блоці з 12 головами має 12 запитів, 12 ключів і 12 значень. Запит — це представлення, яке використовується для зіставлення; вихідне представлення залишається доступним для решти блоку.
«Яку інформацію ця позиція може використовувати з інших токенів?» це корисний спосіб інтерпретації запиту. Для bank гіпотетична голова може відповідати доказам, пов’язаним з водою, або доказам, пов’язаним з фінансами; для tower, це може збігатися з іменем, яке надає ідентичність. Точніше, запит визначає, які ключі дають великі оцінки скалярного добутку. Ці бали стають вагами для змішування значень. Створення запиту є налаштуванням відповідності; він ще не зібрав інформацію або не оновив представлення маркера.
Запит читає повне поточне представлення маркера через Wq; йому не обов’язково зберігати сиру подібність або зберігати однакову кількість координат. Велика модель може проектувати тисячі координат представлення в набагато менший простір запитів/ключів. Запити та ключі в голові повинні мати однакову ширину, щоб їх скалярний добуток був визначений. Їхні координати не обов’язково називати поняттями, а голова не програмується буквальним запитанням.
Трансформуйте вектор, який використовується для постановки запитання. Матриця обміну відображає tower = [1, 0] на запит [0, 1], який відповідає тотожній координаті Ейфеля:
swap = np.array([[0., 1.], [1., 0.]])
A, H = attention(X2, swap, I2, I2)
print(A[-1].round(4))  # [0.2483 0.5035 0.2483]
print(H[-1].round(4))  # [0.2483 0.5035]
print(X2 @ swap)
# [[0. 0.]    the's query
#  [1. 0.]    Eiffel's query
#  [0. 1.]]   tower's query
На кожен рядок діє та сама матриця. Різні вхідні вектори дають різні запити; нам не потрібна окрема матриця для кожного слова. Представлення маркера та його запит тепер є різними об’єктами: представлення постачає вхідні дані, а запит є одним перетвореним представленням, яке використовується для зіставлення.
| Об’єкт | Форма | Що змінюється? |
|---|---|---|
| Вставний стіл | розмір словникового запасу × d | Один вивчений рядок на ідентифікатор маркера |
Введіть X | n × d | Представлення в цій конкретній послідовності |
Проекція запиту Wq | d × d_k | Спільні параметри, скориговані під час навчання |
Запити Q = X @ Wq | n × d_k | Розраховується для кожної позиції на цьому проході |
На першому рівні вхід включає в себе вбудовування та будь-який позиційний сигнал. Більш глибокі шари працюють на представленнях, уже оновлених попередніми шарами. Правило проекції є спільним; його входи не обов’язково повинні бути векторами статичних слів.
Що таке простір запитів/ключів і як це пов’язано з підпросторами?
Простір запитів/ключів — це координатний простір, у якому голова порівнює запити з ключами. Якщо голова використовує 128 координат для кожного, обидва живуть у , і їхній скалярний добуток дає там відповідний бал. Отримані карти Wq і Wk перетворюють набагато ширші представлення токенів у ці відповідні координати. Кожна голова має свої карти; координати не обов’язково мають іменовані семантичні значення.
Наприклад, вхідні дані з 12 288 координат можна помножити на матрицю запиту 12,288 × 128 для створення запиту з 128 координатами. Матриця ключів має однакову форму і виробляє 128-координатні ключі з вихідних представлень. На діаграмі використовуються bank і river, щоб показати це співвідношення; ці ширини ілюструють можливу конфігурацію моделі, а не розміри нашої іграшки.
Token representation space
12,288 dimensions in this example
The current representation carries information available to this position.
q = x @ WqEach output coordinatereads all input coordinates.
Query/key matching space
128 dimensions in this example
Wk separately maps source representations into keys with the same width.
q_bank = x_bank @ Wqk_river = x_river @ Wkscore = q_bank · k_river / √128Це безпосередньо з’єднується з простір рядків і нульовий простір: те, що матриця читає та ігнорує. Ця стаття використовує вектори-стовпці, тоді як наш код використовує вектори-рядки. Щоб застосувати його позначення, встановіть , отже . Тепер застосовується та сама картина підпростору:
- У 12 288-вимірному просторі введення простір рядка містить вказівки, які він читає. Його нульовий простір містить вказівки, які додають нуль до запиту. Додавання вектора з цього нульового простору до вхідних даних залишає запит без змін.
- У 128-вимірному вихідному просторі простір стовпців містить усі запити, які може створити лінійна карта. Він може заповнювати весь або бути меншим підпростором, якщо ранг карти нижчий за 128. Див. простір стовпця: які результати може охопити матриця?.
Карта запиту може читати не більше 128 незалежних напрямків введення в цьому прикладі, залишаючи принаймні 12 160 незалежних напрямків введення в нульовому просторі. Ці вказівки ігноруються цією картою запиту; залишковий потік все ще містить вхідні дані, а інші голови або проекції можуть використовувати інформацію, яку ця карта ігнорує. Напрямки введення, зчитані Wq і Wk, також можуть відрізнятися, навіть якщо їхні виходи порівнюються з використанням однакових 128 відповідних координат.
Таким чином, 128-вимірний простір відповідності є окремим вихідним простором, тоді як відповідний вхідний підпростір лежить всередині оригінального 12288-вимірного простору. Зверніть увагу, що «проекція» зазвичай означає вивчену лінійну карту: вона може розтягуватись і змішувати напрямки і, як правило, не є ортогональною проекцією на площину всередині оригінального простору.
Яку інформацію втрачає карта запиту?
Зробіть це конкретним за допомогою окремого 3D → 2D прикладу. Використовуючи позначення вектор-стовпчик вище, виберіть:
Ця матриця читає дві суми і . Для вектора обидві суми скорочуються:
Отже, знаходиться в нульовому просторі. Додавання будь-якого кратного йому числа залишає запит незмінним: . Наприклад:
Карта запиту не може розрізнити ці два вхідні дані. Що вона втрачає, так це кількість вхідних даних уздовж напрямку нульового простору : збільшення перших двох координат разом із зменшенням третьої на таку саму величину залишає обидві вихідні суми незмінними. Це не просто відкидає третю координату; ця координата вносить вклад в обидві суми. Арифметика визначає ігнорований напрямок; ідентифікація будь-якої семантичної інформації, закодованої в ньому, вимагала б експериментів на навченій моделі.
Якщо ключі залишаються фіксованими, ці ідентичні запити також дають ідентичні показники уваги та ваги. Зміна вхідних даних все одно може вплинути на ключ або значення цього маркера, інший заголовок або залишковий потік. «Втрачено» тут означає недоступне через цю карту запиту, а не стерте з усього представлення моделі.
Один запит може поєднувати кілька критеріїв відповідності
Один запит може містити кілька відповідних параметрів одночасно. Якщо запити та ключі мають 128 координат, їх масштабований скалярний добуток:
Усі 128 пар координат створюють одну оцінку сумісності для цієї пари запит/ключ. Запит порівнюється з кожним дозволеним ключем, створюючи окрему оцінку для кожної вихідної позиції. Softmax перетворює ці оцінки в один розподіл уваги. Це масштабований скалярний добуток у документі Transformer, §3.2.1.
128 координат не означають 128 семантичних об’єктів. Об’єкт може відповідати напрямку, поширеному між багатьма координатами, а деякі об’єкти можуть використовувати координати, що перекриваються. Десять функцій можна розподілити за 128 вимірами. Більша колекція, наприклад 1000 можливих функцій, у принципі може використовувати напрямки, що збігаються, особливо коли одночасно активні лише кілька функцій. Але 128 розмірів забезпечують щонайбільше 128 лінійно незалежних напрямків: вони не можуть незалежно зберегти 1000 довільних сильних властивостей через лінійне кодування.
Іграшкові моделі суперпозиції демонструє, як іграшкові мережі можуть представляти більш розріджені функції, ніж розміри, з інтерференцією між представленнями, що накладаються. Це підтримує репрезентативну можливість; він не встановлює, що конкретний запит містить 1000 ідентифікованих ознак, і не повідомляє нам, що вони собою представляють.
Скалярний добуток поєднує докази в одну оцінку, а не повертає окрему відповідь для кожної функції. Кожна голова створює один розподіл уваги та одну суміш цінностей на отриманий маркер. Кілька голів дозволяють різним критеріям відповідності створювати окремі розподіли та суміші; одна голова може поєднувати кілька критеріїв у межах власного балу.
Спробуйте три гіпотетичні відповідні напрямки
Поверніться до чотирьохкоординатних векторів bank, цього разу проектуючи в тривимірний простір запитів/ключів. Ми вручну називаємо його осі фінансами, водою та структурою та залишаємо ключову проекцію фіксованою. Це нова конструкція навчання, а не заява про координати чи поведінку навченої голови.
Виберіть , або , щоб спробувати можливу інтерпретацію банківського запиту. Кожен пресет змінює відображуване Wq; віджет обчислює кінцеві запити, ключі, бали та ваги уваги. Використовуйте , щоб перевірити три осі, або відкрийте , щоб комбінувати або протиставляти напрямки.
What could this query match?
Receiving token: bank. Its input stays [0.50, 0.50, 0.80, 0.20]. Switch a hand-set Wq to change its matching direction.
1. Produce the query
q_bank = x_bank @ Wq
| Input | finance | water | structure |
|---|---|---|---|
| finance | 0.00 | 0.00 | 0.00 |
| water | 0.00 | 0.00 | 0.00 |
| structure | 0.00 | 3.75 | 0.00 |
| generic | 0.00 | 0.00 | 0.00 |
q_bank = 0.8 × [0.00, 3.75, 0.00]
= [0.00, 3.00, 0.00]
Only the structure row of this constructed Wq is nonzero. A real projection can combine every input coordinate.
Adjust Wq coefficients
Negative coefficients can make this query oppose a key direction. A zero query gives equal scores and uniform weights.
2. Compare query and keys
The query arrow is rescaled to show its direction. Scores use the full numerical query. Faded keys belong to words absent from this sentence.
3. Match first; mixing comes next
The same Wq produces a query for every token. Below, each key is computed using a fixed Wk that keeps finance, water, and structure and drops the generic coordinate.
| Token | Its query x @ Wq | Its key x @ Wk | q_bank · key / √3 | Bank's attention weight |
|---|---|---|---|---|
| the | [0.00, 0.00, 0.00] | [0.00, 0.00, 0.00] | 0.000 | 11.1% |
| river | [0.00, 0.00, 0.00] | [0.00, 1.00, 0.00] | 1.732 | 62.6% |
| bank | [0.00, 3.00, 0.00] | [0.50, 0.50, 0.80] | 0.866 | 26.3% |
The keys stay fixed when Wq changes. Switching sentences leaves bank's query unchanged here, but changes the available keys and their shares. The head would use these weights to mix values; this widget stops at matching.
These questions, axes, matrices, and token features are hand-designed teaching examples. Changing a preset changes Wq; it does not show a trained head choosing a new matrix for each sentence. Real heads learn numerical matching patterns jointly with key projections, without named semantic coordinates or literal questions.
Зауважте, що запит не повинен самостійно ідентифікувати передбачуване значення слова. У цій конструкції bank починається з того самого введення та створює той самий запит в обох реченнях. Доступні ключі та значення забезпечують різний контекст. Тренування та оцінювання мають визначити, чи допомагає будь-який із цих гіпотетичних зразків відповідності завданню.
Таблиця вбудовування та матриці проекцій є окремими
Таблиця вбудовування E зберігає один початковий вектор на лексему словника. Проекційні матриці Wq, Wk і Wv перетворюють поточне представлення позиції в її запит, ключ і значення. Кожна головка зазвичай має власні виступи в кожному блоці трансформатора; таблиця вбудовування маркерів надає початкові представлення під стеком.
| Об’єкт | призначення | Вивчені чи обчислені? |
|---|---|---|
E | Надає початковий вектор для кожного ідентифікатора маркера | Таблиця вивчених параметрів |
Wq, Wk, Wv | Перетворення поточних уявлень | Вивчені проекційні матриці |
X, Q, K, V | Представте цей вхід та його трансформовані погляди | Обчислюється при кожному проході вперед |
A, H | Зважте та змішайте значення для цього введення | Обчислюється при кожному проході вперед |
Скільки існує таблиць і векторів?
Наведена нижче архітектура розширює 2 голови, що обробляють 3 маркери в одному стандартному підрівні самоконтролю. Таблиця вбудовування не має уваги. Її вибрані рядки стають X; обидві голови зчитують той самий повний вхід, використовуючи окремі вивчені матриці проекцій. У кожній головці Q, K і V є обчисленими матрицями з одним вектором на рядок маркерів. Слідкуйте за виділеними рядками bank, щоб підрахувати його запити, ключі та значення в двох заголовках.
X · 1 input matrix · 3 × d
xthe = etheriver xriver = eriverbank xbank = ebankHead 1
3 learned projection matrices
3 computed matrices · 3 token rows each
Each token has 1 q + 1 k + 1 v in this head.
A = softmax(Q @ Kᵀ / √d_k)H(1) · 1 mixture matrix · 3 × d_vH = A @ VHead 2
3 learned projection matrices
3 computed matrices · 3 token rows each
Each token has 1 q + 1 k + 1 v in this head.
A = softmax(Q @ Kᵀ / √d_k)H(2) · 1 mixture matrix · 3 × d_vH = A @ VConcat(H(1), H(2)) · 1 matrix · 3 × (2 d_v)
One row per token, containing both head mixtures
Wo · 1 learned matrix for this sublayer · (2 d_v) × d
Δ = Concat @ Wo · 1 attention-update matrix · 3 × d
Residual addition: Y = X + Δ · the original X is added here
Для позицій жетонів n і голів h в одному стандартному підрівні самоуважності:
| Об’єкт | Вивчені чи обчислені? | Граф | Форма кожної матриці |
|---|---|---|---|
Таблиця вбудовування маркерів E | навчився | 1 для моделі, перед стеком | розмір словника × d |
Введіть X | Обчислений | 1 спільний вхід для всіх головок цього підрівня | n × d |
Проекції запиту Wq | навчився | h, по одному на голову | d × d_k |
Ключові прогнози Wk | навчився | h, по одному на голову | d × d_k |
Прогнози вартості Wv | навчився | h, по одному на голову | d × d_v |
Запити Q | Обчислений | матриці h; Загальна кількість векторів запиту n h | n × d_k |
Ключі K | Обчислений | матриці h; Загальна кількість ключових векторів n h | n × d_k |
Значення V | Обчислений | матриці h; Загальна кількість векторів значень n h | n × d_v |
Оцінки запиту/ключу S | Обчислений | h, по одному на голову | n × n |
Ваги уваги A | Обчислений | h, по одному на голову | n × n |
Головні суміші H | Обчислений | h, по одному на голову | n × d_v |
| З’єднані головні виходи | Обчислений | 1 | n × (h d_v) |
Вихідна проекція Wo | навчився | 1 для цього підшару | (h d_v) × d |
Увага оновлення Δ і залишковий результат Y | Обчислений | 1 кожного | n × d |
Таким чином, один маркер містить h запитів, h ключів і h значень у блоці, тоді як блок має 3h отримані матриці проекцій Q/K/V і одну вихідну проекцію. Стек таких блоків N зазвичай має власні проекції в кожному блоці: матриці проекцій Q/K/V 3Nh і вихідні проекції N. Ці підрахунки описують стандартне розташування з кількома головками, пропускають зміщення та підраховують логічні матриці; реалізації часто упаковують кілька проекцій в один тензор параметра.
Тільки пошук індексується ідентифікатором маркера. Матриці проекцій мають рядки вхідних координат і стовпці вихідних координат, тому кожен маркер використовує однакові матриці проекцій у голові. Пізніші блоки отримують оновлені представлення з попереднього блоку без повторного пошуку вбудовування. Блокова стаття додає до цього плану деталі нормалізації та передавання.
«Початковий» описує, де відбувається пошук під час обробки речення. Перед навчанням з нуля таблиця вбудовування зазвичай починається з випадкових чисел. Під час навчання ці вектори вивчаються разом із проекціями та рештою моделі; зазвичай немає окремого етапу, який спочатку навчає вкладення «загального значення». Після навчання пошук отримує вивчений вектор. Він незалежний від контексту, оскільки не перевіряє поточне речення. Той самий ідентифікатор маркера отримує той самий рядок, навіть якщо пізніші представлення залежать від контексту.
У наших перших прикладах використовуються ручні вектори, щоб ми могли слідкувати за арифметикою. У навчальному прикладі нижче вивчається таблиця вбудовування, а також проекції.
Три ролі: зіставлення та перенесення інформації
Запит є одним із трьох трансформованих представлень:
| Переглянути | Обчислення | Робота |
|---|---|---|
| Запит | Q = X @ Wq | Представляє, що кожна позиція отримання відповідає |
| ключ | K = X @ Wk | Представляє кожну вихідну позицію для відповідної операції |
| Значення | V = X @ Wv | Надає вектори, які фактично буде змішано |
Запити та ключі зустрічаються в Q @ K.T. Можна вивчити обидві сторони: модель може трансформувати те, як отримувач запитує та як знаходить джерело. Дві проекції не обов’язково повинні бути рівними, тому оцінка від i до j може відрізнятися від оцінки від j до i.
У цінностей інша робота. Зберігайте запити та ключі фіксованими та змінюйте місцями лише координати значень:
A, H = attention(X2, swap, I2, swap)
print(A[-1].round(4))  # [0.2483 0.5035 0.2483] -- unchanged
print(H[-1].round(4))  # [0.5035 0.2483]        -- different content
Q і K контролюють вагу суміші; V контролює його вміст. Велика вага на Eiffel сама по собі не говорить нам, у якому напрямку рухається результат. Ми також повинні перевірити вартість Ейфеля. Наш обмін налаштований вручну, щоб зробити цю незалежність видимою; Навчання буде вивчати перетворення разом.
Повна голова має звичну форму , як зазначено в оригінальній статті Transformer, §3.2. Його розміри:
X       n × d
Q, K    n × d_k
V       n × d_v
A       n × n
H       n × d_v
d_v не обов’язково дорівнює d. Голова повертає суміш у координатах значення. Вихідна проекція блоку відобразить його в координатах представлення, яке ми оновлюємо.
Спробуйте двовимірний приклад нижче. Почніть з , перейдіть на , а потім перемкніть . Числа обчислюються з наведених вище матриць; зміна значень залишає ваги недоторканими.
Change the match, then change the content
The receiving position is tower. Its input is [1, 0]. Keys stay unchanged; scores use √2 scaling.
[1.0000, 0.0000][0.5035, 0.2483]Swapping the query changes the weights. Swapping values changes the mixture while leaving those weights untouched. No residual addition is shown here.
Що насправді вимірює вага
Оцінка порівнює один запит/пару ключів. Вага порівнює цю оцінку з усіма іншими дозволеними оцінками в тому самому рядку:
Додавання іншого ключа може змінити a_ij без зміни q_i або k_j. Так само вага не є підрахунком спільного входження слів під час виконання. Навчання змінює параметри; висновок обчислює нові оцінки та суміші з використанням цих параметрів. Позиція також може вплинути на результати, коли надається інформація про позицію — ми навмисно не вказали її в цій іграшці.
Змусити це навчитися
Поверніться до завдання bank, але відкиньте наші створені вручну сокири. Тепер модель вивчає восьмивимірні вбудовування та три матриці проекцій. Класифікатор зчитує лише суміш у кінцевій позиції bank і передбачає воду (0) або фінанси (1). Це крихітний контрольований класифікатор, а не мовна модель наступного маркера чи повний трансформаторний блок.
Слідуйте за реченням від пошуку до оновлення
Віджет використовує двовимірну версію цього класифікатора, щоб кожен вектор і параметр залишалися видимими. Виберіть речення, а потім використовуйте , щоб слідувати речення → пошук вбудовування → Q/K/V → суміш уваги → прогноз → втрата → градієнти → оновлення параметрів. На етапі градієнта параметри ще не змінилися. робить один крок SGD; продовжує оновлені параметри та інший приклад.
Порівняйте таблицю вбудовування з матрицями проекцій, а потім порівняйте ці збережені параметри з векторами, обчисленими з них. Етапи градієнта та оновлення показують усі групи параметрів разом, включаючи рядок вбудовування, який не отримав градієнта, оскільки його слово було відсутнє. Використовуйте , щоб чергувати обидва приклади, або , щоб повернутися до тієї самої випадкової ініціалізації.
Follow one sentence through training
One head, two learned coordinates, two classes. All numbers are computed. Coordinates have no hand-assigned meaning.
Completed updates: 0. SGD learning rate: 0.3. Extra training alternates the two examples and keeps the same shared parameters.
- 1. Sentence
- 2. Lookup
- 3. Q / K / V
- 4. Mixture
- 5. Prediction
- 6. Loss
- 7. Gradients
- 8. Update
1. Sentence
Target: water. The classifier will read only the mixture at bank. The target is used by the loss, not by the attention calculation.
The parameter tables start with repeatable random numbers; the classifier bias starts at zero. Nothing has been trained separately beforehand.
This is a two-example supervised training demonstration, not a generalization test or a complete transformer block. It omits positions, normalization, residual additions, and the FFN. The Python model below uses eight coordinates and Adam; this widget uses two coordinates and SGD.
Виконувана восьмивимірна модель
import torch
import torch.nn as nn

vocab = {"the": 0, "river": 1, "money": 2, "bank": 3}
data = [(["the", "river", "bank"], 0),
        (["the", "money", "bank"], 1),
        (["river", "bank"], 0),
        (["money", "bank"], 1)]

def encode(tokens):
    return torch.tensor([vocab[t] for t in tokens])

class OneHeadSense(nn.Module):
    def __init__(self, vocab_size, d=8):
        super().__init__()
        self.emb = nn.Embedding(vocab_size, d)
        self.Wq, self.Wk, self.Wv = (
            nn.Linear(d, d, bias=False) for _ in range(3))
        self.cls = nn.Linear(d, 2)
        self.d = d

    def forward(self, ids, return_attn=False):
        X = self.emb(ids)
        Q, K, V = self.Wq(X), self.Wk(X), self.Wv(X)
        A = torch.softmax(Q @ K.T / self.d**0.5, dim=-1)
        H = A @ V
        logits = self.cls(H[-1])
        return (logits, A) if return_attn else logits

torch.manual_seed(0)
model = OneHeadSense(len(vocab))
opt = torch.optim.Adam(model.parameters(), lr=0.05)
loss_fn = nn.CrossEntropyLoss()
for step in range(300):
    for tokens, label in data:
        logits = model(encode(tokens)).unsqueeze(0)
        loss = loss_fn(logits, torch.tensor([label]))
        opt.zero_grad()
        loss.backward()
        opt.step()

for tokens, _ in data[:2]:
    logits, A = model(encode(tokens), return_attn=True)
    print(tokens, "prediction:", logits.argmax().item())
    print({t: round(w, 2) for t, w in zip(tokens, A[-1].tolist())})
У перевіреному циклі CPU початкового рівня передбачення 0 і 1, а округлені рядки уваги:
{'the': 0.0, 'river': 1.0, 'bank': 0.0}
{'the': 0.0, 'money': 1.0, 'bank': 0.0}
Цей запуск навчився строго вибірковій маршрутизації. Це спостережуване рішення, а не те, що є в групі з чотирьох прикладів: однорідна суміш також містить достатньо інформації для класифікації прикладів. Надруковані значення 0.0 є округленими, що не є доказом точного нульового значення softmax ваг. Тут немає відкладеної оцінки; це демонструє виконання маленького завдання.
Що змінилося під час навчання? Таблиця вбудовування, проекції Q/K/V і класифікатор: параметри 4×8 + 3×8×8 + (8×2+2) = 242. Ваги A є активаціями, повторно обчисленими з кожного вхідного сигналу, а не з іншої таблиці параметрів, які можна навчити. Навчання коригує фіксовані перетворення, щоб їх залежні від вхідних даних суміші допомагали класифікатору зменшити втрати.
Голови та блоки тренуються разом
Іграшка має одну голову. У стандартному тренуванні трансформатора повної моделі усі голови уваги в усіх блоках трансформаторів тренуються разом. Прохід вперед обчислює прогнози та втрату. Зворотне розповсюдження переносить градієнти від цієї втрати через блоки, через маршрути запитів/ключів і значень кожної голови та назад до таблиці вбудовування. Потім оптимізатор оновлює всі групи параметрів, які можна навчити, включаючи вихідні прогнози та FFN. Кожен параметр отримує власний градієнт; це не вимагає, щоб кожен скаляр змінювався на кожному кроці.
Для кожної голови немає окремої тренувальної петлі. Голови в одному блоці обчислюють паралельно, тоді як блоки послідовно передають оновлені представлення вперед. Зворотне поширення слідує цим залежностям у зворотному порядку. model.parameters() нашого циклу включає вкладення, три проекції та класифікатор разом; повний оптимізатор трансформатора також включає параметри всієї моделі, яку можна навчити.
Чи можуть дві маленькі матриці відновити ідентифіковані ознаки?
Окремий експеримент із відновлення функцій тренує лише два запити 9 × 3 і прогнози значень на синтетичних даних. Він перевіряє, які відомі функції відновлюються на картах, перевіряє затримані прогнози та втручається в релевантні та нерелевантні напрямки введення. Фіксовані ключі та вихідні цілі навмисно закріплюють значення функцій, щоб їх можна було ідентифікувати.
Увага вивчає дані, а не світ
Супутник train_biased_dataset.py призначає довільні мітки шести контекстним словам, включаючи протилежні мітки для lawyer і attorney. У перевіреному запуску початкового рівня 0 він відповідає цим призначенням:
| Контекст | Присвоєна мітка | Прогнозування | Округлена увага від bank до контексту |
|---|---|---|---|
| річка | води | води | 0.00 |
| гроші | фінанси | фінанси | 1.00 |
| склепіння | води | води | 0.00 |
| лосось | фінанси | фінанси | 1.00 |
| адвокат | води | води | 0.00 |
| адвокат | фінанси | фінанси | 1.00 |
Результат цікавіший, ніж «модель завжди звертає увагу на підказку». Він вирішує два класи з різними моделями уваги. Дуже малі ваги, інші значення та класифікатор мають значення; лише округлена теплова карта не є поясненням прогнозу.
Вузький висновок полягає в тому, що ця контрольована іграшка може вивчати довільні призначення міток. Це не встановлює, що мовна модель відтворює всі упередження у своїх даних або не може навчитися корисним узагальненням. Щоб вивчити ці питання, нам знадобиться інший експеримент і оцінка.
Причинне маскування: декодер дивиться лише ліворуч
Поки що кожна позиція може читати кожну іншу позицію. Під час навчання мовної моделі зліва направо представлення, яке використовується для передбачення наступного токена, не повинно бачити цей майбутній токен. Причинна маска змінює, які позиції джерела дозволені.
Функція вже містить необхідний крок, безпосередньо перед softmax:
future = np.triu(np.ones(scores.shape, dtype=bool), k=1)
scores = np.where(future, -np.inf, scores)
Піднесення до від’ємної нескінченності в ступінь дає нуль, тому заборонені позиції отримують нульову вагу. Встановити їхні бали на нуль не спрацює: exp(0) = 1 все одно дасть їм частку. Кожен рядок зберігає принаймні свою позицію.
Each row is one token's attention distribution, produced bysoftmax(Q·Kᵀ / √d_k) and summing to 1; the output for that token is the weighted sum of every value vector using these weights. Switch toCausal and the upper triangle is masked to −∞ before the softmax, so a token can attend only to itself and the tokens before it — the surviving weights renormalize. The mask distinguishes bidirectional from causal attention. Implementations also differ in details such as normalization placement. Weights here are illustrative, chosen to show the shape of a real head, not dumped from a model.
Для «берега річки» останній рядок не змінюється: bank вже може бачити всю послідовність. Для «берегової річки» каузальний bank не може нічого отримати від майбутньої позиції river. Обмеження джерела змінено; механізм проектування та змішування не працював.
Маска визначає доступ, а не повне позиційне кодування. Наша безпозиційна іграшка все ще має обмеження; стаття блоку пояснює, куди входить інформація про позицію. Для генерації попередньо обчислені ключі та значення можна повторно використовувати в рамках причинної уваги — стаття про KV-кеш дотримується цього наслідку. Перехресна увага замість цього бере свої запити та пари ключ/значення з різних послідовностей.
Дивіться справжні голови
Встановлені вручну осі зробили арифметику читабельною. У навченій моделі перевірте як де збирається інформація, так і який внесок створюється.
BertViz візуалізує шаблони уваги голову за головою. AttentionViz додатково підтримує дослідження геометрії запитів/ключів і шаблонів для входів. exBERT — ще один інтерфейс дослідження. Це супутні інструменти, а не докази того, що наша іграшка повинна відтворювати певну голову.
Спробуйте два речення, що містять різні вживання bank. Огляньте кілька голів і шарів, а потім порівняйте відповідні приховані зображення. Теплова карта відображає коефіцієнти змішування; значення та вихідна проекція визначають фактично внесений вектор. Розглядайте запропоновану роль, таку як «голова усунення неоднозначностей», як гіпотезу для перевірки вхідних даних і втручань.
До чого це призводить
Ми створили внесок у три етапи: збіг, вага, суміш. Початковий експеримент bank показав, що інформація протікає через зважену суму. Приклад Eiffel відокремив відповідність від подібності вихідних даних, і зміна значень показала, що однакові ваги можуть містити різний вміст. Навчання надає параметри замість того, щоб наша рука вибирала їх.
Наступним кроком є включення цього внеску. У найпростішому випадку однакової ширини з вихідною проекцією ідентичності tower = [1, 0] плюс його суміш запитів обміну [0.2483, 0.5035] дає [1.2483, 0.5035]. Змішування є одним внеском до існуючого представлення. Реальний блок обробляє вихідну проекцію, кілька голів, нормалізацію та інше оновлення з FFN.
Всередині блоку трансформатора дотримується цих оновлень через повне обчислення.
Додатково: математика за головою
Навіщо ділити на квадратний корінь із ключового розміру?
Припустимо, що незалежний запит і ключові записи мають середнє значення нуль і дисперсію один. Кожен продукт має відхилення один; підсумовування незалежних добутків дає . Ділення на повертає дисперсію до одиниці за цих припущень. Це запобігає тому, що розмір сам по собі може збільшити типову шкалу балів і запровадити softmax у регіони з дуже малими градієнтами. Ці припущення пояснюють вибір масштабування; вони не є точним статистичним описом кожної тренованої голови. Оригінальна стаття §3.2.1 наводить цей аргумент.
Наша іграшка застосовує дільник, у тому числі у двох вимірах. Перемноження балів змінює концентрацію, а не порядок кінцевих балів. Скалярні добутки залежать від величин, а також від вирівнювання, тому вони не є косинусною подібністю, якщо відповідні вектори не нормалізовані.
Теоретико-математичні основи
Вивчено відповідність, згладжування ядра та пам’ять
Підставляючи прогнози в неперерахований бал, ви отримаєте з . Його ранг не перевищує , і він не повинен бути симетричним. Це функція білінійної сумісності, а не загалом математична метрика відстані. Ключовою відмінністю від необробленої подібності є вивчена матриця між двома вхідними даними.
Розкладка на множники не є унікальною: заміна на і на зберігає бали для оборотного . Це твердження описує оцінку лише для простого вмісту; позиційні операції, вставлені між проекціями та оцінкою, потребують окремого розгляду. Кешування ключів не робить фактори математично ідентифікованими.
Нормована зважена сума також пов’язана зі згладжуванням ядра: використовуйте позитивну сумісність , нормалізуйте між джерелами та усередніть їхні значення. Transformer Dissection розвиває цю перспективу. Hopfield Networks — це все, що вам потрібно поєднує оновлення в стилі уваги з пошуком асоціативної пам’яті. Це додаткові види операції, а не передумови для запуску іграшки.
Існує корисний механізм different, якщо ми видалимо softmax. Без векторів-стовпців і постійного масштабування опущено, ненормалізована причинно-наслідкова лінійна увага може бути змінена таким чином:
Оновіть пам’ять за допомогою і прочитайте її за допомогою . Пам’ять має фіксовані розміри для фіксованої ширини ключа/значення. Лінійні трансформатори таємно є швидкими програматорами ваги пов’язує цей механізм із попередніми системами швидкої ваги. Стандартна увага softmax не допускає цього перегрупування; видалення softmax змінює операцію.
Створіть голову, яку ви навчили
Подальший експеримент: повторювані візерунки та абляція
Супутник examples/train_induction_head.py тренує двошарову модель лише уваги на повторюваних послідовностях, потім вимірює шаблони уваги та видаляє голови. Це окрема лабораторія, поза одноголовим класифікатором чуття. Індукційна схема продовжує A B … A з B; експеримент перевіряє, чи модель виявляє механізм, корисний для цього завдання.
Запустіть сценарій, запишіть втрату та оцінки її індукції та порівняйте втрату до та після кожної абляції. Розглядайте існування та розташування певної схеми як результат перевірки, а не як щось гарантоване архітектурою чи випадковим початковим числом. Скрипт використовує звичайний PyTorch; TransformerLens надає гачки та доступ для активації для більш детальних досліджень.
Такі назви, як «кореферентна головка» або «індукційна головка», мають узагальнювати виміряну поведінку. Співвідношення зі зразком передбачає роль; втручання перевіряє, що від цього залежить. Навіть абляцію слід інтерпретувати обережно, оскільки інші компоненти можуть взаємодіяти з видаленою головкою або компенсувати її.