Що читає навчений класифікатор MNIST: простір рядків і нульовий простір
Навчений класифікатор MNIST представляє кожне зображення за допомогою 128 прихованих активацій, але його кінцевий лінійний шар читає лише десять незалежних напрямків. Ми можемо видалити інші 118 вказівок, не змінюючи жодних цифр, окрім округлення з плаваючою комою. Цей експеримент створює це втручання та перевіряє його на всіх 10 000 тестових зображень.
Ця стаття ґрунтується на Векторне розкладання та підпростори: що читає та стирає матриця. Цей пояснювач розробляє векторну декомпозицію та чотири фундаментальні підпростори з малими матрицями та інтерактивними діаграмами. Тут ми перетворимо цю геометрію на втручання: спочатку побудуйте проекцію вручну, а потім побудуйте її з вивчених ваг.
У цій статті ми зосередимося на нульовому просторі: напрямках у вивченому представленні, які вихідний рівень не може виявити. Ми визначимо ці напрямки в навченому класифікаторі MNIST і побудуємо проекцію, яка виключає їхній внесок, показуючи, як ми можемо зменшити незалежні напрямки репрезентації, не змінюючи результатів чи прогнозів.
Ми будемо використовувати інструменти лінійної алгебри: сингулярну декомпозицію (SVD), щоб визначити напрямки та те, як матриця їх масштабує, і проекцію, щоб зберегти або видалити вибрані компоненти представлення.
Ми створимо щільну мережу з навчання реальної мережі на MNIST, яка перетворює 784 піксельні значення на 128 прихованих активацій, а потім десятизначні результати.
Частиною, яку ми будемо перевіряти, є вивчена вагова матриця вихідного шару, , яка перетворює вектор із 128 значень активації, створених прихованим шаром для одного зображення (), у цифрові оцінки. Ваги — це збережені параметри, які спільно використовуються для входів; активації в – це значення, обчислені заново для кожного зображення. Застосування SVD до повідомляє нам, які напрямки у прихованому представленні можуть впливати на бали, а які вихідний рівень ігнорує.
Питання, яке керує експериментом: які зміни вивченого представлення невидимі для класифікатора, і як ми можемо видалити ці компоненти, не змінюючи його прогнози?
Після навчання мережі та заморожування вивчених ваг ми виконаємо чотири кроки:
- Дізнайтеся, що вихідний рівень не може виявити: визначте його нульовий простір за навченою ваговою матрицею.
- Розділіть кожне представлення на два компоненти: компонент простору рядків, який визначає бали, і компонент нульового простору, який вносить нуль.
- Видаліть невизначений компонент: побудуйте проекцію, яка зберігає лише компонент простору рядків.
- Переконайтеся, що прогнози залишаються незмінними: пропустіть модифікований вектор через початковий вихідний рівень і порівняйте його бали та прогнози з базовою лінією.
Почніть із навченої мережі MNIST
Ми створюємо ту саму архітектуру, що й оригінальна стаття, використовуючи PyTorch: один прихований шар перетворює 784 піксельні значення на 128 активацій, а вихідний рівень використовує їх для передбачення цифри. PyTorch надає шари, автоматичне розрізнення та оптимізатор; наше втручання змінює активації між двома його лінійними шарами.
Вектор описується списком чисел, які називаються його координатами. У векторному зображенні кожне число є інтенсивністю пікселя. У нашому прихованому представленні кожна координата є числовим результатом одного нейрона. Він говорить нам, який внесок цього напрямку координат у вектор представлення. Разом ці значення визначають напрямок і величину вектора. Повна мережа MNIST має 128 активацій, що описують один вектор у його 128-вимірному просторі прихованого представлення.
Ось мережа, яка використовується для завантажуваного експерименту:
import numpy as np
import torch
from torch import nn
from pathlib import Path
from classifier_subspaces import load_mnist

torch.set_num_threads(2)
torch.use_deterministic_algorithms(True)
torch.manual_seed(42)
model = nn.Sequential(
    nn.Linear(784, 128),
    nn.ReLU(),
    nn.Linear(128, 10),
)
Тренуйтеся один раз, потім заморозьте мережу
Завантажувач походить із завантажуваного classifier_subspaces.py у розділі відтворення. Він завантажує оригінальні масиви MNIST і кешує їх локально. Ми зводимо кожне зображення, масштабуємо його пікселі до і зберігаємо цілочисельні мітки:
(train_images, train_labels, test_images, test_labels), _ = load_mnist(
    Path.home() / ".cache/mirror-span"
)
train_x = torch.from_numpy(train_images.reshape(-1, 784).astype(np.float32) / 255)
train_y = torch.from_numpy(train_labels.astype(np.int64))
test_x = torch.from_numpy(test_images.reshape(-1, 784).astype(np.float32) / 255)
test_y = torch.from_numpy(test_labels.astype(np.int64))

optimizer = torch.optim.Adam(model.parameters(), lr=0.002)
generator = torch.Generator().manual_seed(43)
model.train()
for epoch in range(8):
    for indices in torch.randperm(len(train_x), generator=generator).split(512):
        optimizer.zero_grad(set_to_none=True)
        logits = model(train_x[indices])
        loss = nn.functional.cross_entropy(logits, train_y[indices])
        loss.backward()
        optimizer.step()

model.eval().requires_grad_(False)
model.double()
test_x = test_x.double()
feature_extractor = model[:2]  # Linear followed by ReLU
head = model[2]               # Linear: 128 activations -> 10 logits
Останній шар повертає необроблені бали. Втрата перехресної ентропії PyTorch очікує цих логів, тому ми не розміщуємо softmax у мережі. loss.backward() обчислює градієнти для обох лінійних шарів; optimizer.step() оновлює свої ваги та зміщення. Після восьми епох requires_grad_(False) заморожує ці параметри. eval() встановлює режим оцінювання; сам він не заморожує ваги. Ми транслюємо навчену модель і тестуємо вхідні дані до float64, щоб виміряти ідентичності проекції з меншою помилкою округлення.
Для одного тестового зображення передбачення замороженої мережі складається з двох кроків:
image = test_x[0]
with torch.inference_mode():
    h = feature_extractor(image)
    logits = head(h)
    probs = logits.softmax(dim=-1)
print(h.shape)      # torch.Size([128])
print(probs.shape)  # torch.Size([10])
128 значень у є виходом прихованого шару та входом шару виведення. Вихідний рівень перетворює ці значення в десять балів або логітів, використовуючи навчену вагову матрицю і вектор зміщення :
Softmax перетворює десять балів у ймовірності, а найбільша ймовірність визначає прогноз. Якщо ми збережемо всі десять балів, ми також збережемо ймовірності та прогноз.
Тут ми бачимо, що матриця перетворення вихідного рівня зменшує розмірність зі 128-вимірного прихованого простору до десятивимірного вихідного простору . Він не може зберегти кожен незалежний напрямок у прихованому просторі, тому різні приховані вектори можуть давати абсолютно однакові оцінки. Тоді цікаве запитання: які напрямки у 128-вимірному прихованому просторі несуть інформацію, яку вихідний рівень використовує для обчислення своїх десяти балів, а які він ігнорує?
Щоб з’ясувати це, ми заморозимо навчену мережу та вставимо перетворення між прихованими та вихідними шарами, змінивши лише вектор, переданий на вихідний рівень. Це перетворення все одно повертатиме 128 чисел, але обмежуватиме їх десятьма незалежними напрямками, фактично усуваючи внесок інших 118 напрямків, зберігаючи при цьому кожну вихідну оцінку. У нашій навченій моделі ці 118 незалежних напрямків охоплюють нульовий простір вихідної матриці. Ми вручну побудуємо нове перетворення, щоб видалити весь компонент у цьому підпросторі, який вихідний шар уже відображає на нуль.
Ми використаємо декомпозицію рядків і нульових просторів із супровідного пояснювача, щоб побудувати це перетворення на основі вивчених ваг.
Від діаграми підпростору до прихованих активацій
У супровідному поясненні ми намалювали розкладання в трьох вимірах. Його синій вектор тепер стає прихованим представленням із 128 чисел, обчисленим для зображення. Навчена вихідна матриця відображає це представлення на десятизначні оцінки. Наша виміряна матриця має ранг 10, тому кольори відповідають цим просторам:
| Вектор | Оригінальна матриця в пояснювачі | Навчена матриця результатів MNIST |
|---|---|---|
| Синій | Повний простір введення 3D | Повний прихований простір 128D |
| Зелений | Двовимірна площина простору рядків | 10D підпростір рядків |
| Рожевий (червоний) | 1D лінія нульового простору | 118D нульовий підпростір |
Усі три вектори MNIST все ще мають 128 координат. Розміри підпростору враховують незалежні напрямки, доступні для кожного компонента, подібно до того, як зелений колір у віджеті пояснювача має три координати, але обмежений двовимірною площиною. Десять збережених напрямків можуть поєднувати багато прихованих активацій; вони не повинні збігатися з десятьма окремими нейронами.
Наш експеримент виконує еквівалент клацання Видалити нульовий компонент: після навчання ми вставляємо проекцію перед вихідним шаром, який зберігає зелений колір і видаляє червоний. Десятизначні результати залишаються незмінними, оскільки:
Тут — фіксований вектор зсуву вихідного рівня. Ми також перевіримо протилежне втручання: збережемо лише компонент нульового простору та вимірюємо, що відбувається з прогнозами. Зберігання лише червоного дає , тому бали втрачають свою залежність від зображення.
Ми аналізуємо вагові коефіцієнти, але втручаємося в активації: кожне порівняння використовує ті самі вхідні зображення та вивчені вагові коефіцієнти, тому будь-яка зміна в прогнозі походить від представлення, яке ми передаємо на вихідний рівень. Експеримент перевіряє обидва прогнози чисельно, використовуючи вивчені ваги та реальні зображення MNIST; рівність балів зберігається до округлення з плаваючою комою.
Побудуйте проекцію, яка зберігає вихідні дані наступної матриці
Перш ніж побудувати втручання для 128 прихованих активацій, давайте попрацюємо над прикладом із трьома координатами. Пояснювач підпросторів показав, як розділити вхідні дані на компоненти, які матриця читає та ігнорує. Тепер ми перетворимо цю декомпозицію на проекцію, вставлену перед незмінним вихідним шаром.
Ми перевіримо обидва втручання на невеликому прикладі: зберегти компонент простору рядків і зберегти вихідні дані, або залишити лише компонент простору нуль і отримати нуль. Потім ми використаємо SVD для побудови тих самих втручань для навчених ваг MNIST.
Використовуйте матрицю, яка зчитує суму перших двох вхідних координат і третьої координати окремо:
Ця матриця має площину простору рядка і лінію нульового простору , ті самі вхідні підпростори, що й у прикладі пояснення з трьома виходами. Його виходи заповнюють , тому його лівий нульовий простір містить лише нуль. У наведеному нижче віджеті виберіть базовий вектор введення, щоб побачити його призначення як стовпець . Вибір і показує, що два різні входи досягають одного виходу.
Побудуйте проекцію за формулою компонента
Компонент простору рядків повинен мати рівні першу та другу координати зі збереженням їх суми. Усереднення цих координат і збереження третьої дає . Матриця, яка виконує цю операцію:
Проекція повертає три координати, але обмежує їх двовимірною площиною. Він видаляє незалежний напрямок без видалення координати. Це два маршрути:
Це працює для кожного входу, а не лише для нашого прикладу. Перемноження матриць дає:
Тому . Додавання однакового вихідного зміщення до обох маршрутів зберігає рівність: .
Замість цього залишити стертий компонент
Віднімання проекції з тотожності виділяє іншу частину:
Для нашого введення, . Ця матриця має ранг 1: усі її виходи лежать на лінії нульового простору. Передача їх через дає нуль, оскільки . При вихідному зміщенні залишається лише вектор зсуву.
У віджеті відредагуйте введення та виберіть, що досягне того самого вихідного шару. Зберігання компонента простору рядків переміщує вхідні дані на зелену площину без зміни вихідних даних. Зберігання лише компонента нульового простору переміщує його на рожеву лінію та робить обидва виходи нульовими.
Подивіться проекцію у двох вимірах
Наступна анімація полегшує перевірку перпендикулярного руху. Він використовує іншу проекцію на помаранчеву лінію в напрямку :
Виберіть приклад і натисніть Анімувати проекцію або перетягніть введення:
- Вектор, перпендикулярний помаранчевій лінії, такий як , повністю відображається на нуль.
- Вектор на помаранчевій лінії, наприклад , залишається незмінним.
- Будь-який інший вектор втрачає свій перпендикулярний компонент і зберігає свій компонент вздовж оранжевої лінії. Наприклад,
Обидві компоненти є двокоординатними векторами. Синя лінія вже є нульовим пробілом; вектори на ньому рухаються до початку координат, а не до нульового простору. Для цієї ортогональної проекції помаранчева лінія є як простором рядка, так і простором стовпця. Він зберігає різницю між координатами, тоді як наша тривимірна проекція зберігає суму перших двох.
Побудуйте проекцію для навченого шару 128-до-10
Тепер застосуйте той самий процес до навченої мережі: визначте нульовий простір вихідної матриці, видаліть цей компонент із кожного прихованого представлення та переконайтеся, що оцінки залишаються незмінними. Закріпіть кожну вивчену вагу та зміщення та вставте проекцію після прихованого ReLU перед існуючим вихідним шаром:
— існуюча навчена вихідна матриця; — це додаткова матриця, яку ми створюємо. Збереження компонента простору рядків означає заміну на . Оригінальний вихідний рівень все ще отримує 128 значень, але ці значення обмежені його десятивимірним простором рядків. Ці напрямки можуть включати всі 128 координат; ми не вибираємо десять конкретних нейронів.
Іграшкова матриця вище дає змогу легко побачити конструкцію: один рядок читає суму двох координат, а інший читає третю координату. Навчені ваги MNIST можуть змішувати всі 128 координат з різними позитивними та негативними вагами. Нам потрібен загальний спосіб визначення напрямків і побудови проекції. Ось тут і з’являється SVD.
| Іграшковий експеримент | Тренований МНІСТ експеримент | |
|---|---|---|
| Вихідна матриця | ||
| Звання | 2 | 10, виміряний після тренування |
| Вставлена проекція | ||
| Координати, повернуті | 3 | 128 |
| Незалежні напрямки, збережені | 2 | 10 |
| Напрямки нульового простору видалено | 1 | 118 |
| Вплив на вихідні бали | Без змін | Без змін |
Загалом ранг плюс нульовість дорівнює вхідному виміру:
Десять рядків дають ранг не більше десяти; залежні рядки можуть зменшити його. Ми вимірюємо ранг 10 у нашій навченій матриці, тому значення нульового значення дорівнює 118. Вставлена проекція простору рядків має той самий ранг і нульовий простір, що й .
Розрізняйте пробіли: простір рядків і нульовий простір знаходяться всередині , де знаходяться його вхідні вектори. Його колонка живе в десятивимірному просторі балів. Простори рядків і стовпців мають однакову розмірність, але містять різні види векторів. Стаття про вагову матрицю розвиває ці два погляди на множення.
Крок 1: отримати збережені маршрути за допомогою SVD
Щоб ознайомитись із SVD, перегляньте Розкладання сингулярних значень (SVD): математичний огляд. Ми застосовуємо його до навченої матриці вихідних ваг:
Праві сингулярні вектори є стовпцями . Кожен має 128 координат і описує напрямок у прихованому просторі. Його відповідне сингулярне значення говорить нам, наскільки масштабує цей напрямок у вихідний напрямок, визначений . Ті, що пов’язані з ненульовими сингулярними значеннями, утворюють ортонормальну основу для простору рядків: перпендикулярні одиничні вектори, що охоплюють усі напрямки прихованого простору, які можуть впливати на бали.
Ми зберігаємо кожен ненульовий напрямок, а не вибираємо лише кілька великих сингулярних значень. Нам не потрібно збирати активації, щоб виявити цей підпростір: це випливає з самих ваг.
У нашій навченій мережі SVD визначає десять збережених напрямків, що охоплюють простір рядка. Перпендикулярна частина 128-вимірного прихованого простору має 118 незалежних напрямків, які охоплюють нульовий простір вихідної матриці. Кожен вектор у цьому нульовому просторі задовольняє , тому його внесок у всі десять балів дорівнює нулю. Ці напрямки можуть включати комбінації багатьох активацій; це не обов’язково 118 окремих нейронів або координат.
Наша вставлена проекція зберігає компонент простору рядків і видаляє весь компонент нульового простору. Оцінки залишаються незмінними, оскільки навчений вихідний рівень уже відображає цей видалений компонент на нуль. Нам не потрібно окремо обчислювати 118 базисних векторів нульового простору: побудова проекції на десять збережених напрямків видаляє все, що перпендикулярно до них. Його вихід все ще містить 128 значень координат.
Крок 2: перетворите ці напрямки на матрицю проекції
Помістіть десять збережених напрямків у стовпці матриці . Щоб спроектувати прихований вектор, спочатку виміряйте його компоненти в кожному напрямку, а потім перебудуйте його, використовуючи лише ці компоненти:
Рівнозначно,
Скаляр вимірює, скільки лежить уздовж напрямку . Множення на створює цей компонент, а додавання всіх десяти компонентів дає проекцію. Ці десять проміжних значень є координатами в основі простору рядків, а не десятизначними оцінками; незмінений вихідний рівень все ще обчислює бали пізніше.
Для порівняння, наша вихідна матриця іграшок використовувала рядки і . Нормалізація їх дає
Це перпендикулярні одиничні вектори в площині простору рядків. Розмістивши їх у стовпцях матриці і побудувавши , ви отримаєте проекцію усереднення, яку ми побудували вище: . SVD надає ортонормований базис, коли рядки не дуже зручні.
Ось така сама конструкція для вивчених ваг:
# head.weight has shape (10, 128).
W = head.weight.detach().double()
_, singular_values, Vh = torch.linalg.svd(W, full_matrices=False)

# A numerical threshold determines which singular values count as nonzero.
tolerance = max(W.shape) * torch.finfo(W.dtype).eps * singular_values.max()
rank = int((singular_values > tolerance).sum())
Q = Vh[:rank].T                       # (128, 10) in our trained model
P_row = Q @ Q.T                      # (128, 128), rank 10
P_null = torch.eye(128, dtype=W.dtype) - P_row  # rank 118
Кроки 3 і 4: втрутитися в активації та перевірити бали
Застосуйте проекцію між одним і тим самим екстрактором елементів і вихідною головкою. Для пакету PyTorch зберігає приховані вектори як рядки, тому формула вектор-стовпець стає h @ P.T:
with torch.inference_mode():
    h = feature_extractor(test_x)     # (10000, 128)
    original_logits = head(h)
    row_logits = head(h @ P_row.T)
    null_logits = head(h @ P_null.T)

torch.testing.assert_close(row_logits, original_logits, atol=1e-10, rtol=0)
torch.testing.assert_close(
    null_logits, head.bias.expand_as(null_logits), atol=1e-10, rtol=0
)
assert torch.equal(row_logits.argmax(1), original_logits.argmax(1))
print((row_logits.argmax(1) == test_y).double().mean().item())
Для того самого зображення прихований шар все ще створює той самий . Немає зворотного проходу або оновлення ваги; змінюється тільки вектор, переданий на вихідний шар.
Кожен прихований вектор однозначно розбивається на дві перпендикулярні компоненти:
Пропускання кожного компонента через один вихідний рівень дає дві гарантії, які ми перевіримо:
Проекція простору рядків зберігає кожну оцінку, отже, кожну ймовірність і прогноз. Проекція в нульовому просторі залишає лише зміщення, даючи однаковий розподіл ймовірностей для кожного зображення. Ми зберігаємо 118 незалежних вказівок у цій другій умові, але жодної, яку ця голова може прочитати.
Геометрія є специфічною для цього вихідного шару. Напрямок, який він ігнорує, може містити інформацію, яку може використовувати інший класифікатор. Подібним чином повна мережа є нелінійною: її оригінальні приховані активації не обов’язково утворюють підпростір. Проекція обмежує їх одним.
Спроектований прихований вектор може містити від’ємні значення, навіть якщо вихідні вихідні дані ReLU є невід’ємними. Вставлений шар є лінійним; додавання іншого ReLU до остаточної зваженої суми порушить гарантію. Експеримент використовує float64 для проектування та оцінки, тому округлення невелике. Він приводить навчені параметри один раз і використовує однакові значення в усіх умовах; це не перенавчає їх.
Чому зміна подання не повинна змінювати прогноз
Проекція змінює відстані, а також координати. Для двох прихованих векторів,
Для конкретного прикладу трьох координат візьміть і . Їх різниця , довжиною . Він лежить у нульовому просторі. Обидва проектуються на , тому їх відстань стає нульовою, тоді як обидва набори оцінок залишаються .
Загалом, проекція видаляє відмінності нульового простору та зберігає відмінності простору рядка. Відстань у прихованому просторі може зменшуватися, а різниця в балах залишається незмінною:
Отже, велика активація або відстань автоматично не означає важливості цього прогнозу: вихідний рівень може ігнорувати цей напрямок. Тут ми активно змінюємо вектори. Просте вираження тих самих векторів в іншому базисі збереже як вектори, так і їхні відстані.
Методологія: виявлення, ізоляція та втручання
У великих навчених мережах знання того, як обчислити кожен вихід не відкриває автоматично, що кодують внутрішні представлення або як мережа їх використовує. Вектори забезпечують загальний спосіб кодування об’єктів, їхніх властивостей і зв’язків між ними. Ті самі математичні інструменти можуть представляти вимірювання яблук для класифікації стиглості, пікселі зображення для розпізнавання об’єктів або концепції та зв’язки для розуміння та створення мови.
Репрезентаційний аналіз вивчає, яку інформацію кодують внутрішні вектори та як вона організована. Механічна інтерпретація досліджує, як компоненти мережі використовують цю інформацію для створення своєї поведінки. Ці підходи збігаються, але пошук інформації в представленні сам по собі не означає, що мережа її використовує.
Керований підхід до вивчення вивчених представлень полягає у ідентифікації властивості-кандидата, ізоляції його ефектів якомога ретельніше, а потім перевірці, що насправді робить зміна його представлення. Цей експеримент починається з властивості, яку ми можемо точно визначити: чи може напрямок прихованого простору вплинути на результати кінцевого шару. Ми ще не намагаємося ідентифікувати семантичну властивість, таку як колір або форма штриха.
З точки зору механістичної інтерпретації, ми поєднуємо аналіз ваги з контрольованим втручанням в активації. Інструменти виконують різні кроки:
| Методологічний крок | Інструмент і його призначення |
|---|---|
| Визначте цікаву властивість | Аналіз ваги: запитайте, які приховані напрямки можуть змінити бали, використовуючи навчену вихідну матрицю. |
| Виділіть відповідні компоненти | SVD і ортогональна декомпозиція: створюють базу простору рядків і розбивають кожен прихований вектор на компоненти, які рівень може і не може читати. |
| Змінюйте лише ці компоненти | Проекція та втручання активації: зберігайте компонент простору рядка або нульового простору після прихованого ReLU. Збережіть зображення та всі вивчені ваги та зміщення фіксованими. |
| Випробуйте наслідки | Парне оцінювання: порівняйте логіти, ймовірності, прогнози та точність на тих самих тестових зображеннях; перевірте алгебраїчні тотожності та незмінні параметри. |
Реалізація використовує PyTorch для навчання та заморожування мережі, torch.linalg.svd для отримання основи та множення матриці для застосування проекторів. Обчислення Float64 і числові твердження перевіряють збереження оцінки та вихід лише зміщення. Інтерактивні приклади відображають записані прогнози з цих оцінок.
Ми використовуємо [скорочений SVD] PyTorch (https://docs.pytorch.org/docs/2.7/generated/torch.linalg.svd.html) із full_matrices=False на ЦП. Він обчислює всі десять сингулярних значень вагової матриці та пов’язані з ними напрямки, пропускаючи додаткові базисні вектори. Це стандартна чисельна декомпозиція, а не приблизний алгоритм, який обчислює лише кілька провідних напрямків.
Висновок має точну алгебраїчну гарантію: ми можемо підтвердити збереження оцінки або вихід лише зміщення перед оцінкою окремого зображення. Експеримент перевіряє, чи відповідає наша реалізація цим ідентифікаторам. Він визначає те, що читає останній лінійний шар, не присвоєння вказівкам таких значень, як «петля» чи «штрих», і не пояснюючи, як їх засвоїли попередні шари.
Чотири запитання для наступного експерименту
Дослідження ValueShift Research Як їх відкрити – Частина I розділяє чотири завдання під час вивчення репрезентацій: їх пошук, встановлення їх причинної ролі, перевірка їх необхідності та керування поведінкою через них. Наш експеримент із лінійним шаром є корисною відправною точкою з вужчим масштабом:
| Робота | Що встановлює цей експеримент |
|---|---|
| Знайдіть представництво | SVD ідентифікує підпростір, який зчитує вихідний рівень. Він не ідентифікує таке семантичне поняття, як петля чи штрих. |
| Установіть його причинну роль | Зміна компонента нульового простору не може вплинути на бали; видалення всього компонента простору рядків залишає лише зміщення. |
| Перевірте його необхідність | Компоненти нульового простору непотрібні для виведення цієї головки. Видалення всього компонента простору рядків усуває бали, що залежать від зображення, але не показує, що кожен збережений напрямок окремо необхідний для правильного передбачення. |
| Поведінка керма | Проекція простору рядків зберігає поведінку; проекція нульового простору робить його постійним. Жоден не демонструє корисної цільової корекції. |
Кольорове дослідження MNIST застосовує всі чотири запитання до властивості кандидата: кольору. Він знаходить напрямки від контрольованих перефарбувань і перевіряє, чи змінює придушення або заміна їхніх компонентів рішення замороженого класифікатора.
Що вимірює експеримент
Ми тренуємо ту саму щільну архітектуру на оригінальних 60 000 навчальних зображень MNIST у відтінках сірого та оцінюємо на оригінальних 10 000 тестових зображеннях. Ми використовуємо початковий код 42, вісім епох Адама, швидкість навчання 0,002, пакети з 512 і два потоки ЦП. Це свіжий відтворюваний тренувальний запуск із архітектурою попередньої статті, а не претензія на повторне використання оригінальних збережених ваг чи налаштувань оптимізатора.
Повний експеримент було повторно запущено 8 жовтня 2026 року з використанням Python 3.12.13, PyTorch 2.7.1+cpu та NumPy 2.2.6 у Linux. Тристороннє порівняння перевіряє точність, усі десять логітів, ймовірності та прогнози для кожного зображення. Він також перевіряє, чи вивчені тензори залишаються незмінними, що обидва проектори є ідемпотентними, і що результат нульового простору узгоджується з вектором зміщення.
| Представництво | Незалежні збережені напрямки | Перевірка точності |
|---|---|---|
| Оригінальний прихований вектор | 128 | 97.27% |
| Зберігайте простір рядка вихідного шару | 10 | 97.27% |
| Зберігайте нульовий простір вихідного шару | 118 | 8.92% |
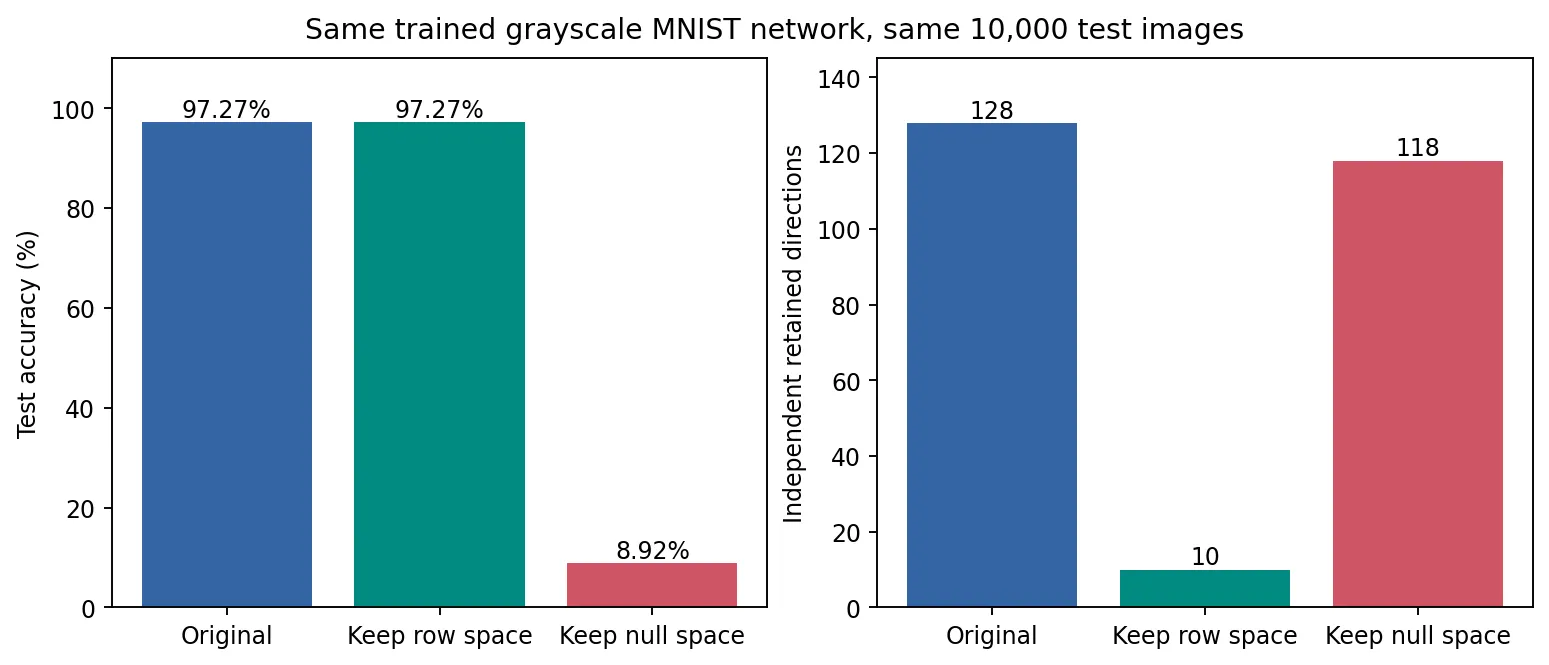
Вивчена вихідна матриця має ранг 10. Проекція простору рядків змінює нульові прогнози на всіх 10 000 тестових зображень. Його найбільша логітична різниця з вихідною оцінкою становить приблизно , а найбільша різниця ймовірностей становить приблизно , що відповідає округленню з плаваючою комою.
Проекція в нульовому просторі змушує модель прогнозувати 5 для кожного зображення: цей клас має найбільше вивчене зміщення. Його точність 8,92% — це частка 5 у цьому тестовому наборі, а не випадкове вгадування. Найбільша різниця між його логітами та вектором зсуву становить близько .
Усі вивчені тензори залишаються ідентичними за трьома умовами. Приведення навченої моделі до float64 для оцінки не змінило жодного з її початкових прогнозів. Це одне фіксоване початкове число навчання, але алгебраїчні гарантії не залежать від отримання конкретної базової точності.
Ці перевірки відокремлюють алгебраїчне твердження від будь-якої конкретної оцінки точності. Проекція простору рядків також зберігає наявні помилки класифікатора; це не техніка підвищення точності. Проекція в нульовому просторі видаляє кожен залежний від зображення внесок, який може прочитати ця голова, хоча збережене представлення все ще може містити інформацію для іншої голови.
Ось чому просто підрахувати розміри недостатньо. Невеликий збережений підпростір може зберегти кожен прогноз, тоді як набагато більший може змусити цей класифікатор повністю ігнорувати свої вхідні дані.
Окреме питання: чи допоможе видалення маршрутів?
Точна проекція вище зберігає або знищує те, що читає вихідний шар. Інше питання полягає в тому, чи можемо ми покращити його рішення, приховуючи вказівки, які він використовує в оманливий спосіб.
Незалежний експеримент коли видалення функцій покращує заморожений класифікатор досліджує це питання за допомогою кольорових цифр. Він оцінює приховані напрямки, пов’язані з кольором, і вимірює як користь від оманливих кольорів, так і вартість для знайомих кольорів. Цей результат є емпіричним; тотожності простору рядка та нульового простору тут безпосередньо випливають із вивченої матриці.
Відтворіть експеримент
Завантажте самодостатній сценарій експерименту, офлайн тести, висунуті вимоги і зафіксовані результати. Розмістіть сценарій, тести та вимоги в одному каталозі:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python -m unittest discover -s . -p 'test_classifier_subspaces.py' -v
python classifier_subspaces.py --quick
python classifier_subspaces.py
Вимоги спрямовані на CPU PyTorch у Linux. Сценарій завантажує MNIST під час першого запуску, тренує базову лінію, заморожує її та оцінює всі три представлення. Результати, цифра точності/розміру, контрольна точка та записані приклади записуються в out-classifier/. Повний запуск зайняв близько шести секунд на тестовій машині. Використовуйте --quick для окремого димового тесту з 2000 тренувальних зображень / 1000 тестових зображень із двома епохами та виведенням у out-classifier-quick/.
Чотири офлайн-тести пройшли успішно: вони перевіряють навчальні оновлення, вставлений шар із замороженими параметрами, вихідну матрицю з недоліком рангу та нульову вихідну матрицю. Випробування димом і повний експеримент також пройшли всі численні твердження. Ці твердження порівнюють оцінки та прогнози, перевіряють тотожність проекцій і підтверджують, що вивчені тензори залишаються незмінними. Наведені вище фрагменти Python були виконані відповідно до повного набору даних.
JSON записує мітку часу виконання, версії Python і бібліотеки, хеш набору даних, початкове значення, налаштування навчання, сингулярні значення, допуск до рангу, точність, зміни прогнозів, помилки logit/імовірності та перевірки геометрії. Провідник цифр використовує записані результати для перших трьох тестових зображень кожної цифри. Його елементи керування вибирають ці записи; вони не запускають і не перенавчають мережу в браузері.