Видалення та заміна ознак у замороженому класифікаторі
У нашому першому експерименті підпростору MNIST ми перевірили навчену вихідну матрицю та видалили компонент прихованого представлення в її нульовому просторі. Оцінки залишилися ідентичними, оскільки вихідний рівень уже відобразив цей компонент на нуль. Ми могли б суттєво змінити представлення, не змінюючи передбачення класифікатора.
Тут ми робимо наступний крок: що станеться, коли ми змінимо компоненти, пов’язані з властивістю, яку може фактично використовувати класифікатор? Ми визначимо напрямки, пов’язані з кольором, потім придушимо їхні компоненти або замінимо їх значеннями з різнокольорової версії тієї самої цифри. Прогнози тепер можуть змінюватися; наше питання полягає в тому, чи ці зміни допомагають чи шкодять.
Класифікатор цифр може вивчати корисні підказки форми та ярлик одночасно. Якщо більшість навчальних зображень певної цифри мають спільний колір, колір допомагає передбачити мітку. Коли цей зв’язок змінюється, той самий засвоєний ярлик може збити мережу з шляху. Це дає нам властивість для дослідження та конкретну причину для втручання в її представлення.
Частина, яку ми досліджуватимемо, — це вихід прихованого шару: вектор із 128 активацій, переданих до остаточного рівня класифікації. Ці активації обчислюються заново для кожного зображення; вони не ваги. Вивчені вагові матриці є збереженими параметрами, які спільно використовуються для входів. Ми зберемо приховані вектори для різних перефарбувань тих самих зображень і застосуємо сингулярне розкладання (SVD) до їхніх центрованих відмінностей, щоб визначити напрямки, пов’язані з кольорами. Потім ми змінюємо компоненти у цих напрямках, зберігаючи вивчені ваги обох шарів фіксованими, і вимірюємо, як змінюються остаточні бали та прогнози.
У цьому експерименті ми навчаємо невелику мережу на кольорових рукописних цифрах, заморожуємо її вивчені ваги та вставляємо лінійне перетворення безпосередньо перед останнім класифікаційним шаром. Видалення двох передбачуваних пов’язаних із кольорами напрямків покращує точність оманливих кольорів з 85,91% до 90,57%, усереднене за трьома навчальними насадками. Це також знижує точність знайомих кольорів з 98,09% до 97,14%. Втручання допомагає за одних умов і вимагає точності за інших.
Потім ми зберігаємо ті самі вибрані напрямки та замінюємо їхні компоненти значеннями з перефарбованих версій тих самих зображень. Це перевіряє, які зміни в ймовірності цифр можна спричинити редагуванням лише цих компонентів, і як це порівнюється з фактичним перефарбуванням вхідних даних. Обидва експерименти змінюють уже вивчене уявлення; а також не перенавчає мережу.
Від напрямків, які класифікатор ігнорує, до напрямків, пов’язаних із кольором
Обидві статті використовують SVD для визначення напрямків і вставки трансформації між прихованим представленням і замороженим вихідним шаром. Різниця полягає в тому, яку матрицю ми аналізуємо та що нам говорять її напрямки:
| Перший експеримент: нульовий простір вихідного шару | Цей експеримент: колірно-асоційовані напрямки | |
|---|---|---|
| Матрицю аналізуємо | Навчені вихідні ваги | Записані відмінності активації , спричинені перефарбуванням |
| Напрямки, які ми визначаємо | Що вихідний рівень читає та ігнорує | Де перефарбування найбільше змінює приховане представлення |
| Втручання | Видаліть компонент, який класифікатор уже ігнорує | Придушити або замінити вибрані кольорові компоненти |
| наслідок | Кожна оцінка залишається ідентичною, що гарантується | Оцінки та прогнози можуть змінюватися; ми вимірюємо, чи це допомагає |
Припускається, що асоційовані з кольором напрямки не лежать у нульовому просторі вихідної матриці. Якби вони це зробили, зміна їхніх компонентів залишила б усі бали незмінними. Тільки їхні компоненти в просторі рядків вихідної матриці можуть впливати на її бали. Наше втручання перевіряє, чи напрямки, які ми виявляємо, впливають на прогнози та чи цей вплив є корисним у різних колірних умовах.
Це нова мережа, навчена на кольорових зображеннях, використовуючи такий же щільний прихований шар і лінійний вихідний шар. У кожному експерименті ми порівнюємо ту саму треновану мережу до та після втручання з фіксованими вивченими вагами.
Завдання та ярлик
Кожен вхідний сигнал є цифрою MNIST, відтвореною одним із десяти кольорів. Її міткою все ще є цифра від 0 до 9. Мережа має щільний прихований шар із 128 активаціями ReLU та останній шар із десятизначними оцінками. RGB дає йому вхідні значення:
Кольорове зображення → 128 вивчених активацій → десятизначний результат → прогноз
Кожній цифрі призначаємо один визначений колір. Під час навчання ми використовуємо цей колір з імовірністю 0,9; інакше вибираємо рівномірно з усіх десяти кольорів, включаючи позначений. Тому ефективна ймовірність зазначеного кольору становить 0,91.
Ми оцінюємо три умови, використовуючи однакові форми тестових цифр:
| Стан | Правило кольору |
|---|---|
| Знайомі кольори | Така ж асоціація, як навчання: кожна цифра зазвичай отримує свій колір. |
| Незалежні кольори | Колір відбирається рівномірно, незалежно від мітки цифри. |
| Кольори, що вводять в оману | Кожна цифра зазвичай отримує колір, призначений для наступної цифри, повертаючи 9 назад до 0. |
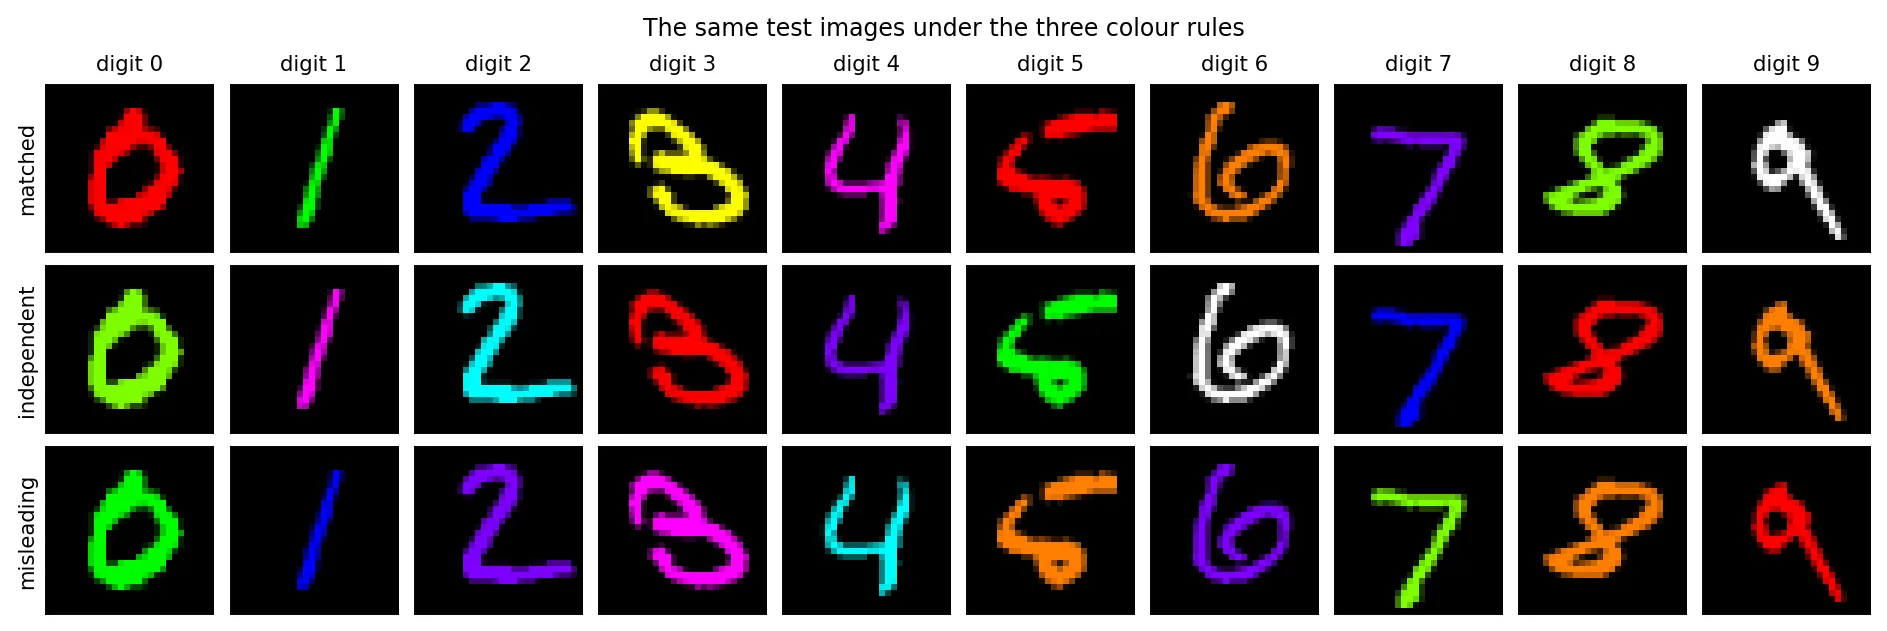
У кожному стовпці показано одне й те саме вихідне зображення за трьома правилами кольорів. Це перші тестові зображення кожної цифри. Деякі кольори можуть збігатися, оскільки правила включають випадкову вибірку.
Це десятикласовий кольоровий варіант MNIST, натхненний експериментами з мінімізації інваріантного ризику. Ми не відтворюємо бінарне завдання цієї статті чи її метод навчання. Наше запитання стосується втручання у вже навчену мережу.
Створіть і навчіть мережу в PyTorch
Ми використовуємо nn.Linear і nn.ReLU для створення класифікатора. Вихідний рівень повертає десять логітів; PyTorch перехресна втрата ентропії споживає ці оцінки безпосередньо. Softmax потрібен лише тоді, коли ми хочемо перевірити ймовірності.
У наведеному нижче коді показано початкове значення 42. colored_mnist_intervention.py, який можна завантажити, надає завантажувач набору даних і помічники для передачі кольорів, а також запускає повний експеримент для вихідних даних 42, 43 і 44. Спочатку підготуйте ті самі розбиття для навчання, калібрування та перевірки, що й цей сценарій:
from pathlib import Path
import numpy as np
import torch
from torch import nn
from colored_mnist_intervention import load_mnist, render, sample_colours

torch.set_num_threads(2)
torch.use_deterministic_algorithms(True)
(train_images, train_labels, test_images, test_labels), _ = load_mnist(
    Path.home() / ".cache/mirror-span"
)
images = torch.from_numpy(train_images.reshape(-1, 784).astype(np.float32) / 255)
labels = torch.from_numpy(train_labels.astype(np.int64))
order = np.random.default_rng(0).permutation(len(images))
train_indices, calibration_indices, validation_indices = np.split(order, [50000, 55000])
train_y = labels[train_indices]
train_colors = sample_colours(train_y.numpy(), "aligned", 0.9, seed=1000)
train_x = render(images[train_indices], train_colors)  # (50000, 2352)
calibration_x = images[calibration_indices[:2000]]    # grayscale, recolored below
Вихідне зображення визначає просторовий малюнок; render помножує цей візерунок на запис палітри RGB і вирівнює три канали. Навчальні зображення отримують один фіксований колір. Калібрувальні зображення є окремими зразками рукописного тексту, кожен з яких відображається в кожному кольорі, коли ми оцінюємо підпростір.
seed = 42
torch.manual_seed(seed)
model = nn.Sequential(
    nn.Linear(3 * 784, 128),
    nn.ReLU(),
    nn.Linear(128, 10),
)
optimizer = torch.optim.Adam(model.parameters(), lr=0.002)
generator = torch.Generator().manual_seed(seed + 1)
model.train()
for epoch in range(8):
    for indices in torch.randperm(len(train_x), generator=generator).split(512):
        optimizer.zero_grad(set_to_none=True)
        logits = model(train_x[indices])
        loss = nn.functional.cross_entropy(logits, train_y[indices])
        loss.backward()
        optimizer.step()

model.eval().requires_grad_(False)
feature_extractor = model[:2]
classification_layer = model[2]
backward() обчислює градієнти, а Адам оновлює обидва шари під час навчання. Після цього requires_grad_(False) заморожує всі вивчені параметри; eval() вибирає режим оцінювання. Усі подальші експерименти із придушення та заміни повторно використовують ті самі шари. Цей експеримент навчається та обчислюється у float32, тоді як експеримент із нульовим простором використовує оцінку float64 для перевірки точних ідентифікацій збереження балів.
Змінити вивчене представлення, а не вивчені ваги
Для зображення екстрактор функцій створює вектор із 128 активаціями. Останній шар обчислює
де містить десятизначні оцінки. Найбільший бал визначає прогноз; softmax може перетворювати оцінки в ймовірності.
Після тренування обидві частини заморожуємо. Для придушення вставляємо між ними матрицю :
Зображення того самого кольору → той самий екстрактор функцій → вставлене перетворення → той самий шар класифікації
Для заданої умови оцінювання тензор зображення та його оригінальні приховані активації є ідентичними до та після вставки. Змінюється лише представлення, яке передається на останній шар. Після подальшого оновлення градієнта та додаткової функції активації немає.
Compare recorded predictions before and after removing two color-associated directions.
Color: red
Test image #7
The projection changes hidden activations; it leaves this input image and every learned weight unchanged. Results are from seed 42, using a full rank-2 removal. Each digit is its first occurrence in the test set. Changing the color condition selects another recorded input, not a new training run.
Початковий приклад у провіднику — це 9, яке заморожена мережа передбачає як 4 під оманливим кольором. Після проекції він передбачає 9. Інші приклади залишаються правильними, залишаються неправильними або стають неправильними. Повний набір тестів визначає, чи допомагає втручання в цілому.
Знайдіть маршрути, пов’язані з кольором
Ми не припускаємо, що певний прихований нейрон представляє червоний колір або що інший представляє форму цифри. Натомість ми вимірюємо, що змінюється всередині мережі, коли форма залишається фіксованою, а колір змінюється.
Для ознайомлення з декомпозицією, яку ми використовуємо, див. Розклад сингулярних значень (SVD): математичний огляд.
Тут ми відкриваємо можливі напрямки з відповідей моделі на контрольовані зміни вхідних даних. Процедура така:
- Візьміть 2000 калібрувальних зображень, окремо від навчальних і тестових наборів, і відтворіть кожне у всіх десяти кольорах.
- Записуйте 128 прихованих активацій замороженої мережі для кожного візуалізації.
- Відніміть середній вектор активації кожного вихідного зображення за десятьма кольорами.
- Складіть ці відмінності в матрицю та застосуйте сингулярне розкладання (SVD).
Що означає «записати активації»? Модель зберігає вивчені ваги та зміщення, але обчислює нове представлення для кожного входу: . Для одного зображення це вектор із 128 чисел, які зберігаються в пам’яті під час проходу вперед. Збір цих векторів у вигляді рядків дає матрицю подання з одним рядком на вхід і одним стовпцем на приховану активацію. Ця матриця є обчисленими даними, а не іншим набором вивчених ваг, приєднаних до шару, і зазвичай вона не зберігається разом із моделлю. Тут ми явно збираємо представлення для всіх 20 000 візуалізацій, а потім віднімаємо середнє представлення кожного вихідного зображення за кольорами, щоб побудувати матрицю, яку аналізуємо за допомогою SVD.
Для зображення , відтвореного в кольорі , центрована активація
Кожна різниця описує рух у прихованому просторі, пов’язаний зі зміною кольору тієї самої цифри. Об’єднання 20 000 різниць дає матрицю форми . Розкладаємо його як
Його провідні праві сингулярні вектори, стовпці , пов’язані з найбільшими сингулярними значеннями, визначають напрямки, уздовж яких ці відмінності змінюються найбільше. Кожен вектор має 128 координат, оскільки він живе у прихованому просторі активації. Це шаблони активацій, а не список окремих нейронів, які потрібно вимкнути.
Ці вибрані напрямки охоплюють частину простору рядків , матриці записаних відмінностей активації. Це інший простір рядків, ніж вихідні ваги : описує, як представлення змінюються під час перефарбування, тоді як визначає, як представлення впливають на бали.
Це також аналіз основних компонентів (PCA) центрованих відмінностей активації. У межах кожного зображення сума десяти відмінностей дорівнює нулю, тому рядки мають нульове середнє значення. Тому правильні сингулярні вектори є напрямками головних компонентів; їхні квадратичні сингулярні значення вимірюють зміну, зафіксовану вздовж кожного напрямку. Ми центруємо кожне зображення, щоб аналіз слідував за змінами, пов’язаними з перефарбуванням цього зображення, а не за варіаціями між зображеннями непов’язаних цифр.
Ось розрахунок PyTorch. Розмір партії залишається першим, тому stacks[i, c] є прихованим представленням калібрувального зображення i у кольорі c:
with torch.inference_mode():
    stacks = torch.stack([
        feature_extractor(render(calibration_x, np.full(len(calibration_x), color)))
        for color in range(10)
    ], dim=1)                                      # (2000, 10, 128)
    D = (stacks - stacks.mean(dim=1, keepdim=True)).reshape(-1, 128)
    _, singular_values, Vh = torch.linalg.svd(D, full_matrices=False)
    U_all = Vh.T                                  # columns: candidate directions

# The full script selects rank and strength on validation data.
# These are the values selected for seed 42 in the recorded run.
rank, strength = 2, 1.0
U = U_all[:, :rank]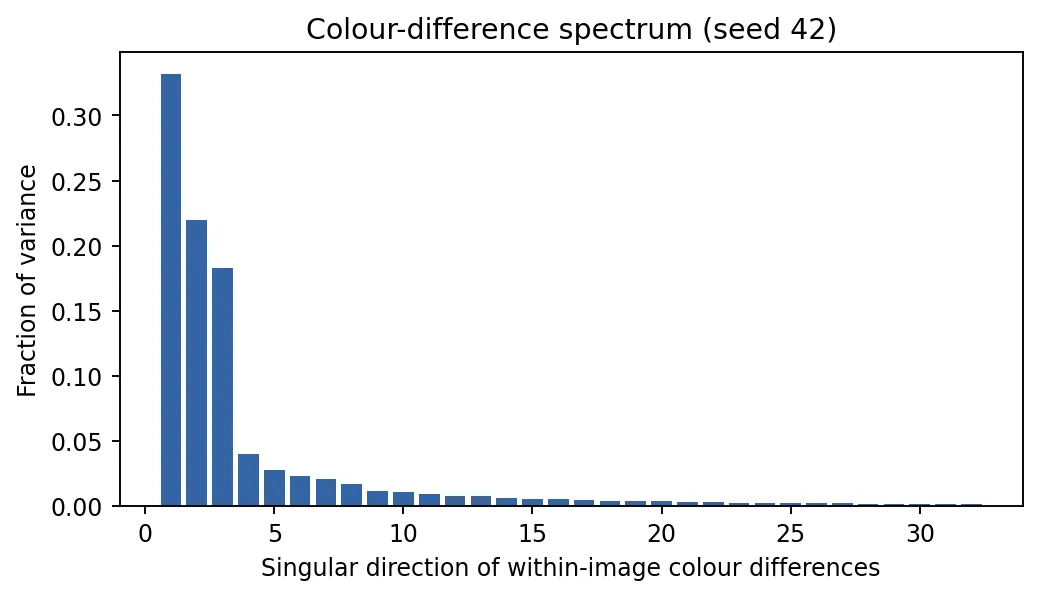
Для насінини 42 на перші три напрямки припадає приблизно 73% квадратичної варіації в цій калібрувальній матриці. Це не означає, що вони містять 73% усієї інформації про колір або що вони є елементами чистого кольору. Екстрактор ознак є нелінійним: зміни кольору можуть впливати на реакцію на форму. Тому ми називаємо ці приблизні напрямки, пов’язані з кольором.
Вставте проекцію на решту напрямків
Нехай стовпці є ортонормальними напрямками, вибраними з цього розкладання. Матриця проектує прихований вектор на їхню частину. Вставляємо
Параметр контролює, наскільки сильно ці компоненти пригнічуються:
- У рівень є ідентичністю.
- У вибрані компоненти зменшуються навпіл. Трансформація все ще оборотна і має ранг 128: вона змінює їхній вплив, не стираючи їх.
- У він проектує їх повністю. Його нульовий простір є діапазоном , а його вихід лежить в ортогональному доповненні. Його ранг .
У повному обсязі нульовий простір нашої вставленої матриці є вибраним пов’язаним із кольором підпростором. Його простір рядків і стовпців є перпендикулярним доповненням: напрямки, які ми зберігаємо. У першій статті ми побудували проекцію, нульовий простір якої відповідав тому, що навчений вихідний рівень уже ігнорував. Тут ми створюємо проекцію, нульовий простір якої містить те, що ми вирішили придушити, а потім перевіряємо наслідки для незмінного вихідного шару.
Для двонаправленої повної проекції шар усе ще виводить 128 чисел, але ці виходи мають лише 126 незалежних напрямків. Остаточний класифікатор отримує менше інформації. При половинній силі жоден напрямок не відображається на нуль: вибрані компоненти стискаються, але нульовий простір перетворення містить лише нульовий вектор.
# U contains orthonormal hidden-space directions, shape (128, r).
A = torch.eye(128) - strength * (U @ U.T)

# For a batch, examples and hidden vectors are stored as rows.
with torch.inference_mode():
    source_images = render(calibration_x[:16], np.zeros(16, dtype=np.int64))
    h = feature_extractor(source_images)
    changed_h = h @ A.T
    logits = classification_layer(changed_h)
Виконуваний експеримент також загортає цю операцію в явний фіксований шар і перевіряє узгодження її логітів із прямим обчисленням. Матриця є буфером, тому вона зберігається разом із модулем, але не є параметром, який можна навчити:
class FixedLinear(nn.Module):
    def __init__(self, matrix):
        super().__init__()
        self.register_buffer("matrix", matrix.clone())

    def forward(self, h):
        return h @ self.matrix.T

intervened = nn.Sequential(feature_extractor, FixedLinear(A), classification_layer).eval()
with torch.inference_mode():
    torch.testing.assert_close(intervened(source_images), logits)
Напрямки масштабування змінюють відстані між прикладами
Трансформація змінює, наскільки далеко одне від одного розташовані представлення вздовж вибраних напрямків. Запишіть , де — компонент у вибраному діапазоні, пов’язаному з кольором, а — перпендикуляр до нього. Потім
Для невеликої ілюстрації використовуйте дві ортонормовані осі: одну вибраний напрямок, пов’язаний із кольором, і одну перпендикулярну. Ці координати описують комбінації нейронів, і припускається, що друга вісь не представляє чисту форму. Розглянемо два гіпотетичних представлення:
| Втручання | Перший вектор | Другий вектор | Відстань між ними |
|---|---|---|---|
| Ідентичність | 2 | ||
| Придушення напівсили | 1 | ||
| Повне видалення | 0 |
Цифри ілюструють операцію; вони не є виміряними координатами з нашої навченої моделі. Перпендикулярний компонент залишається фіксованим, тоді як вибрана різниця зменшується, а потім зникає. Половина сили зберігає можливість відновлення вихідних векторів шляхом зворотного перетворення; повне видалення зливає їх безповоротно.
Для будь-якої пари прихованих представлень те саме правило випливає з лінійності:
Якщо , ортогональність дає квадрат відстані після втручання:
Пари, які відрізняються переважно за обраними напрямками, зближуються. Пари, відмінності яких перпендикулярні цим напрямкам, зберігають свою відстань. Видалення двох передбачуваних напрямків не гарантує, що кожне перефарбування цифри стане ідентичним: пов’язані з кольорами відмінності можуть залишатися за межами їх діапазону.
Загальна вивчена матриця може посилювати, зменшувати або перенаправляти відмінності. Наша вставлена трансформація спеціально стискає вибрані компоненти, зберігаючи перпендикулярні. Це змінює баланс внесків, що надходять до замороженого класифікатора. Чи допоможе це, залежить від того, що читає класифікатор: його різниця балів для пари стає . Зближення представлень одне до одного не є самим по собі покращенням класифікації. Ми вимірюємо прогнози, щоб з’ясувати, чи допомагали чи шкодили пригнічені відмінності для кожного кольору.
Методологія: виявлення, ізоляція та втручання
Дослідження ValueShift Research Як їх відкрити – Частина I організовує вивчення репрезентацій у чотири завдання: знайти репрезентацію, встановити її причинну роль, перевірити її необхідність і керувати поведінкою через неї. Публікація присвячена пошуку представництв у LLM. Ми можемо адаптувати його чотири питання до цього меншого класифікатора, де колір є властивістю, яку ми можемо змінювати, не змінюючи почерк і цифрову мітку.
- Знайдіть представлення концепції. Знайдіть напрямки або більш складну структуру, пов’язану з цікавою властивістю. Тут ми перефарбовуємо кожне калібрувальне зображення, збираємо його приховані активації, віднімаємо його середнє значення за кольорами та застосовуємо SVD/PCA до цих відмінностей. Провідні напрямки є кандидатами на представлення колірних варіацій. Це створює асоціацію; це ще не показує, що класифікатор використовує їх, або що вони кодують лише колір.
- Встановіть його причинну роль. Змініть компоненти-кандидати, утримуючи фіксовані вхідні дані та вивчені ваги, а потім виміряйте наслідки. Ми пригнічуємо ці компоненти або замінюємо їх координатами від перефарбованого донора. Зміни в логітах, ймовірностях і прогнозах визначають ефект цього втручання в прихований простір. Елементи керування випадковими підпросторами допомагають відрізнити ефекти вибраних напрямків від довільних редагувань. Причинна претензія стосується цих компонентів; їх інтерпретація як чистого кольору залишається недоведеною.
- Перевірте його необхідність. Запитайте, чи поведінка, яка вас цікавить, може зберігатися без вибраних компонентів. Тут поведінка є чутливістю до вивченої асоціації колір-цифра, а не розпізнавання цифри в цілому. Повна проекція видаляє вибрані компоненти, але не усуває вплив кольору. Виправлення перпендикулярного компонента також змінює прогнози. Ці результати підтверджують внесок вибраного діапазону, а не твердження, що це єдиний шлях для колірних ефектів або необхідний для кожної помилки, спричиненої кольором. Придушення половинної сили не може встановити необхідність шляхом видалення, оскільки воно залишає присутніми компоненти.
- Керуйте поведінкою через представлення. Використовуйте втручання, щоб отримати бажану зміну, і виміряйте її вартість. Ми вибираємо ступінь придушення та силу на основі даних перевірки, а потім оцінюємо на відкладених зображеннях. Придушення покращує точність оманливих кольорів, одночасно знижуючи точність знайомих кольорів. Заміна донора демонструє іншу форму контролю, але вибір донора за допомогою мітки справжньої цифри є лише діагностичним. Жоден результат не встановлює загального покращення безпеки чи надійності моделі.
Роботи розділяють пошук інформації, показ ефекту, тестування залежності та використання цього ефекту. Напрямок може впливати на прогнози, не будучи обов’язковим, і ефективне втручання все одно може зашкодити за іншого розподілу вхідних даних. Наш експеримент надає докази для цих питань з різною силою; він не завершує всі чотири, просто знаходячи два напрямки.
Перший інструмент — це керована зміна введення: утримуйте форму цифри нерухомою, змінюючи її колір, а потім перевірте, як реагують внутрішні активації. SVD/PCA організовує ці відповіді в напрямки для кандидатів. При повній потужності придушення є підпросторовою абляцією: видаліть компонент вектора активації у вибраному діапазоні та спостерігайте, як поводиться заморожений класифікатор. Натомість при половинній силі ми послаблюємо цей компонент. Експеримент із заміною додає виправлення активації: копіює вибрані компоненти з прямого проходу донора у вихідне представлення.
| Методологічний крок | Інструмент | Що ми робимо в цьому експерименті |
|---|---|---|
| Визначте властивість кандидата | Гіпотеза про навчальні дані | Перевірте, чи вивчений зв’язок між кольором і цифрою сприяє помилкам, коли цей зв’язок змінюється. |
| Виділення його ефектів активації | Контрольоване перефарбування та центрування всередині зображення | Відтворіть кожне калібрувальне зображення в десяти кольорах, запишіть його приховані активації та відніміть його середнє значення за кольорами, щоб отримати . |
| Оцініть кандидатські напрямки | SVD/PCA відмінностей активації | Знайдіть ортонормальні напрямки, що фіксують найбільші зміни, пов’язані з перефарбуванням. Їхнє значення походить від контрольованого експерименту, а не лише від SVD. |
| Виберіть, що змінити | Тривала перевірка | Виберіть, скільки напрямків придушити та на скільки, не використовуючи тестові мітки. |
| Втручатися в представництво | Ортогональна проекція або часткове придушення | Вставте , зберігаючи кожне оціночне зображення та всі вивчені параметри фіксованими. |
| Замінити, а не придушити | Виправлення активації в межах підпростору | Скопіюйте виділені координати з того самого зображення іншого кольору; зберегти перпендикулярну складову джерела. |
| Випробуйте наслідки | Парне оцінювання та керування випадковим підпростором | Вимірюйте зміни прогнозу та точність за знайомих, незалежних і оманливих кольорів; порівняти вибране придушення з випадковими напрямками, що відповідають рангу та силі. |
Реалізація використовує PyTorch для запису заморожених прихованих активацій, torch.linalg.svd для декомпозиції і множення матриці для вставленого перетворення. Для пошуку вказівок не потрібен окремий класифікатор понять: парні перефарбування забезпечують порівняння. Числові перевірки перевіряють перетворення та незмінні вивчені тензори; затримана точність вимірює, чи допомагає це.
Ми використовуємо [скорочений SVD] PyTorch (https://docs.pytorch.org/docs/2.7/generated/torch.linalg.svd.html) із full_matrices=False на ЦП. Він обчислює всі 128 сингулярних значень матриці різниці активації та їхні пов’язані напрямки; потім вибираємо провідні напрямки. Це дозволяє уникнути побудови непотрібної лівої сингулярної векторної матриці , але не є наближеним алгоритмом top-k SVD.
Велика варіація, пов’язана з кольором, сама по собі не доводить, що напрямок має значення для прогнозів. SVD вимірює, наскільки змінюються активації; останній шар може здебільшого ігнорувати ці зміни. Втручання перевіряє, чи змінює придушення вибраних напрямків рішення та точність. Це робить інтерпретацію емпіричною, навіть якщо сама проекція має точне математичне визначення.
Керування вхідною властивістю також не гарантує чисте представлення кольору. Мережа може по-різному реагувати на колір для різних форм. Таким чином, наше твердження обмежується розрахунковими напрямками та їх виміряними ефектами в цій замороженій моделі, а не повним описом її функцій чи обчислень.
Виберіть втручання без використання тестових міток
Оригінальні 60 000 навчальних зображень MNIST розділені на 50 000 для навчання, 5 000 для калібрування та 5 000 для перевірки. Оригінальні 10 000 тестових зображень залишаються невідомими. Оцінка напрямку кольору використовує 2000 зображень із розділення калібрування; він ніколи не використовує тестові зображення.
Ми оцінюємо ранги кандидатів і сильні сторони 0,5 і 1. Вибір максимізує середню точність за трьома умовами перевірки. Ранг 3 було додано після перевірки калібрувального спектру; ця дослідницька зміна реєструється, і ранг 3 не було обрано в жодному циклі.
Всі три тренувальних насіння вибирають два напрямки. Насіння 42 і 44 вибирають повну проекцію; насіння 43 вибирає придушення половинної сили. Ми повідомляємо, що вибране втручання та повна проекція в тому самому вибраному ранзі окремо. Повна проекція - це умова, яка фактично зменшує вихідний діапазон.
Перевірте поведінку перевірки, коли буде видалено більше вказівок
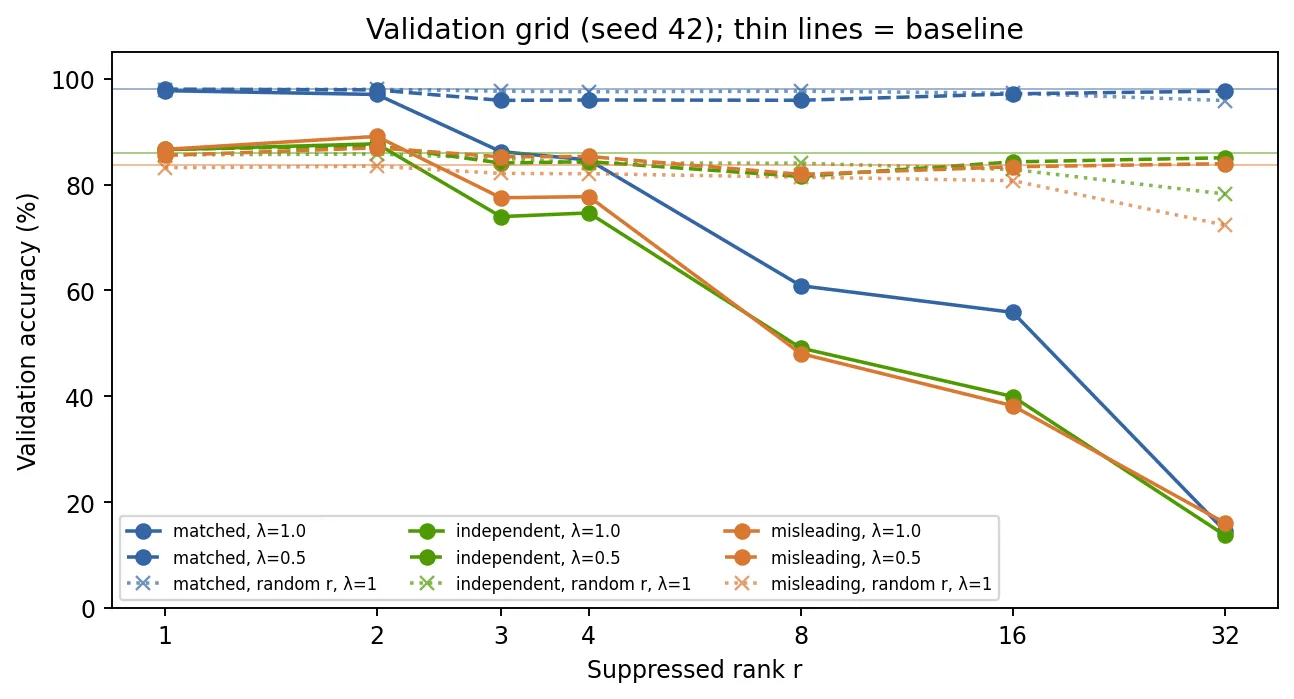
- Видалення кількох вказівок не завжди краще. Зниження рангу 3 саме по собі не означає, що третій напрямок є особливою формою.*
Що трапилося на відкладених зображеннях?
Повний експеримент було повторно запущено 8 жовтня 2026 року з використанням Python 3.12.13, PyTorch 2.7.1+cpu та NumPy 2.2.6 у Linux із двома потоками ЦП. Це середні значення точності тренувальних насінин 42, 43 і 44:
| Втручання | Знайомі кольори | Незалежні кольори | Оманливі кольори |
|---|---|---|---|
| Оригінальна заморожена мережа | 98.09% | 87.05% | 85.91% |
| Придушення, вибране під час перевірки | 97.55% | 88.16% | 90.31% |
| Повна проекція тих же двох напрямків | 97.14% | 87.60% | 90.57% |
| Випадкові напрямки, відповідні вибраному рангу та силі | 98.06% | 86.93% | 85.91% |
Повна проекція покращує точність оманливих кольорів на 4,66 відсоткових пунктів за ціною 0,95 балів для знайомих кольорів. Показники оманливого кольору становлять 89,99%, 90,51% і 91,20% для трьох насінин у порівнянні з базовими показниками 84,33%, 86,91% і 86,49%.
Випадковий контроль використовує три випадкові підпростори на початкове значення, відповідаючи як рангу, так і силі до втручання, вибраного під час перевірки. Це компаратор для вибраного рядка придушення; оскільки початковий елемент 43 вибирає половинну силу, це не є однорідним контролем повної проекції. Випадкові зміни не призводять до порівнянного покращення.
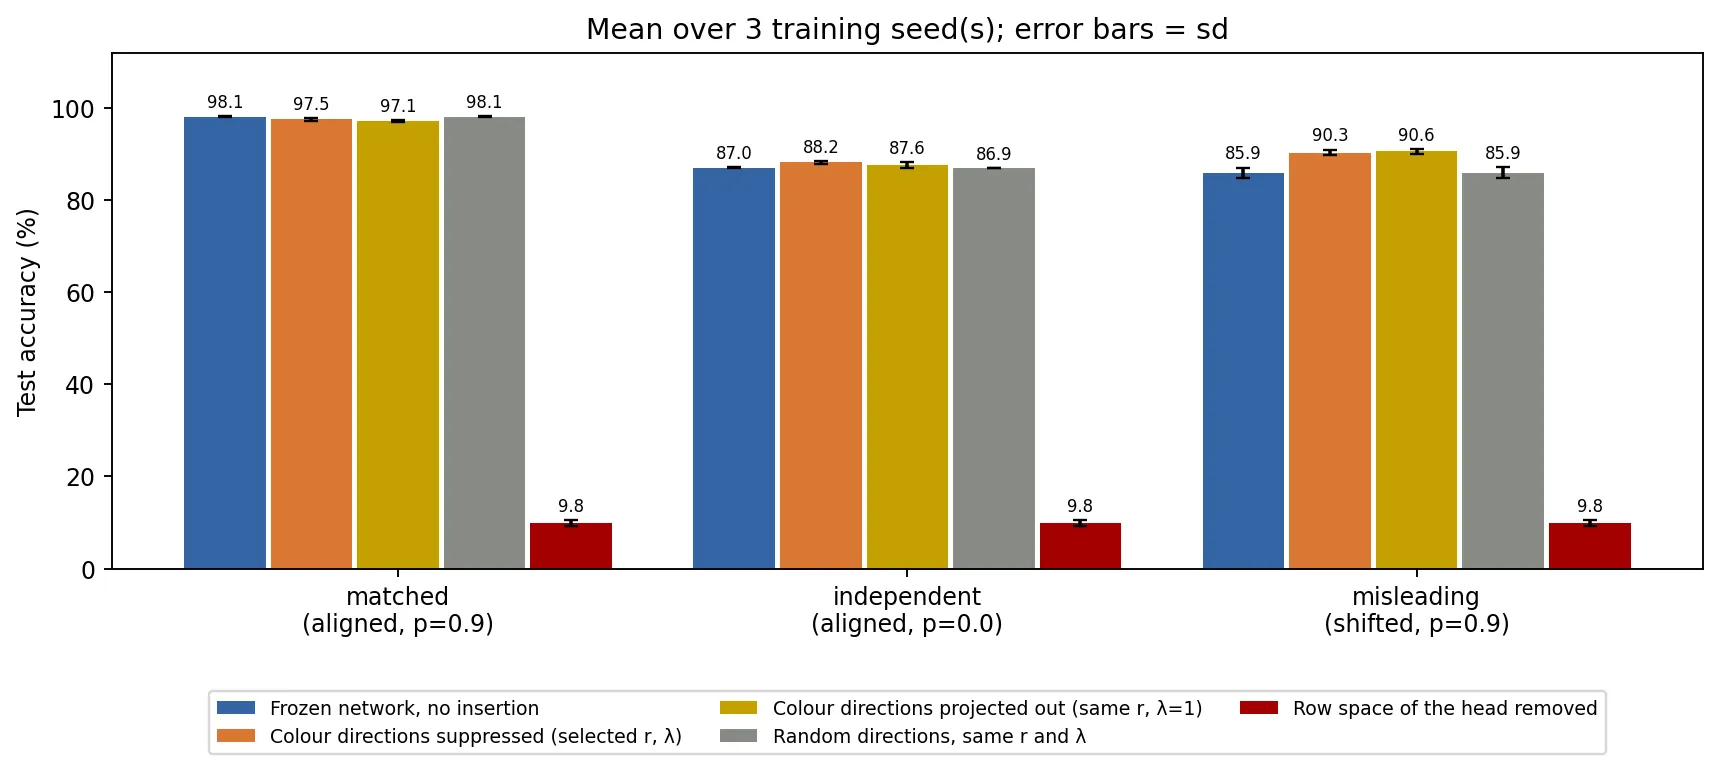
Смуги похибок показують стандартне відхилення для трьох тренувальних початкових значень. JSON містить результати для кожного початкового елемента та повну сітку перевірки.
Для насінини 42 вибране втручання є повною проекцією. Під оманливими кольорами він виправляє 619 неправильних передбачень і вводить 53 нових помилок. Під знайомими кольорами він виправляє 47 і вводить 124. Ці переходи роблять компроміс конкретним: перетворення змінює помилки, які допускає заморожений класифікатор.
Оцінка незалежного кольору не є виміряною оцінкою «лише за формою». Вхідні дані все ще кольорові, і мережа все ще може реагувати на цей колір. Він вимірює продуктивність, коли колір більше не передбачає мітку цифри.
Замініть компоненти значеннями іншого кольору
Придушення запитує, що відбувається, коли вибрані компоненти зменшуються або зникають. Заміна запитує, що відбувається, коли ми надаємо їм значення з іншого прямого проходу. Візьміть вихідне зображення, наприклад червону 9, і відобразіть той самий почерк білим. Пропустіть обидва зображення через засіб виділення заморожених функцій, щоб отримати і . З побудувати
Ми зберігаємо компонент джерела перпендикулярним до вибраного підпростору та замінюємо його дві вибрані координати на координати донора. Вихідне зображення та вивчені ваги залишаються незмінними. Донор має таку ж форму пальця; ми не копіюємо активації з іншої рукописної цифри. Його колір може бути таким, який зазвичай асоціюється з іншою цифрою під час навчання.
Для пакета, що зберігається як рядки, операція така:
# Same frozen extractor, same shapes, different colors.
donor_images = render(calibration_x[:16], np.full(16, 9))  # white donor
with torch.inference_mode():
    h = feature_extractor(source_images)
    h_donor = feature_extractor(donor_images)
    source_coordinates = h @ U
    donor_coordinates = h_donor @ U
    h_patch = h + (donor_coordinates - source_coordinates) @ U.T
    logits = classification_layer(h_patch)
Усі три насіння використовують два напрямки, уже вибрані в експерименті з придушення. Заміна повністю копіює координати донора; Налаштування придушення половинної сили насіння 43 не застосовується. Ми не обираємо новий ранг і не налаштовуємо кольори донорів за результатами тестування.
Це втручання надає інформацію з іншого прямого проходу. Для фіксованого донора це афінне перетворення вихідного вектора: проекція плюс зсув. Його результати лежать у трансльованій копії решти 126-вимірного підпростору, а не обов’язково підпростору через нуль. Це не та сама операція, що видалення інформації шляхом проектування на нуль.
Keep the source image fixed. Change only the hidden vector reaching the frozen output layer.
Stays fixed during the edit
Same shape, another forward pass
Copy only the donor’s two selected coordinates. Keep the source’s remaining 126 directions.
“Actual donor input” runs the recolored image through the whole network. It is a reference, not the result of the hidden edit.
Inspect the two selected coordinates
| Coord. | Source | Donor | Edited |
|---|---|---|---|
| c1 | -9.926 | -0.177 | -0.177 |
| c2 | 1.121 | 1.624 | 1.624 |
Coordinates in the selected SVD basis, not individual neuron values or RGB channels.
| Digit | Original | Hidden edit | Donor input |
|---|---|---|---|
| 0 | 0.01% | 0.01% | 0.00% |
| 1 | 4.00% | 2.29% | 0.00% |
| 2 | 0.07% | 0.08% | 0.00% |
| 3 | 1.84% | 0.65% | 0.00% |
| 4 | 50.92% | 24.44% | 0.00% |
| 5 | 2.01% | 7.03% | 0.00% |
| 6 | 0.06% | 0.04% | 0.00% |
| 7 | 0.59% | 0.15% | 0.00% |
| 8 | 3.11% | 2.44% | 0.00% |
| 9 (true) | 37.39% | 62.88% | 100.00% |
Recorded seed-42 outputs; first test image of each digit (this is #7). The basis and every learned weight stay fixed. Selecting the same source and donor color makes replacement a no-change check.
У початковому прикладі 42 вихідний червоний 9 прогнозується як 4, з 37,39% ймовірністю, призначеною 9. Копіювання вибраних координат із білого зображення змінює прогноз на 9 з 62,88% імовірністю. Якщо натомість вибрати пурпурний, прогноз залишиться на 4, а ймовірність 9 зменшиться до 17,31%. Селектор донора змінює лише те, які записані координати ми копіюємо; вихідне зображення залишається червоним.
Порівняйте патч із фактичним перефарбуванням
Посилання – це вихід мережі, коли вона фактично отримує зображення донора. Ми також тестуємо комплементний патч: зберігаємо дві вибрані координати джерела та копіюємо компонент донора в інших 126 напрямках,
Разом ці порівняння перевіряють, чи враховує обраний підпростір прогнозовані зміни, викликані перефарбуванням. Вони не припускають, що він містить всю інформацію про колір. Лінійна головка робить зміни logit двох патчів доповненими до повної зміни кольору; ймовірності та точність не мають такої адитивної властивості.
Для кожного з 10 000 тестових зображень у кожній умові вихідного кольору ми пробуємо всі десять донорських кольорів однаково, включаючи вихідний колір. Це дає 100 000 пар джерело/донор для кожної умови та насіння, але все одно лише 10 000 окремих вихідних зображень. Жодна цифрова мітка не використовується для вибору донорів для цих середніх значень. Результати нижче є середніми значеннями точності для тих самих трьох тренувальних початкових значень:
| Втручання | Знайомі вихідні кольори | Незалежні вихідні кольори | Оманливі вихідні кольори |
|---|---|---|---|
| Першоджерело | 98.09% | 87.05% | 85.91% |
| Видаліть два виділених напрямки | 97.14% | 87.60% | 90.57% |
| Замініть вибрані два напрямки | 95.74% | 85.01% | 88.33% |
| Замініть перпендикулярні 126 напрямки | 91.47% | 85.00% | 80.05% |
| Власне живіть донора зображенням | 87.08% | 87.08% | 87.08% |
| Замініть два випадкових напрямки | 98.05% | 87.06% | 86.09% |
Фактичний результат перефарбування є ідентичним у всіх стовпцях, оскільки зображення-донори вичерпують ту саму палітру для тих самих форм, незалежно від вихідного кольору. Випадкові елементи керування використовують три підпростору на зерно, однаковий ранг, повну заміну координат і точно тих самих донорів. Ряд видалення повторюється з попереднього експерименту для порівняння.
Заміна може допомогти або зашкодити, і її поведінка відрізняється як від придушення, так і від фактичного перефарбування. Зміни, отримані в результаті виправлення перпендикулярного компонента, показують, що кольорові ефекти, релевантні прогнозу, також існують поза вибраними двома напрямками. Сама по собі різниця в точності не визначає, яка частка інформації про колір міститься в будь-якій частині.
Як окрему діагностику з використанням відомих справжніх міток ми можемо вибрати колір донора, пов’язаний із справжньою цифрою, або колір, пов’язаний із наступною цифрою. Для оманливих вихідних зображень заміна вибраних компонентів дає точність 92,98% із справжнім кольором донора та 85,19% з кольором донора наступної цифри. Це контрольовані порівняння, а не методи для покращення прогнозів щодо невідомої цифри: для вибору цих донорів потрібна її мітка. Обидві умови були визначені перед вимірюванням результатів заміни.
Самовиправлення залишає логіти без змін. Числові перевірки також підтверджують, що вибрані координати донора копіюються, перпендикулярна складова джерела зберігається, а всі вивчені тензори залишаються незмінними. Заміна всього прихованого вектора відтворює фактичне вихідне зображення донора; це перевірка реалізації, а не додаткове відкриття.
Що це встановлює — і що залишається невизначеним
Вивчені тензори залишаються бітно-ідентичними протягом усього оцінювання. Вставлений шар є фактичним втручанням у прихований простір, і його числові перевірки узгоджуються з запланованими операціями матриці. Як додаткові елементи керування, збереження простору рядка останнього шару зберігає його прогнози, тоді як збереження його нульового простору робить оцінки рівними зміщенням, створюючи приблизно 10% точності.
Виміряне покращення придушення показує, що цей навчений класифікатор може приймати кращі рішення за оманливих кольорів після видалення вибраних напрямків. Це не означає, що придушення створює інформацію. Це змінює те, як фіксований класифікатор використовує інформацію, яку він уже має. Заміна відповідає на інше запитання: що відбувається, коли ми постачаємо вибрані компоненти від контрольованого донора? Він вимагає додаткового проходу вперед і не потребує відтворення ефекту зміни всього вхідного сигналу.
Ми також не стерли весь вплив кольору. Точність знайомих кольорів залишається значно вищою, ніж точність незалежних кольорів після проектування. Вибрані напрямки можуть змішувати відповіді на колір і форму, і немає гарантії, що така ж оцінка, ранг або сила підійдуть для іншої моделі. Ці результати охоплюють одну архітектуру, один калібрувальний розмір і три початкових числа для навчання.
Практичне заняття умовне: напрямок, який допомагає прогнозуванню під навчальним розподілом, може зашкодити, коли змінюється його асоціація з міткою. Його придушення може покращити заморожену модель за змінених умов, водночас погіршуючи її за початкових умов.
Відтворіть експеримент
Завантажте самодостатній сценарій експерименту, офлайн тести, висунуті вимоги і зафіксовані результати. Розмістіть сценарій, тести та вимоги в одному каталозі:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python -m unittest discover -s . -p 'test_colored_mnist_intervention.py' -v
python colored_mnist_intervention.py --quick
python colored_mnist_intervention.py
Вимоги спрямовані на CPU PyTorch у Linux. Перший запуск завантажує MNIST у ~/.cache/mirror-span/. Сценарій тренується з Адамом зі швидкістю навчання 0,002, розміром партії 512, протягом восьми епох на зерно, з двома потоками ЦП. Записаний повний запуск, включаючи заміну та його керування, зайняв приблизно 51 секунду. Він записує результати, чотири цифри, початкові контрольні точки 42 і приклади даних у out-colored/. Записи replacement у JSON для кожного початкового числа містять результати діагностики на основі всіх палітр і міток, випадкові та додаткові елементи керування та числові перевірки. Використовуйте --quick для перевірки диму з окремим виходом у out-colored-quick/.
Чотири офлайн-тести пройшли успішно: вони перевіряють збереження просторового малюнка під час перефарбовування, придушення вздовж поворотного напрямку, заміну координати донора та навчання з подальшим втручанням із замороженими вагами. Випробування димом і всі три повні тренувальні запуски також витримали свої чисельні твердження. Придушення нульової сили та самовиправлення точно зберігають логіти; елементи керування float32 space-space і bias-only пройшли з абсолютним допуском , а ідентифікатори заміни пройшли нижче . Наведені вище фрагменти Python були виконані в порядку, включаючи навчання та калібрування початкового рівня 42.
Результати JSON записує мітку часу виконання, версії Python і бібліотеки, кількість потоків процесора, розділення даних, початкові значення та числові перевірки. Інтерактивні приклади використовують записані прогнози початкового значення 42 для першого тестового входження кожної цифри. Вибір цифри, стану кольору, кольору донора або втручання не перенавчає та не запускає модель у браузері. Візуалізація пікселів і відображені прогнози надходять із того самого експорту експерименту; replacement-samples.json також записує вибрані координати та всі десять логітів і ймовірностей для кожного порівняння.