Навчаємо невелику LLM повертати JSON за допомогою LoRA
Модель може повернути абсолютно дійсний JSON і все одно дати вам неправильну відповідь. Він може правильно скопіювати номер замовлення, залишити назву продукту пустою та вказати кількість у рядку. Перевірка того, чи відповідь починається з відкриваючої дужки, мало що говорить нам про те, чи може програма її використовувати.
Давайте навчимо невелику мовну модель перетворювати запити клієнтів на фіксований об’єкт JSON. Ми виміряємо, що покращилося після навчання, перевіримо помилки та проведемо той самий експеримент на двох графічних процесорах: Quadro RTX 5000 із 16 ГБ пам’яті та RTX PRO 6000 Blackwell. Ми також підготуємо версію Tinker для вивчення навчання через API.
Є три окремі точки входу: локальний графічний процесор, блокнот marimo для графічного процесора molab і сервісний запускач Tinker. Вони спільно використовують набір даних, конфігурацію та правила оцінки. Два шляхи GPU використовують попередньо навчену модель із приблизно півмільярда параметрів. Ми можемо зрозуміти кожен цільовий запис і перевірити кожне передбачення, не просячи іншу модель оцінити його.
Потім ми проводимо окремий експеримент із форматуванням із моделлю із 135 мільйонів параметрів. Qwen уже повертає дійсний JSON, але потрібно покращити його значення; менша модель спочатку відповідає прозою або Markdown. Це дозволяє нам вивчати дві різні зміни, не змінюючи моделі під час порівняння GPU.
Щоб дізнатися про рангові ідеї та побудову адаптера, що лежить в основі цього експерименту, почніть із основ тонкого налаштування LoRA. Він будує метод із малих матриць і прикладу процесора перед тим, як застосувати його до цих проекцій трансформатора.
Завдання з відповідями, які ми можемо перевірити
Припустимо, клієнт пише:
Будь ласка, скасуйте 3 клавіатури із замовлення 4821.
Ми хочемо саме цей об’єкт:
{
  "action": "cancel",
  "order_id": 4821,
  "product": "keyboard",
  "quantity": 3
}
Є три можливі дії: cancel, return і track. Назва продукту має бути в однині. Ідентифікатор замовлення та кількість є цілими числами, за винятком того, що ідентифікатор замовлення, відсутній, стає null. Повинні з’явитися всі чотири клавіші, а додаткові ключі - це помилки.
Ці правила розділяють три питання. JSON validity запитує, чи може аналізатор JSON прочитати всю відповідь. Відповідність схеми запитує, чи має вона необхідні ключі та типи. Точність запису запитує, чи всі чотири значення відповідають відповіді. Відповідь може пройти перші два і не пройти третій.
Ми порівнюємо аналізовані об’єкти, тому відступи та порядок ключів не впливають на точність. Ми не видаляємо паркани Markdown, не витягуємо перспективний підрядок і не відновлюємо відсутню дужку. Ці операції вимірювали б комбінацію моделі та нашого ремонтного коду. Повторювані ключі та константи, такі як NaN, також відхиляються.
Створіть набір даних
Ми використовуємо синтетичний набір даних, створений experiment/data.py: 2000 навчальних прикладів, 200 перевірочних прикладів і 300 тестових прикладів. Кожен запис починається з дії, продукту, кількості та додаткового ідентифікатора замовлення. Потім Python вставляє ці значення в шаблон речення та зберігає відповідну ціль JSON. Ми знаємо правильні відповіді, тому що створили речення з цих значень.
Наприклад, той самий основний запис може виглядати як «Я хочу повернути 2 миші за замовленням 6193» або «Замовлення 6193: будь ласка, поверніть мої 2 миші». Його цільовий продукт – mouse. Деякі продукти містять кілька слів, символів із діакритичними знаками або слів у лапках, як-от USB cable, café mug і "Pro" keyboard. Приблизно одна п’ята прикладів не вказує ідентифікатор замовлення.
Генератор використовує різні шаблони речень для навчання, перевірки та тестування. Він також резервує різні діапазони ідентифікаторів замовлення для кожного поділу. Це перешкоджає тому, щоб тестовий набір був набором майже ідентичних навчальних речень із новим випадковим початковим числом.
Продукти та схема залишаються спільними. Хороший результат означає, що модель справляється з новими формулюваннями для цього синтетичного завдання. Це не означає, що він може розуміти довільні повідомлення клієнтів, незнайомі продукти або нові схеми. Для цього знадобляться додаткові набори тестів.
Набір перевірки дає нам зворотний зв’язок під час навчання. Тестовий набір забезпечує остаточне порівняння; ми не повинні неодноразово змінювати інструкції чи варіанти навчання, щоб покращити його оцінку.
Модель, яку ми адаптуємо
Ми починаємо з Qwen2.5-0.5B-Instruct. Це вже навчений помічник, і його картка моделі конкретно згадує структуровані виходи. Ми адаптуємо його до наших правил вилучення. Вимірювання його початкової поведінки спочатку говорить нам, чи допомагає додаткове навчання.
Це причинний трансформатор лише для декодера з приблизно 0,49 мільярда параметрів. Токенізатор перетворює чат на ідентифікатори маркерів, а таблиця вбудовування відображає кожен ідентифікатор на вектор із 896 чисел. Ці вектори проходять через 24 трансформаторні блоки, після чого відбувається остаточна нормалізація та заголовок мовної моделі, який виробляє логіти наступного маркера.
Конфігурація нашої закріпленої контрольної точки дає такі розміри:
| компонент | Qwen2.5-0.5B-Instruct |
|---|---|
| Трансформаторні блоки | 24 |
| Ширина прихованого вектора | 896 |
| Увага, голови на блок | 14 заголовків запитів; 2 ключові головки та 2 головки значення |
| Ширина кожної голови уваги | 64 |
| Проміжна ширина подачі вперед | 4,864 |
| Словник/логіти виводу на позицію | 151,936 |
| Підтримуваний контекст / наша доповнена тривалість навчання | 32 768 / 256 жетонів |
Кожен блок має два підрівні: причинна самоувага, яка поєднує інформацію з поточних і попередніх токенів, і мережа прямого зв’язку SwiGLU, яка перетворює вектор кожної позиції. RMSNorm змінює масштаб векторів перед кожним підрівнем, а залишкове з’єднання додає вхідні дані підрівня назад до його виходу. Мережа прямого зв’язку використовує дві проекції від 896 до 4864 значень, поєднує їх через ворота SiLU, а потім проектує назад до 896.
Attention використовує увагу згрупованого запиту: кожна група із семи заголовків запиту спільно використовує одну головку ключа та одну головку значення. Вбудовування поворотних позицій, або RoPE, кодує позиції маркерів у запитах і ключах. Це пояснює, чому наша проекція запиту виводить 896 значень, тоді як проекція значень виводить лише 128.
Після останнього блоку остаточний RMSNorm і головка мовної моделі перетворюють кожен прихований вектор із 896 значень у 151 936 балів словника. Голова ділиться своєю матрицею ваг із таблицею введення вхідних даних. Ці логіти підтримують втрати під час навчання та вибору маркерів під час генерації. Наші адаптери LoRA входять до підрівнів уваги всіх 24 блоків; вбудовування, ваги прямої подачі, ваги нормалізації та вихідний напор залишаються замороженими.
Що змінює LoRA
LoRA означає адаптацію низького рангу. Ми зберігаємо попередньо підготовлені ваги та вивчаємо невелику корекцію поряд із вибраними лінійними проекціями. Той самий прихований вектор проходить через вихідну проекцію та нову гілку з двома навчальними матрицями, та . Додаємо їхні результати:
Тут — прихований вектор, і — заморожені ваги та зміщення запиту, а — результатний вектор запиту. Наш ранг — , а альфа — , тому вихід адаптера множиться на 2. Ранг 8 — це ширина проміжного вектора в гілці адаптера.
Для проекції запиту Qwen має форму , а має форму . Разом вони додають 14 336 ваг, які можна тренувати, поряд із початковими 802 816 вагами матриці. Ми застосовуємо цю ідею до q_proj і v_proj у всіх 24 трансформаторних блоках, даючи загалом 540 672 параметри, які можна навчити. AdamW оновлює лише ці параметри адаптера; оригінальні ваги та зміщення моделі залишаються замороженими.
Адаптери змінюють обчислення всередині трансформаторних блоків. Є 48 адаптованих проекцій: один запит і одна проекція значення на блок. Це налаштування PyTorch/PEFT відповідає experiment/engine.py; load_model() завантажує нашу закріплену контрольну точку Qwen. Використовуйте у заголовку коду, щоб прочитати його на весь екран, а потім натисніть Escape або , щоб повернутися.
import torch
from peft import LoraConfig, get_peft_model
from transformers import set_seed
from engine import load_model  # Run from the experiment directory.

set_seed(42)
model, tokenizer = load_model()
model = get_peft_model(model, LoraConfig(
    task_type="CAUSAL_LM",
    r=8,
    lora_alpha=16,
    lora_dropout=0.0,
    target_modules=["q_proj", "v_proj"],
    bias="none",
))

# Only the adapter matrices require gradients.
parameters = [p for p in model.parameters() if p.requires_grad]
for parameter in parameters:
    parameter.data = parameter.data.float()  # FP32 adapters; FP16 base.
optimizer = torch.optim.AdamW(parameters, lr=2e-4, weight_decay=0.01)

# Inspect a projection inside the first of the 24 transformer blocks.
blocks = model.get_base_model().model.layers
query = blocks[0].self_attn.q_proj
print(len(blocks))                                  # 24
print(query.base_layer.weight.requires_grad)        # False
print(query.lora_A["default"].weight.requires_grad)  # True
print(query.lora_B["default"].weight.requires_grad)  # True
print(query.lora_A["default"].weight.shape)          # [8, 896]
print(query.lora_B["default"].weight.shape)          # [896, 8]
print(sum(p.numel() for p in parameters))            # 540672
PEFT ініціалізує до нуля, тому нова гілка спочатку вносить нуль і зберігає поведінку вихідної моделі. Потім навчання вивчає виправлення з наших прикладів JSON. Заморожування бази зберігає пам’ять градієнта та стану оптимізатора для її ваг, тоді як прямі обчислення та зворотне поширення, необхідні для навчання адаптерів, усе ще виконуються через мережу.
Як ми обчислюємо втрати
Це контрольована точна настройка: кожен навчальний приклад містить системну інструкцію, повідомлення клієнта та правильну відповідь асистента. У кожній позиції відповіді модель бачить підказку та правильні попередні маркери відповіді, а потім передбачає наступний маркер. Це називається примусом вчителя. Це дозволяє нам тренуватися на всіх позиціях відповіді за один прохід вперед замість того, щоб генерувати повну відповідь по одному жетону за раз.
Перехресна ентропія карає модель, коли правильний наступний маркер отримує низьку ймовірність. Ми усереднюємо цей штраф за маркерами відповідей:
Тут — підказка, — маркер правильної відповіді на позиції , а підраховує маркери відповідей у ефективній групі. Модель передбачає лексеми, якими можуть бути слова, фрагменти слів, знаки пунктуації або частини чисел. Призначення ймовірності 0,9 правильному маркеру дає втрату приблизно 0,105; присвоєння ймовірності 0,1 дає приблизно 2,303. Зворотне поширення змінює ваги адаптера, щоб зробити правильні маркери більш імовірними.
У кожній позиції модель виводить логіти: один ненормализований бал для кожного токена в її словнику. Якщо ці оцінки , softmax визначає прогнозовані ймовірності, а втрата маркера становить:
Ми передаємо логіти та правильні ідентифікатори токенів до вбудованої втрати моделі. Внутрішньо він використовує перехресну ентропію, еквівалентну log-softmax, за яким слідує негативна log-правдоподібність. Ми самі не застосовуємо softmax до цього виклику. Токенізатор надає цільові ідентифікатори з правильного JSON; ми не порівнюємо логіти іншої моделі.
У цій функції втрати немає аналізатора JSON і окремої винагороди за створення дійсного об’єкта. Менші втрати означають, що цільові відповіді стають більш імовірними. Чи може модель самостійно створити повну, правильну відповідь, потребує окремої перевірки генерації.
Ми обчислюємо втрати лише на відповіді асистента, включаючи його кінцевий маркер. Системна інструкція, повідомлення клієнта та заповнення отримують ігноровану мітку -100. Підказка все ще надає контекст; це просто не текст, який ми просимо модель відтворити як відповідь.
Тренувальна маска виглядає так:
input_ids = prompt_tokens + response_tokens + padding_tokens
labels = (
    [-100] * len(prompt_tokens)
    + response_tokens
    + [-100] * len(padding_tokens)
)
Реалізація моделі причинної мови зміщує ці мітки всередині: попередня позиція передбачає наступний токен відповіді. Перевірка того, що межа має значення. Маска «від одного» може мовчки пропустити перший маркер відповіді з навчання.
Це розбіжність KL?
У нашій реалізації використовується перехресна ентропія без окремого штрафу KL щодо вихідної моделі. Існує математичний зв’язок: якщо є одноразовим розподілом, який призначає вірогідність 1 правильному наступному маркеру, то
Ентропія цілі дорівнює нулю, тому перехресна ентропія та цей напрям розбіжності KL мають однакове значення. Це порівнює відомий цільовий розподіл із прогнозованими ймовірностями моделі, а не з двома необробленими логіт-векторами. Модель вчителя чи розповсюдження еталонної моделі не використовуються.
Дивіться згенеровані відповіді під час навчання
Локальний бігун може генерувати одну відповідь після кожного оновлення оптимізатора за допомогою --preview-every 1 або кожні десять оновлень за допомогою --preview-every 10. Попередній перегляд за умовчанням вимкнено для порівняння апаратного забезпечення Qwen. Окремий бігун SmolLM2 вмикає їх кожні десять оновлень. Блокнот molab завжди вимикає попередній перегляд.
Для кожного попереднього перегляду використовується один запит перевірки та надається лише інструкція та повідомлення клієнта для моделі. Модель генерує власну відповідь, не бачачи очікуваного JSON. Ми чергуємо приклади перевірки; ці зразки є діагностичними, а не заміною для оцінки повного набору тестів.
Кожен збережений попередній перегляд записує повідомлення клієнта, очікуваний JSON, необроблену згенеровану відповідь, поточне оновлення, епоху та втрату навчання. Він перевіряє дійсність JSON, відповідність схеми та чи збігаються всі значення. Перевірки відрізняють недійсний JSON від дійсних об’єктів із неправильними полями чи значеннями. Це важливо, тому що наша записана базова лінія вже створила дійсний JSON для кожного тестового прикладу, а всі значення були правильні лише для 5,33% із них.
Відображені втрати походять від щойно обробленої навчальної партії. Згенерована відповідь походить із прикладу перевірки після цього оновлення, тому обидва описують різні перевірки. Одне оновлення оптимізатора зазвичай поєднує вісім мікропакетів із чотирьох навчальних прикладів. Попередній перегляд додає один виклик генерації після цих 32 прикладів.
Створення, оцінка, збереження та відображення попереднього перегляду потребують додаткового часу. Ми записуємо цей час окремо від навчального циклу та негайно зберігаємо кожен зразок у previews.jsonl; завершені прогони також включають їх у training.json. Ми перевіряємо збережені зразки на місці. Вимкніть попередній перегляд для порівняння продуктивності: навіть з окремими таймерами генерація може вплинути на пам’ять GPU та синхронізацію.
Зберігайте першу конфігурацію маленькою
Повний експеримент використовує такі налаштування:
| Налаштування | Значення |
|---|---|
| Модель | Qwen2.5-0.5B-Instruct, закріплена версія |
| Приклади навчання / перевірки / тестування | 2,000 / 200 / 300 |
| Епохи | 2 |
| Рейтинг LoRA / альфа | 8 / 16 |
| Цілі LoRA | Проекції запитів і цінностей |
| Швидкість навчання | 0.0002 |
| Оптимізатор | АдамВ |
| Мікросерія | 4 |
| Градієнтне накопичення | 8 |
| Ефективна партія | 32 |
| Доповнена довжина послідовності | 256 жетонів |
| Точність | FP16 змішаної точності, ваги адаптера FP32 |
Мікросерія — це група, оброблена одним проходом вперед і назад. Накопичення градієнта дає нам змогу обробити вісім груп із чотирьох, перш ніж зробити одне оновлення оптимізатора. Це дає нам ефективну партію з 32 без утримання всіх 32 активацій прикладів у пам’яті одночасно. Кінцева група епохи може бути меншою.
Тривалість відповіді різна. Ми нормалізуємо внесок кожної мікропартії за її часткою токенів відповідей у всьому вікні накопичення. Це означає, що накопичений градієнт відповідає середньому збитку за цими токенами, а не середньому значенню груп різного розміру.
Ми використовуємо однакову конфігурацію FP16 на обох графічних процесорах для основного порівняння. Масштабування градієнта допомагає зберегти невеликі градієнти, тоді як вага адаптора, який можна навчити, залишається в FP32. Пропущені оновлення оптимізатора записуються, тому чисельні помилки не можуть виглядати як успішне швидке навчання.
Три окремі робочі процеси
Файли знаходяться в blog/src/content/drafts/teaching-a-small-llm-to-output-json-with-lora/experiment/.
| робочий процес | Точка входу | Де проходить навчання |
|---|---|---|
| Локальний графічний процесор | run_local.py | Локальний графічний процесор NVIDIA |
| Молабський зошит | molab_notebook.py | Графічний процесор, підключений до molab |
| Тінкер | run_tinker.py | Сервіс керованого навчання Tinker |
Обидва шляхи GPU використовують Python 3.12.13 і ті самі pyproject.toml і uv.lock, включаючи PyTorch 2.7.1 із CUDA 12.8. PyTorch представив офіційну підтримку Blackwell у своєму випуску 2.7. Програма запуску перевіряє фактичні версії перед завантаженням моделі та записує хеш блокування в кожному маніфесті. Драйвери GPU залишаються специфічними для кожного хоста.
Запуск на локальному GPU
З каталогу експериментів:
uv sync --locked
uv run run_local.py train --smoke --label local-smoke
uv run run_local.py train --label quadro-rtx5000
Почніть з команди --smoke. Він використовує 100 навчальних прикладів, 20 перевірочних прикладів, 24 тестових приклади та одну епоху. Він перевіряє повний шлях через токенізацію, CUDA, градієнти, збереження адаптера та генерування відповідей. Його бали є перевіркою налаштування, а не заміною повного експерименту. Команда без цього прапорця запускає повний експеримент.
Кожен запуск зберігає точний набір даних, версію моделі, версії пакетів, конфігурацію та необроблені прогнози. Локальні прогони також зберігають вагу адаптера. Унікальні вихідні каталоги не дозволяють пізнішому запуску замінити попередні вимірювання.
Запуск на molab
Для molab використовуйте experiment/molab_notebook.py. Це мінімальний однофайловий раннер із п’ятьма допоміжними модулями та спільним блокуванням середовища, що входить у комплект. Він надає інформацію про графічний процесор, параметри запуску, прогрес навчання та завантаження результатів. Аналіз залишається на локальній машині. Вам не потрібно імпортувати файл Jupyter .ipynb або завантажувати допоміжні файли окремо.
Використовуйте версію з позначкою MOLAB GPU NOTEBOOK V7. Інтерфейс блокнота може працювати на Python 3.13 від molab, тоді як навчання виконується в окремому процесі Python 3.12.13. Цей процес використовує заблоковане середовище проекту uv із тим самим блокуванням залежностей, що й локальний бігун; він не використовує попередньо встановлений PyTorch ядра ноутбука. Його перший запуск може завантажити інтерпретатор і пакети. Це необхідно, оскільки наш перший запуск smoke molab використовував різні версії пакетів, незважаючи на вбудовані метадані. Якщо менеджер пакетів пропонує встановити data, engine або runtime, імпортуйте V7 у новий блокнот; це згруповані допоміжні імена.
Імпортуйте цей блокнот Python у molab, а потім увімкніть графічний процесор за допомогою елемента керування специфікаціями блокнота в заголовку. Molab пропонує RTX PRO 6000 Blackwell GPU. Перевірте інформацію про апаратне забезпечення ноутбука перед навчанням: воно має відображати підключений GPU та PyTorch із підтримкою CUDA.
Виберіть і натисніть велику кнопку у блокноті. Кнопка відтворення на панелі інструментів виконує комірки налаштування; навчання чекає цієї кнопки. Після успішного запуску диму виберіть і клацніть його ще раз. Навчальні комірки використовують явні елементи керування виконанням marimo.
Попередній перегляд генерації в реальному часі вимкнено в блокноті molab. Він показує статус навчання та зберігає втрати та прогнози для локального аналізу.
Ноутбук працює на підключеному графічному процесорі та зберігає базову оцінку, історію навчання LoRA, адаптовану оцінку та ваги адаптера. Він не містить еталонних прогонів, діаграм, селекторів збережених прогонів, контрольних розгорток або елементів керування Tinker. Ми порівнюємо завантажений прогін Blackwell зі збереженим прогоном Quadro локально.
Після завершення навчання автоматично з’являється кнопка . Завантажте цей запуск перед завершенням сеансу, а потім перенесіть сюди ZIP для аналізу. Він містить прогнози, статистику навчання, конфігурацію, набори даних і ваги адаптера під artifacts/RUN/. Завантажте smoke і full run окремо, якщо хочете обидва. Molab розглядає звичайні файли, згенеровані програмою, як тимчасове сховище, тому лише збереження блокнота не зберігає всі артефакти експерименту.
Вимірювання на Quadro RTX 5000
Перший повний запуск використовував наведену вище конфігурацію та оцінював кожен відкладений запит без ремонту відповідей:
| On 300 held-out requests | Original model | After LoRA training |
|---|---|---|
| Valid JSON | 100.0% | 100.0% |
| Correct schema | 75.0% | 100.0% |
| All values correct | 5.3% | 98.3% |
The Quadro RTX 5000 completed 126 optimizer updates in 8.89 minutes of training time, processing 997 non-padding input tokens per second. Peak allocated GPU memory was 3.82 GiB. There were 0 skipped updates.
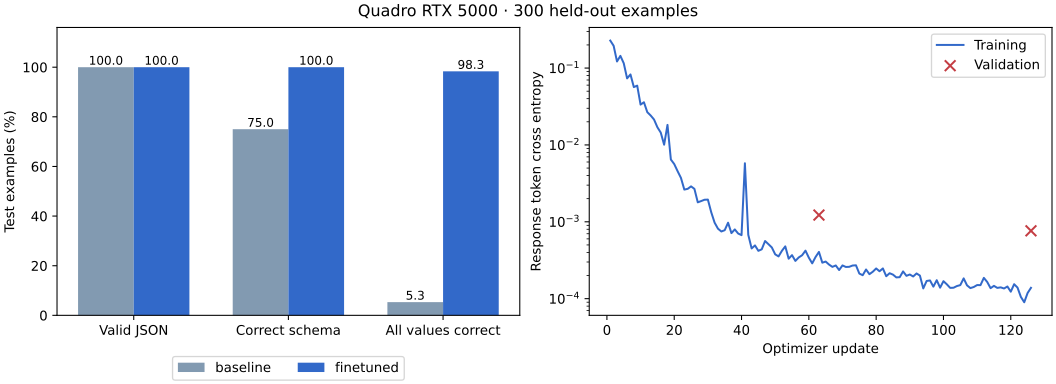
Here is one request the original model failed:
My request for order 28956 is to return 8 keyboards, please.
{"action": "return", "order_id": 28956, "product": "", "quantity": 8}{"action": "return", "order_id": 28956, "product": "keyboard", "quantity": 8}Необроблені результати, прогнози, конфігурація та історія втрат зберігаються в results/quadro-rtx5000.json поруч із цією статтею. Фігура генерується з вихідного циклу цього файлу. Це спостереження з одного насіння над цим синтетичним завданням; високий бал тут не встановлює надійність довільних запитів.
Усі п’ять помилок, що залишилися, походять від одного шаблону формулювання: «Є… за порядком…; чи може хтось… їх?» Чотири мають кількість 1, де шаблон створює незграбну згоду, наприклад «Є 1 миша». Інша помилка змінює ідентифікатор замовлення та кількість. Це дає нам конкретні подальші дії: виправте угоду генератора та додайте окремо написаний тестовий набір. Ми зберігаємо цей перший запуск і його набір даних замороженими, щоб порівняння обладнання використовувало те саме навантаження.
Перший димовий запуск на Blackwell
Перший повернутий тест Molab завершено на NVIDIA RTX PRO 6000 Blackwell Server Edition. Він використовував конфігурацію smoke: 100 навчальних прикладів, 20 перевірочних прикладів, 24 тестових приклади та одну епоху. Це дало нам чотири оновлення оптимізатора, жодне з яких не було пропущено. Необроблені результати зберігаються в results/blackwell-smoke.json.
| Перевірте 24 тестові запити | Перед тренуванням | Після навчання |
|---|---|---|
| Дійсний JSON | 24/24 (100%) | 24/24 (100%) |
| Правильна схема | 17/24 (70.83%) | 23/24 (95.83%) |
| Усі чотири значення правильні | 0/24 (0%) | 5/24 (20.83%) |
Вилучення продуктів покращилося з 0 до 9 правильних значень із 24, а вилучення кількості покращилося з 16 до 21. Відсутні ідентифікатори замовлення залишалися проблемою: після навчання модель винайшла ідентифікатор для семи з восьми запитів без жодного. Це спостереження лише після чотирьох оновлень; повний експеримент є наступним вимірюванням.
Навчальний цикл зайняв 1,51 секунди, тоді як чотири попередні перегляди в прямому ефірі додали 1,49 секунди. Це виключає завантаження моделі, базову лінію та остаточну оцінку генерації, а також перевірку. Максимальний обсяг виділеної пам’яті графічного процесора становив 3,82 ГіБ, включаючи перевірку та попередній перегляд. Втрата тренування зросла з 0,244 під час першого оновлення до 0,167 під час останнього оновлення зі збільшенням під час оновлення 3. Останній попередній перегляд все ще повертав порожній продукт і нульову кількість для запиту на скасування восьми мишей, незважаючи на створення дійсного JSON із правильними типами.
Цей димовий запуск не може забезпечити контрольоване прискорення порівняно з попереднім повним запуском Quadro. Окрім різного робочого навантаження та ввімкнених попередніх переглядів, збережений маніфест записує PyTorch 2.11.0 із CUDA 13.0 на molab, тоді як Quadro використовував PyTorch 2.7.1 із CUDA 12.8. Фактичне записане середовище відрізняється від метаданих залежностей блокнота. Нам потрібні повні прогони з відповідними робочими навантаженнями та узгодженими версіями програмного забезпечення, перш ніж інтерпретувати співвідношення часу.
Починаючи з V6, раннер вирішує це, запускаючи навчання зі спільним блокуванням і перевіряючи робочий Python, версії пакетів і збірку CUDA. V7 зберігає це середовище та завжди вимикає попередній перегляд. Початковий результат диму залишається незмінним. Відбитки коду нормалізують відносний імпорт, який використовується пакетними помічниками, тому одне пакування не створює помилкової різниці.
Свіжий аналог Quadro завершив 126 оновлень за 255,01 секунду, з вимкненим попереднім переглядом і жодним пропущеним оновленням. Він знову досяг 295/300 точних збігів, а його історія втрат під час навчання та перевірки була ідентичною першому запуску Quadro. Його набір даних, код і відбитки середовища зберігаються в results/quadro-aligned.json. Це локальне посилання для порівняння V6 Blackwell нижче. Хронометраж попереднього циклу 533,10 секунд залишається збереженим; ці два спостереження на одному графічному процесорі також показують, чому коефіцієнти синхронізації потребують нових прогонів і повторних вимірювань, а не припущення, що одна записана тривалість є фіксованою.
Повний запуск Qwen на Blackwell
Повернений запуск V6 використовував повний набір даних і пройшов перевірки вирівнювання: Python 3.12.13, PyTorch 2.7.1 із CUDA 12.8, версії пакетів, версія моделі, набір даних, хеш коду, блокування середовища, точність і пакетна конфігурація відповідають новому запуску Quadro. Збережені результати знаходяться в results/blackwell-full.json.
| Записане вимірювання | Quadro RTX 5000 | RTX PRO 6000 Blackwell |
|---|---|---|
| Оновлення оптимізатора | 126 | 126 |
| Навчальна петля | 255.01 s | 51.24 s |
| Попередній перегляд у реальному часі | 0 s | 41.72 s |
| Вхідні маркери без заповнення за секунду | 2,085 | 10,375 |
| Максимальна кількість виділеної пам’яті GPU | 3,82 ГіБ | 3,82 ГіБ |
| Точні матчі після тренування | 295/300 | 295/300 |
Обидва прогони створили дійсний JSON і правильні схеми для всіх 300 тестових запитів після навчання. Усі 300 остаточних необроблених відповідей були ідентичними між GPU, включаючи ті самі п’ять помилок. Їхні втрати при навчанні дещо відрізняються, як це може статися з різними ядрами GPU та арифметикою FP16, тоді як згенеровані тестові відповіді збігаються.
Одне налаштування моніторингу відрізняється: Blackwell run створював попередній перегляд після кожного оновлення, тоді як Quadro попередній перегляд був вимкнений. Коефіцієнт часу записаного тренувального циклу становить 4,98×, за винятком попередніх переглядів. Це спостережуване співвідношення компонентів, а не повністю відповідний еталон GPU; генерація між оновленнями може вплинути на стан графічного процесора та планування, навіть якщо хронометрується окремо. Тільки попередні перегляди Blackwell додали 41,72 секунди до 51,24-секундного тренувального циклу. Для повторного запуску синхронізації імпортуйте V7, виберіть і натисніть . V7 завжди вимикає попередній перегляд.
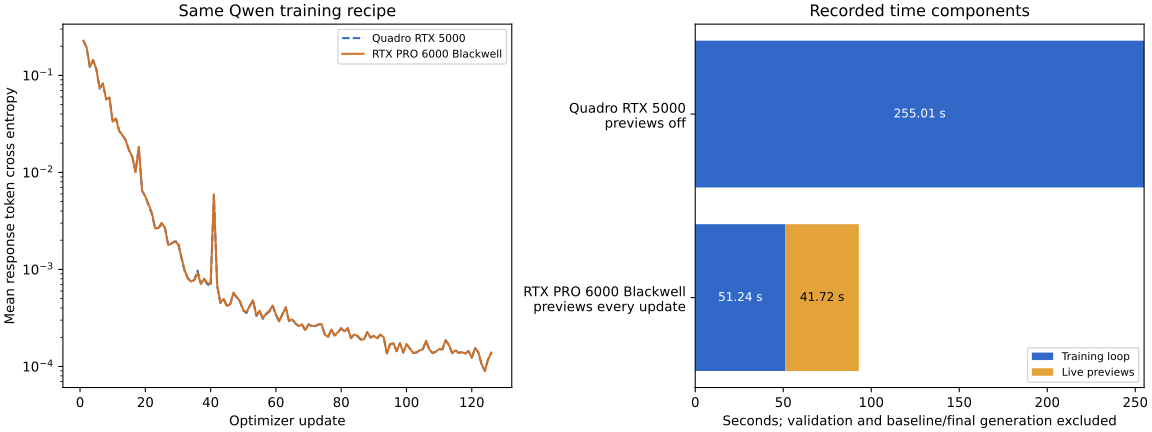
Автентифіковане навчання Tinker очікує на розгляд і буде повідомлено як окремий робочий процес служби.
Порівняйте два GPU
Спочатку запустіть ідентичний повний експеримент на кожній машині. Зберігайте фіксованими модель, набір даних, довжину послідовності, точність, мікропакет, накопичення градієнта та версії програмного забезпечення. Витягніть завантажений цикл molab поруч із локальним циклом і порівняйте ці параметри та відбитки пальців у їхніх файлах manifest.json перед тим, як інтерпретувати співвідношення часу. Локальний помічник reporting.py позначає відмінності під час порівняння циклів.
Час навчання охоплює весь цикл навчання, включаючи пересадки, проходи вперед і назад, а також оновлення оптимізатора. Завантаження, завантаження моделі, оцінка генерації, перевірка та попередній перегляд поза цим таймером. Накладні витрати на попередній перегляд записуються окремо. Оновлення початкового навчання включено. Повідомляйте про максимальну виділену пам’ять GPU та маркери введення без заповнення за секунду разом із часом, що минув. Пікова пам’ять включає перевірку та попередній перегляд, якщо ввімкнено, тому вимкніть попередній перегляд на обох хостах для контрольованого порівняння.
Вхідні маркери містять як підказки, так і відповіді, оскільки обидва вимагають обчислення. Лише маркери відповіді безпосередньо сприяють втраті. Послідовності доповнюються до 256 токенів на обох GPU; заповнення не збільшує чисельник пропускної здатності.
Потім запустіть окрему перевірку розміру партії:
# On the Quadro machine
uv run --locked run_local.py sweep --microbatches 4 8 16 --output artifacts/sweep-quadro.json

# On the Blackwell machine
uv run --locked run_local.py sweep --microbatches 4 8 16 32 --output artifacts/sweep-blackwell.json
Порівняйте мікропартії 4, 8 і 16 на обох машинах, а також спробуйте 32 на Blackwell, регулюючи накопичення, щоб зберегти 32 приклади на оновлення. Кожна спроба відновлює ту саму ініціалізацію адаптера та скидає оптимізатор. Він виконує три оновлення прогріву, помножує на десять оновлень і повторює вимірювання тричі. Ми будуємо графік середньої пропускної здатності щодо розміру мікропартії. Результат нестачі пам’яті завершує розгортку.
У molab імпортуйте окремий блокнот experiment/molab_sweep.py, увімкніть графічний процесор, натисніть і збережіть , коли завершиться. Він запускає мікропартії 4, 8, 16 і 32, використовуючи реалізацію загального заблокованого тесту. Навчальний блокнот залишається незмінним, а весь аналіз локальним. Запускайте лише один експеримент GPU за раз.
Збільшення мікропартії зазвичай збільшує пам’ять активації: разом обробляється більше прикладів, а вага моделі залишається незмінним. З ефективною партією 32 мікропартія 4 потребує восьми проходів вперед/назад на оновлення оптимізатора; мікропартія 32 займає один. Більше пам’яті графічного процесора дозволяє нам спробувати ці більші мікропартії. Лише заповнення пам’яті не є метою продуктивності, і 3,82 ГіБ, використані нашим початковим запуском, не вимірюють використання обчислювальної системи.
Це відповідає на два різні питання продуктивності: як швидко кожна машина виконує наш фіксований рецепт навчання та як змінюється пропускна здатність, коли ми надаємо графічному процесору більше роботи за прохід. Маленька модель може залишити потужний графічний процесор у очікуванні роботи хоста або невеликих операцій, тому її прискорення не повинно нагадувати співвідношення рекламованих обчислювальних цифр. Гіпотеза для цієї розгортки полягала в тому, що розрив зростатиме разом із розміром мікропартії; наведені нижче результати показують, наскільки це змінилося.
Оскільки обчислення графічного процесора стають швидшими, диспетчеризація центрального процесора, переміщення даних і синхронізація можуть стати більшою частиною минулого часу. Основний навчальний цикл зчитує перевірку кінцевих втрат і скалярні втрати в Python після кожної мікропакети. Такі зчитування вводять синхронізацію; PyTorch рекомендує мінімізувати їх. Розгортка пропускає цю діагностику для кожної мікропартії, тому порівнюйте налаштування розгортки один з одним, а не розглядайте їх час як повторення повного тренувального циклу. Профайлер все ще потрібен, щоб визначити, які витрати домінують.
Висновок потребує іншого контролю. Скопіюйте однаковий збережений адаптер на обидві машини, перш ніж визначати час. В іншому випадку різні навчені ваги можуть генерувати різні відповіді, що ускладнить інтерпретацію порівняння затримки. Програма виводу записує хеші адаптера та підказок, кількість згенерованих маркерів, середню затримку запиту та сукупні вихідні маркери за секунду при розмірі партії 1.
Це вимірювання всієї машини. Продуктивність процесора, обмеження потужності графічного процесора, годинник, диспетчеризація бібліотеки та конкуруючі завдання можуть впливати на результат. Зміна апаратного забезпечення має головним чином змінити час, хоча відмінності в числах з плаваючою комою означають, що навчені ваги та жадібні виходи не обов’язково повинні бути ідентичними.
Що показала розгортка Quadro
Завершене повторення містило 32 приклади на оновлення оптимізатора та вимірювало три випробування для кожного налаштування. Не було пропущено жодного оновлення оптимізатора:
| Мікросерія | Етапи накопичення | Медіана вхідних токенів/с | Швидкість відносно мікропартії 4 | Пікова виділена пам’ять |
|---|---|---|---|---|
| 4 | 8 | 2,794 | 1.00× | 3,82 ГіБ |
| 8 | 4 | 4,123 | 1.48× | 6,69 ГіБ |
| 16 | 2 | 4,425 | 1.58× | 12,29 ГіБ |
Збільшення мікропартії допомогло, але пропускна здатність почала зменшуватися. Подвоєння його з 8 до 16 збільшило пропускну здатність лише на 7,3%, тоді як максимальний обсяг виділеної пам’яті зріс з 6,69 до 12,29 ГіБ. Більше зайнятої пам’яті не призвело до пропорційного прискорення. Це вимірює весь цикл і не визначає, чи обчислення, трафік пам’яті чи накладні витрати хоста встановлюють ліміт, що залишився.
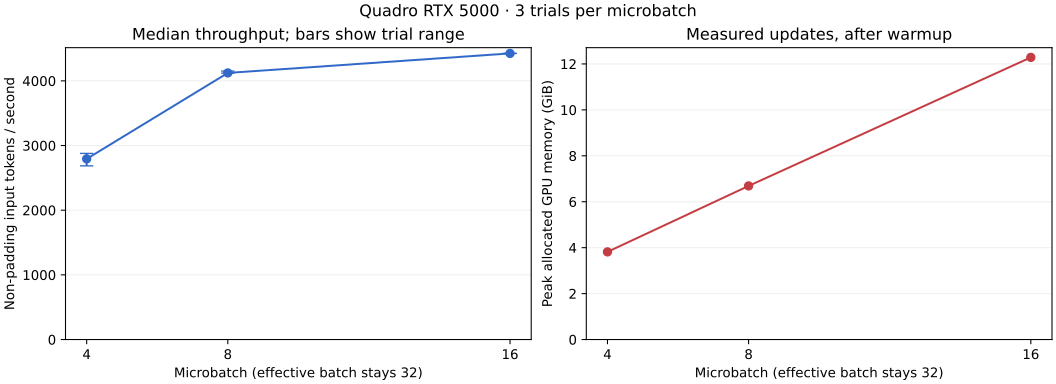
Перша спроба виявила проблему вимірювання: заявлене обмеження потужності Quadro змінилося з 50 Вт до 110 Вт під час розгортки, а його годинники різко зросли. Зареєстровані показники Microbatch 16 коливалися приблизно від 917 до 4734 токенів/с. Після цього Microbatch 32 зайняв майже всю відеопам’ять пристрою, про яку повідомлялося, і завершив одне повільне випробування приблизно з 626 токенами/с; ми перервали решту випробувань. Не було записаного винятку браку пам’яті. Ми зберігаємо цю спробу як перервану діагностику, а не порівняння розміру партії.
У таблиці використовується нова розгортка 4, 8 і 16 після цього переходу. Вибірка звітів про обмеження потужності GPU становила 110 Вт під час повторення; енергоспоживання та тактові частоти все ще змінюються. Необроблені терміни випробування та розподіл пам’яті наведені в results/sweep-quadro.json, а спроба діагностики та телеметрія збережені в experiment/artifacts/. Ці хронометражі розгортки не повинні замінювати попередні хронометражі повного тренування.
Як Blackwell масштабувався за допомогою розміру мікропартії
Повернена розгортка Blackwell відповідає версії моделі Quadro, набору даних, хешу коду, конфігурації, версіям пакетів, блокуванню середовища, розігріву, виміряним оновленням і кількості повторень. Кожне вимірюване випробування обробляло однакові 42 630 вхідних маркерів без доповнення. Усі дванадцять випробувань Blackwell завершилися без жодного пропущеного оновлення оптимізатора, зареєстрованого в їх виміряних інтервалах.
| Мікросерія | Вхідні токени Quadro/с | Токени введення Blackwell/s | Прискорення Blackwell на тій же мікросерії | Пікова виділена пам’ять |
|---|---|---|---|---|
| 4 | 2,794 | 11,478 | 4.11× | 3,82 ГіБ на кожному |
| 8 | 4,123 | 19,133 | 4.64× | 6,69 ГіБ на кожному |
| 16 | 4,425 | 21,619 | 4.89× | 12,29 ГіБ на кожному |
| 32 | Немає завершених результатів трьох спроб | 25,116 | — | 23,60 ГіБ на Blackwell |
Пропускна здатність Blackwell зросла на 2,19× між мікропартіями 4 і 32. При спільних налаштуваннях 4 і 16 вона покращилася на 1,88× порівняно з 1,58× на Quadro. Його перевага в тій самій мікропартії зросла з 4,11× до 4,89×. Більші партії більше допомогли Blackwell, і його перевага за відповідних налаштувань зросла приблизно на 19%.
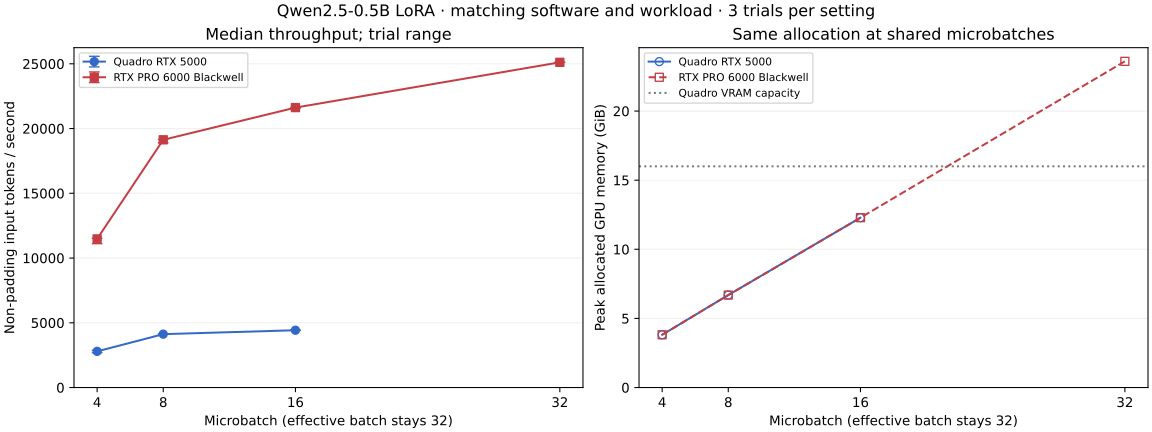
Вимірювання пам’яті робить відмінність ємності конкретним. Обидва GPU виділяли однакову максимальну кількість байтів для кожного спільного налаштування. Додаткова пам’ять Blackwell дала нам можливість завершити мікропакет 32, чий обсяг виділених 23,60 ГБ перевищує приблизно 16 ГБ відеопам’яті Quadro. Порівнюючи найкращі налаштування, Blackwell на 32 був 5,68× швидшим, ніж Quadro на 16; це порівняння з використанням різних мікропартій, окремо від співвідношень схоплювання в таблиці.
Ці результати показують масштабування розміру партії, а не розбивку залишкових витрат. Вони не доводять, що диспетчеризація чи синхронізація центрального процесора домінують, або що GPU досяг максимальної пропускної здатності. Для цієї діагностики потрібен профайлер. Хости все ще відрізняються процесором, драйвером і бюджетом потужності: Quadro використовувало шість потоків процесора PyTorch, Blackwell використовував двадцять, а Blackwell повідомив про обмеження потужності в 600 Вт. Випробування проводили лише десять оновлень оптимізатора після трьох оновлень прогріву; повторні сеанси допоможуть оцінити довгострокову мінливість.
Повні вимірювання Блеквелла зберігаються в results/sweep-blackwell.json, а коефіцієнти узгоджених налаштувань — у results/sweep-comparison.json. Навчальний блокнот і його результати з фіксованими рецептами залишаються окремо від цього експерименту з пропускною здатністю.
Навчіть меншу модель вихідного формату
Достовірність Qwen у форматі JSON уже досягла максимального рівня наших виміряних запитів. Його модельна картка особливо підкреслює структурований вивід і можливості JSON. Покращення вилучення є корисним, але модель, яка вже дотримується формату, не може показати нам значного покращення цього показника.
Для другого експерименту ми використовуємо SmolLM2-135M-Instruct. Дослідницьке дослідження перших 20 запитів перевірки не дало дійсних відповідей JSON. Дев’ять поколінь досягли ліміту в 96 токенів; одинадцять, які закінчили, також були недійсними як повні відповіді JSON. Модель часто повторювала повідомлення клієнта або загортала відповідь у прозі та Markdown. Ми зберегли цей зонд у results/smollm2-135m-probe.json і залишили остаточний тестовий набір недоторканим до повного експерименту.
Окремий бігун використовує закріплену версію моделі та ті самі 2000 тренувань, 200 перевірок і 300 тестових прикладів, що й Qwen. У ньому повторно використовується навчання та підрахунок балів LoRA з двома епохами та 8 рангом у прогнозах запиту та значення. Для цієї моделі можна навчити 460 800 параметрів адаптера. Запустіть його локально за допомогою:
uv run --locked python formatting/run.pyПовний запуск дав нам такий результат до і після тих самих 300 відкладених запитів:
| Перевірте | Перед тонким налаштуванням | Після тонкого налаштування |
|---|---|---|
| Дійсний JSON | 0/300 (0%) | 300/300 (100%) |
| Правильна схема | 0/300 (0%) | 300/300 (100%) |
| Усі значення правильні | 0/300 (0%) | 207/300 (69%) |
| Відповіді досягли ліміту маркерів | 179/300 | 0/300 |
Ці помилки форматування стосуються повної відповіді. Вони включають пояснення, паркани Markdown, повторювані відповіді та неповні покоління; вони не означають, що кожна відповідь мала неправильну кому. Навіть 121 базова відповідь, яка завершилася до обмеження маркерів, не пройшла звичайний аналіз JSON. Після навчання кожна тестова відповідь була повним об’єктом JSON із необхідною схемою.
Ось один запит, значення та формат виводу якого покращено:
Комплектація: 3 монітори. Посилання на замовлення: замовлення 24179. Що потрібно: трек.
You need to track a specific order. The order reference is "order 24179", and the order ID is 3.{"action": "track", "order_id": 24179, "product": "monitor", "quantity": 3}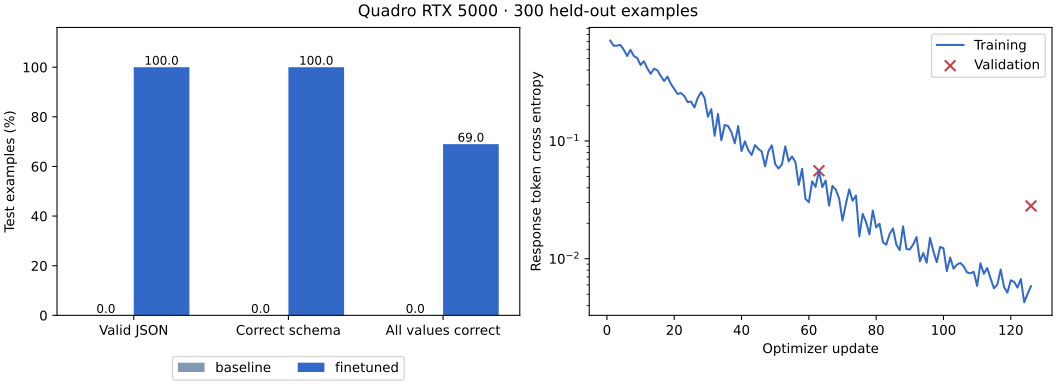
Попередній перегляд у реальному часі показує різницю в ході навчання. Зразок в оновленні 10 все ще містив прозу та Markdown. Під час оновлення 20 зразок пройшов перевірку JSON і схеми, але використовував номер замовлення як кількість. Під час оновлення 50 зразок відповідав кожному полю. Це різні запити перевірки, тому остаточні результати тесту забезпечують сукупне порівняння.
Навчання зайняло 290,26 секунди для 126 оновлень без жодного пропущеного оновлення. Тринадцять попередніх переглядів додали 44,00 секунди, а максимальний обсяг виділеної пам’яті GPU становив 1,47 ГіБ. Необроблені прогнози, конфігурація, втрати, попередній перегляд і перегляд моделі зберігаються в results/smollm2-formatting.json; навчений адаптер залишається в каталозі артефактів циклу форматування.
Помилки, що залишилися, включають копіювання ідентифікатора замовлення в кількість, придумування відсутнього ідентифікатора та зміну назв продуктів у цитатах. Один шаблон формулювання «Є…; чи може хтось…?», містить 51 помилку серед 70 запитів. Форматування тепер надійне на цих прикладах, тоді як наддобування значень ще потребує роботи. Розмір, архітектура та попереднє навчання відрізняються від Qwen, тому це не визначає кількість параметрів як причину. Ми підтримуємо робоче навантаження на апаратне забезпечення Qwen фіксованим і звітуємо про SmolLM2 як окремий експеримент форматування.
Запустіть те саме завдання через Tinker
Tinker дозволяє нам писати цикл підготовки даних і навчання локально, тоді як керована служба виконує навчальні обчислення. Ми надсилаємо послідовності токенів і дані про втрати через SDK, а потім запитуємо зразки з отриманої контрольної точки.
Його поточний каталог моделей не містить Qwen2.5-0.5B-Instruct. Таким чином, наш шлях Tinker за замовчуванням становить Qwen3.5-4B, а мислення вимкнено. Набір даних і перевірки якості залишаються незмінними. Розмір моделі, схема адаптера, точність та інфраструктура відрізняються, тому ми повідомляємо це як окреме порівняння робочого процесу, а не як третє вимірювання швидкості GPU.
Установіть додатковий SDK, пройдіть автентифікацію та перевірте доступні моделі:
uvx --from tinker==0.33.1 tinker auth login
uv run --script run_tinker.py --list-models
uv run --script run_tinker.py --dry-run --smoke
Tinker використовує власний сценарій run_tinker.py і клієнтське середовище, не завантажуючи двигун CUDA або Marimo. Сухий запуск перевіряє вибраний токенізер, маски, довжину послідовності та об’єкти даних SDK без виклику служби Tinker. Для тренування біжіть:
uv run --script run_tinker.py --smoke
uv run --script run_tinker.py
Ці навчальні команди використовують ваш обліковий запис служби для навчання та вибірки. Зберігайте облікові дані в сховищі входу Tinker або в змінній середовища TINKER_API_KEY.
Втрати перехресної ентропії SDK підсумовує зважені втрати токенів. Наш бігун призначає нульову вагу маркерам підказок і нормалізує ваги відповідей для повної партії. На відміну від локального виклику Hugging Face, об’єкти даних Tinker отримують явно зміщені вхідні та цільові послідовності.
Результати Tinker включають базові та адаптовані показники якості, втрати, час роботи клієнта та шляхи контрольних точок. Очікування кожної операції включає мережу та чергування в цей час. Фактичні збори за обслуговування належать до цих спостережень, якщо вони доступні в режимі виставлення рахунків. Вони не можуть бути виведені зі ставки оренди GPU.
Що можна дізнатися з результатів
Прочитайте валідність, відповідність схем і точну точність разом. Якщо валідність JSON уже висока, навчання може покращити узгодженість полів і значень. Якщо втрата тренування зменшується, коли точність утримується, перевірте невдачі, перш ніж додавати нові епохи.
Подивіться окремо на відсутні ідентифікатори замовлень, продукти у множині та назви, що містять слова в лапках. Ці приклади виявляють різні помилки: винайдення ідентифікатора, нездатність нормалізувати продукт або неправильне екранування його назви. Кожен запуск зберігає всі необроблені відповіді, щоб ми могли перевіряти ці шаблони локально.
Точне налаштування під наглядом робить бажану відповідь більш імовірною. Це не гарантує дійсну відповідь на кожен майбутній вхід. Наступним корисним експериментом є обмежене декодування, яке обмежує дозволені лексеми відповідно до граматики чи схеми. Він може застосовувати підтримувані структурні правила, тоді як значення все ще потребують перевірки на відповідність запиту.
Для цього першого експерименту корисним результатом є чітке вимірювання до і після, набір зрозумілих несправностей і відтворюване робоче навантаження, яке ми можемо переміщувати між машинами.
Для порівняння апаратного забезпечення, приблизно в 5 разів швидше на Blackwell є розумним очікуванням для цієї моделі Qwen, налаштування FP16 LoRA та реалізації навчання. Розгортка вимірювалася 4,1–4,9× при відповідних мікропартіях. Порівняння найкращих завершених налаштувань кожної машини дало приблизно 5,7×, з Blackwell на мікропакеті 32 і Quadro на 16. Це результати для всієї машини для цього робочого навантаження. Великі моделі, довші послідовності або різні реалізації можуть створити інший розрив.