Що стиснення зберігає в нейронній мережі
У статті Напрямки, розріджені функції та те, як розріджені автокодери їх знаходять ми дослідили, як кілька напрямків функцій можуть спільно використовувати простір активації та як розрідженість може допомогти нам відновити їхні внески. Тут ми навчимо мережу іншій задачі: прогнозуванню ціни за трьома безперервно змінними атрибутами будинку лише з двома прихованими координатами.
Але впливати на репрезентацію та бути відновленими з неї — це різні речі. Чи можемо ми прочитати всі три атрибути назад? Які відмінності зникають? І чи несе в собі корисну інформацію напрямок із дуже невеликими варіаціями?
Ми заморозимо навчені ваги та дослідимо ці питання за допомогою розкладання сингулярних значень (SVD), лінійних зондів і контрольованих втручань. Ми будемо розрізняти точність передбачення, змінність прихованого простору та відновлення оригінальних функцій. Ми також порівняємо навчені представлення з їх випадковими ініціалізаціями: можливість відновлення після навчання сама по собі не означає, що навчання виявило функцію.
Формула ціни, відповідь на яку ми знаємо
Ми використовуватимемо розмір, кімнати та вік як назви для трьох незалежних синтетичних оцінок функцій:
Кожна оцінка рівномірно відбирається з , що дає середнє значення сукупності нуль і дисперсію один. Це безперервні стандартизовані бали: «кімнати» — це не ціла кількість кімнат, а — це оцінка ціни, а не доларів. Коефіцієнти обрані для експерименту, а не оцінені з ринку житла.
Використання порівнянних масштабів не дозволяє великій фізичній одиниці домінувати над геометрією. Незалежне відбір проб також запобігає відновленню віку зонда лише тому, що старі будинки менші. Реальні дані про житло спричинили б обидві складності.
Модель обчислює:
з матричними формами , і . Наш основний експеримент використовує ; елементи керування використовують і .
Усі шари є лінійними та не мають зміщень. Ціль має нульове перехоплення, тому упередження непотрібні. Ми надаємо вхідні атрибути безпосередньо, але не надаємо моделі жодних міток чи допоміжних втрат, які б повідомляли їй, що мають означати її приховані нейрони. Цей експеримент вивчає вивчені представлення відомих вхідних даних; він не виявляє атрибути будинку з необроблених зображень або тексту.
Під час навчання використовується знайомий цикл: прохід вперед, середня квадратична помилка, зворотне поширення та градієнтний спуск. Ось повне оновлення параметрів із прикладами, збереженими у вигляді рядків:
h1 = X @ W1.T
h2 = h1 @ W2.T
error = h2 @ W3.T - y       # y has shape (N, 1)
delta = 2 * error / len(X)

grad_W3 = delta.T @ h2
grad_W2 = (delta @ W3).T @ h1
grad_W1 = (delta @ W3 @ W2).T @ X

# Compute every gradient before changing any weight.
W1 -= 0.03 * grad_W1
W2 -= 0.03 * grad_W2
W3 -= 0.03 * grad_W3
Ми використовуємо 2048 навчальних прикладів і 4096 затриманих прикладів із фіксованим вихідним кодом даних. Для кожної ширини ми навчаємо п’ять ініціалізацій: початкові числа 7, 11, 23, 42 і 101. Початкові ваги є незалежними нормальними зразками зі стандартним відхиленням 0,4. Навчання припиняється, коли MSE навчання нижче , з максимумом 10 000 оновлень. Кожен запуск збирався в 123–214 оновленнях.
Бази та зонди PCA встановлюються лише на навчальні активації. Повідомлені кореляції, оцінки зондів і помилки передбачення використовують надані приклади. Ці прогони характеризують цю установку; п’ять насіння не є статистичним оглядом усіх можливих варіантів тренувань.
Одного виміру вже достатньо, щоб передбачити ціну
Оскільки шари є лінійними, їх композиція є лінійною:
Ціль залежить лише від однієї скалярної комбінації, . Вузьке місце з одним нейроном може зберегти це число та дозволити останньому шару повернути його. Таким чином, для точного прогнозування ціни не потрібно зберігати три вхідні дані окремо.
Усі 15 навчених мереж досягли утриманої ціни MSE нижче . Це легке, точно репрезентативне завдання; ці крихітні помилки є числовим узгодженням, а не доказом реалістичного прогнозування цін на житло.
Корисне питання полягає в тому, що ще вціліло на шляху до цієї відповіді.
These are trained weights. Move an input, inspect its hidden point, then move along the lost direction.
Axes scale independently to expose the thin second dimension. Displayed angles and aspect ratio are not the hidden space’s geometry. PC variance shares: 99.905% / 0.095%.
n = [-0.2971, 0.7197, 0.6275]. Changing t changes the features, but the hidden point and predicted price stay fixed.
| Feature | Original x | Changed x′ | Probe estimate from h₂ | Test R² |
|---|---|---|---|---|
| Size | 0.4000 | 0.4000 | 0.3677 | 0.914 |
| Rooms | -0.2000 | -0.2000 | -0.1218 | 0.499 |
| Age | 0.3000 | 0.3000 | 0.3682 | 0.615 |
Five runs, the same training and test data. Seed 7: test price MSE 9.87e-21. Feature scores are synthetic, continuous, and standardized; “rooms” is not an integer room count.
Почніть із зміни розміру, залишаючи кімнати та вік фіксованими. Біла точка слідує за лінією у двовимірному вузькому місці. Тепер перемістіть кімнати: інша зміна введення також перемістить ту саму точку. Перемикайте початкові значення та зверніть увагу, що точне передбачення зберігає зміни у внутрішньому представленні.
Три нейрони можуть зберігати три функції, не називаючи їх
У нашому основному циклі, початковому етапі 7, перший прихований шар дізнався приблизно:
Кожен рядок описує один нейрон. Перший нейрон реагує на всі три атрибути; це не виділена координата розміру. Інші ряди теж суміші.
Тим не менш, ця матриця має третій ранг. Його перетворення є оборотним, тому повний прихований вектор містить достатньо інформації для відновлення всіх трьох вхідних даних. Ми перевіряємо це за допомогою окремих лінійних показань, установлених після заморожування мережі.
Перший шар зберіг третє місце в усіх 15 прогонах. Це спостереження, а не те, що вимагає втрата ціни. Випадкові початкові перші шари вже мали повний ранг, тому повна відновлюваність тут не є доказом того, що навчання виявило три концепції. Навчання змінило представлення, яке вже мало достатньо можливостей для збереження вхідних даних.
Для прикладу, коли відомі властивості є комбінаціями необроблених вхідних даних, перегляньте відповідний експеримент щодо яскравості та контрастності в двопіксельному автокодері.
Три напрямки функцій мають два виміри
Об’єднайте перші два шари в . Тоді . Для насіння 7:
Три стовпці описують, як зміна кожного входу змінює прихований вектор:
Прихований вектор є сумою їхніх внесків:
Усі три стовпці ненульові: усі три ознаки впливають на представлення. Мережа представляє три вхідні елементи за допомогою напрямків у двовимірному просторі. Кожна функція може впливати на представлення, але їх ефекти не можна розрізняти окремо.
Ось що означає спільний репрезентативний простір у нашому експерименті. Три стрілки функцій не обов’язково вказують в одному напрямку. Але всі вони не можуть бути лінійно незалежними: принаймні один є комбінацією інших. Таким чином, зміна в одній функції може бути скасована змінами в інших функціях, залишаючи той самий прихований вектор. Спостереження за ефектом кожної функції не означає, що ми можемо прочитати кожну функцію назад.
Ми зробимо цю неоднозначність конкретною, знайшовши комбінацію вхідних змін, які втрачає вузьке місце.
Оскільки має другий ранг, існує ненульовий напрямок введення з . SVD карти ваги знаходить це:
_, _, Vt = np.linalg.svd(B, full_matrices=True)
n = Vt[-1]  # Third right singular vector, in the 3D INPUT space.
Тут має значення full_matrices=True: зменшений SVD цієї матриці повертає лише два праві сингулярні вектори та пропускає нульовий напрямок. Ознаки СВД довільні; ми вибираємо знак, який робить запис найбільшої величини позитивним.
Наш втрачений напрямок приблизно такий:
Тепер порівняйте два входи і :
Мережа не може відрізнити трохи менший будинок з більшою кількістю кімнат і більшим віком від оригіналу, коли ці зміни відповідають цим пропорціям. Для внутрішніх точок невеликі зміни вздовж залишаються всередині нашої вибіркової вхідної області, тому це справжня неоднозначність в експерименті.
Перемістіть повзунок втраченого напрямку віджета. Вхідні атрибути змінюються, а прихована точка та передбачення залишаються фіксованими. Справжня ціна також залишається фіксованою з точністю навчання: вивчений нульовий напрям майже перпендикулярний .
Жоден декодер, лінійний чи нелінійний, не може відновити кожен початковий вхідний сигнал з ідентичних прихованих векторів. Інформація була відкинута. SVD не може його відновити.
SVD активацій відповідає на інше запитання
Тепер зберіть активації вузьких місць для навчальних прикладів у . Відцентруйте їх і обчисліть:
Цього разу праві сингулярні вектори живуть у двовимірному прихованому просторі. Вони дають напрямки головних компонентів: перпендикулярні осі, впорядковані дисперсією активації вздовж них.
mean = H_train.mean(axis=0)
_, singular_values, Vt = np.linalg.svd(H_train - mean, full_matrices=False)
scores_test = (H_test - mean) @ Vt.T
variance_share = singular_values**2 / np.sum(singular_values**2)
Документація NumPy SVD описує повернуті множники. Для цих дійсних матриць рядки Vt є осями, на які ми проектуємо.
У вихідному коді 7 сингулярні значення вузького місця становлять приблизно 79,249 і 2,446. ПК 1 становить 99,905% дисперсії активації навчання; ПК 2 становить 0,095%. Хмара - це майже лінія, але її другий вимір не дорівнює нулю.
Ми знаємо позначки функцій, тож можемо виміряти кореляцію між утримуваними балами PCA та кожною функцією:
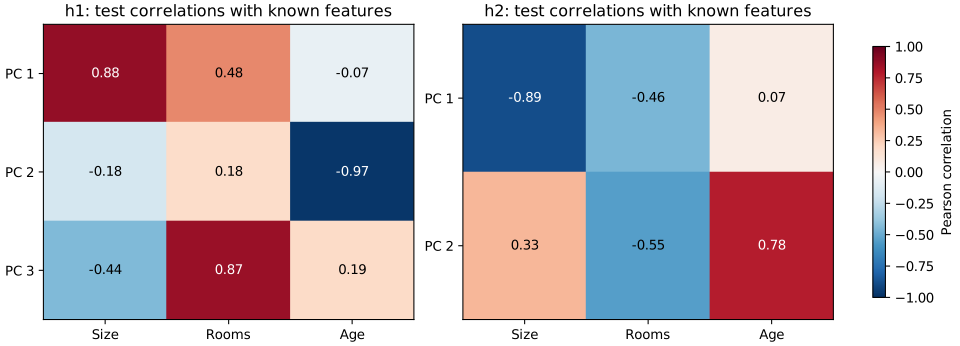
Для вузького місця:
| компонент | Співвідношення розмірів | Співвідношення кімнат | Вікове співвідношення |
|---|---|---|---|
| ПК 1 | −0.890 | −0.457 | 0.072 |
| ПК 2 | 0.334 | −0.547 | 0.783 |
Перший компонент тісно пов’язаний з розміром, але також і з кімнатами. Другий сильно пов’язаний з віком, але все одно є сумішшю. СВД постачає статистичні осі; мітки дозволяють нам досліджувати їх значення пізніше.
Зверніть увагу, скільки вікових асоціацій міститься в компоненті, що пояснює менше однієї десятої відсотка прихованої дисперсії. Правило, яке зберігає лише достатню кількість компонентів, щоб пояснити 99% дисперсії, відмінить його. Невелика дисперсія не означає нерелевантну інформацію, хоча малий сигнал може бути менш стійким до шуму. Наші поточні вимірювання не мають додаткового шуму активації.
Зонд вимірює те, що може відновити все представлення
Співвідношення однієї координати PCA з віком запитує лише про цю координату. Щоб використати всі доступні координати, підберіть окрему лінійну регресію від заморожених активацій назад до вхідних даних:
Це зонд лінійної регресії. Мережа залишається замороженою; позначки функцій контролюють лише діагностичне зчитування. Робота Алена та Бенджіо над зондами лінійного класифікатора використовує те саме поділ між навченим представленням і незалежно навченими діагностичними класифікаторами. Тут наші цілі безперервні.
design = np.column_stack((H_train, np.ones(len(H_train))))
probe = np.linalg.lstsq(design, X_train, rcond=None)[0]
recovered = np.column_stack((H_test, np.ones(len(H_test)))) @ probe
Ми повідомляємо про відкладений : 1 означає точне відновлення; 0 відповідає похибці прогнозування середнього значення ознаки утримання. Оцінки можуть бути негативними. Це прогнозні оцінки, а не відсотки інформації чи доказ того, що оригінальна модель використовує функцію певним чином.
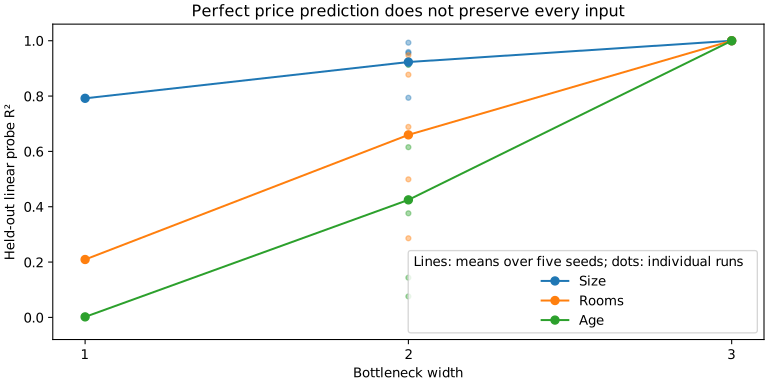
| Ширина горлечка, насіння 7 | Розмір R² | Кімнати R² | Вік R² | Ціна R² |
|---|---|---|---|---|
| 1 | 0.792 | 0.209 | 0.002 | ≈1 |
| 2 | 0.914 | 0.499 | 0.615 | ≈1 |
| 3 | 1.000 | 1.000 | 1.000 | ≈1 |
Представлення двох нейронів частково передбачає всі три функції, не відновлюючи жодної точно. Змішування дозволяє кожній функції впливати на представлення, але залишає неоднозначність щодо їхніх окремих значень.
У п’яти прогонах із двома нейронами вік R² коливається від 0,076 до 0,913, незважаючи на однаково точні прогнози ціни. Додатковий напрямок, що зберігається поза ціною, залежить від ініціалізації та навчання; ціль не вказує однозначно.
Також є точна перевірка населення. Наші вхідні дані мають коваріацію , тому оптимальною лінійною реконструкцією з є його проекція на простір рядків . Якщо , де — псевдоінверсія, тоді:
Це популяційні оптимальні лінійні результати. Кінцеві оцінки навчання та тестування, наведені вище, не обов’язково точно підсумовуються званням. Ця ідентичність є специфічною для наших ізотропних вхідних даних і цього лінійного критерію відновлення; це не загальний закон для нейронних уявлень.
Змініть геометрію без зміни прогнозів
Втрата ціни однозначно не визначає приховані координати. Візьміть будь-яку оборотну матрицю і замініть:
Тоді для кожного входу. Обернена зміна зберігає інформацію, доступну для переобладнаного лінійного датчика, але неортогональна зміна може змінити кути, довжини та частку дисперсії PCA.
Експеримент застосовується:
Для початкового числа 7 частка дисперсії першого компонента змінюється приблизно з 99,905% до 99,980%. Прогнози та зонд R² залишаються незмінними в межах числового допуску. Перемикач Змінити приховану основу; зберегти прогнози, щоб перевірити це перетворення. Він повторно виражає заморожену мережу; це не перенавчає його.
Це прямо доводить неунікальність. Окремі тренувальні прогони не обов’язково пов’язуються цим точним перетворенням: вони також можуть зберігати різні вхідні підпростори, як демонструють наші різноманітні оцінки зондів.
Змініть прихований напрямок і перевірте його ефект
Оскільки ми контролюємо вхідні дані, ми можемо визначити точне приховане втручання, яке відповідає збільшенню однієї функції. Тримаючи початковий вхід фіксованим, додайте до його активації вузького місця:
Сценарій перевіряє ці втручання на представлених прикладах. Для додавання напрямку розміру змінює прогнозовану ціну на 0,50; напрямок кімнат змінює його на 0,25; віковий напрямок змінює його на −0,05.
Це інструкції з написання: вони описують, як зміна введення потрапляє в прихований простір. Зонд — це напрямок читання: він намагається вивести вхідне значення з активації. Вони не повинні збігатися. Тут не може бути ідеальних незалежних зчитувань для всіх трьох функцій, оскільки їхні напрямки написання залежать.
Втручання перевіряє механізм для скалярного виходу цієї моделі. Це не встановлює, що прихована вісь представляє таке абстрактне поняття, як «бажаність». Нам знадобиться визначення та незалежні вимірювання, щоб перевірити цю інтерпретацію.
Це суперпозиція?
У дослідженні інтерпретабельності суперпозиція означає представлення більшої кількості ознак, ніж є вимірів, використовуючи напрямки ознак, що перекриваються. Іграшкові моделі суперпозиції досліджує це за допомогою розріджених вхідних функцій і невеликих мереж ReLU, зокрема те, як нелінійна фільтрація справляється з перешкодами.
Наш експеримент має пов’язану геометрію: три компоненти функції мають два прихованих виміри, і зміни в цих компонентах можуть скасовувати одна одну. Але ціль навчання винагороджує лише збереження однієї цінової комбінації. Це не дає моделі жодних зобов’язань зберігати розмір, кімнати та вік окремо для відновлення. Таким чином, точне прогнозування ціни не встановлює, що мережа навчилася зберігати три різні, незалежно корисні функції в суперпозиції.
Цей експеримент ілюструє перекривання напрямків функцій, що лежать в основі суперпозиції. Однак, оскільки навчання винагороджує лише передбачення ціни, це не означає, що мережа навчилася зберігати всі три функції як окремо відновлені кількості.
Саме по собі недосконале відновлення не виключає суперпозиції: її частиною можуть бути помилки інтерференції та реконструкції. Також визначення не вимагає ReLU. Обмеження наших доказів полягає в тому, що ми не тестували ціль, яка винагороджує збереження індивідуальних рис.
Більш сильний контроль навчив би вузьке місце з двома нейронами реконструювати всі три входи, запровадити розріджену активність функцій, щоб функції часто були нульовими, і порівняти лінійні та нелінійні декодери. Тоді ми могли б виміряти, які функції можна відновити, і як часто їх накладення викликає помилки. Збереження кількох функцій стане чимось, що явно винагороджується під час навчання, дозволяючи нам досліджувати, чи спільний доступ до розмірів допомагає цьому завданню.
Що це говорить нам про векторні простори LLM
Ця крихітна мережа дає нам контрольований спосіб розрізняти координати, напрямки об’єктів, статистичні компоненти та інформацію, втрачену через стиснення. Ці відмінності корисні при підході до більших моделей: корельована активація не є автоматично унікальною концепцією, а успішне передбачення не визначає однозначно внутрішнє представлення.
Він не встановлює, як конкретна мовна модель представляє поняття. Наші вхідні дані мають відомі значення, перетворення глобально лінійні, і ми можемо створити відповідні приклади, змінивши одну змінну. Аналіз мовної моделі повинен встановити, яке з цих припущень, якщо такі є, є розумним для подання, що вивчається.
Ще один подальший крок додав би нелінійну цільову ціну, наприклад бонус, коли розмір і кімнати перевищують порогові значення, і порівняв лінійну модель із мережею ReLU. Це перевірило б, чи нелінійні проміжні обчислення покращують прогноз. Просте вставлення ReLU зі збереженням цієї лінійної цілі не вимагатиме від мережі виявлення корисних нелінійних функцій.
Відтворюйте та перевіряйте кожне вимірювання
Завантажте експеримент NumPy і повні результати вимірювань. JSON включає всі 15 прогонів, ваги, сингулярні значення, зонди, кореляції, нульові напрямки та історію навчання. Віджет оцінює ці заморожені ваги в браузері.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install numpy==2.2.6
python house_representation_experiment.py
У сховищі каталог directions-sparse-features-and-how-sparse-autoencoders-find-them/experiment/ першої статті також містить README та закріплені прямі залежності для регенерації двох фігур SVG. Запустіть там python experiment.py --export --figures після встановлення requirements.txt. Згенеровані шляхи відносяться до розташування сценарію, а не до робочого каталогу; використовувати макет сховища під час регенерації ресурсів статті.
Сценарій перевіряє зворотне розповсюдження на кінцеві різниці, перевіряє вивчену наскрізну формулу, вимірює зонди на утримуваних даних і перевіряє інваріантність нульового простору, приховані втручання та інваріантність прогнозу за зміненого базису. Знаки SVD і результати останньої цифри з плаваючою комою можуть відрізнятися в різних бібліотеках чисел.
Результатом є конкретна відповідь на наше початкове запитання. Ми можемо відобразити вивчені суміші назад до відомих функцій, якщо ці функції залишаються відновленими. SVD допомагає виявити, як змінюється представлення; мітки та контрольовані зміни говорять нам, чому ці варіації відповідають. Також не можна відновити відмінності, стерті мережею.